【01|技术背景】
检索增强生成(Retrieval-Augmented Generation,RAG)技术通过结合信息检索和生成式AI的优势,有效解决了大语言模型在专业领域知识滞后和幻觉问题。本项目基于RAG技术构建了一个专业的刑法问答机器人,为法律智能问答提供了可复现的技术方案。
【02|系统架构】
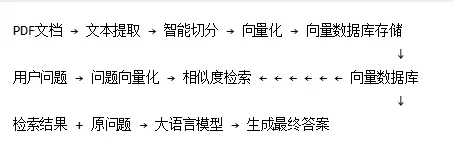
核心两阶段架构:
- • 检索阶段:将用户查询向量化,在知识库中搜索最相关的文档片段
- • 生成阶段:将检索结果作为上下文,指导大语言模型生成专业回答
完整技术流程:
【03|关键技术实现】
# 配置核心参数PDF_PATH = "data/rag/刑法.pdf"EMBEDDING_MODEL = "qwen3-embedding:latest"# 文档加载与智能切分loader = PDFPlumberLoader(PDF_PATH)raw_documents = loader.load()text_splitter = RecursiveCharacterTextSplitter( chunk_size=200, chunk_overlap=50, # 重叠切分防止信息丢失 separators=["\n\n", "\n", "。", ";", " ", ""])all_splits = text_splitter.split_documents(raw_documents)
# 创建向量数据库vectorstore = Chroma.from_documents( documents=all_splits, embedding=embeddings, collection_name="criminal_law_study")# 定义检索器(返回最相关的3条记录)retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
# 检索相关上下文context_docs = retriever.invoke(query)context_text = "\n\n".join([f"【资料{i+1}】: {d.page_content}"for i, d inenumerate(context_docs)])# 构造专业Promptprompt = f"""你是一个法律助手。请基于以下参考资料回答问题。参考资料:{context_text}用户问题:{query}要求:引用法条原文,逻辑严谨。如果资料中没提到,请直说。回答:"""# 生成最终答案response = llm.invoke(prompt)
【04|运行效果】
文档处理结果:
- • 示例片段:"中华人民共和国刑法(1979年7月1日第五届全国人民代表大会第二次会议通过......"
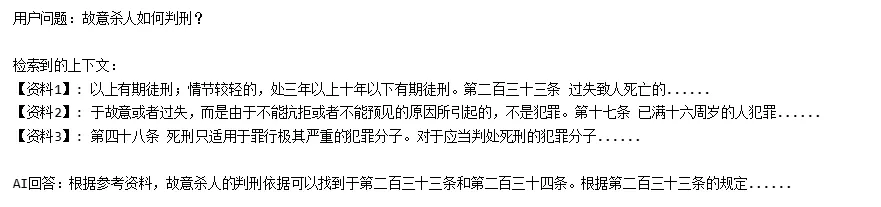
问答测试示例:
【05|技术特点】
1.重叠切分策略:采用50字符的重叠窗口,确保关键信息不被切分破坏2.语义向量检索:基于预训练embedding模型,实现深度语义匹配3.上下文增强生成:检索结果作为证据支撑,提高回答准确性和可信度4.模块化设计:各组件独立可配置,便于扩展和优化
【06|应用价值】
本系统为专业领域的智能问答提供了完整的技术框架,可快速适配到:
技术说明: 本项目基于LangChain框架实现,使用Ollama本地embedding模型,支持快速部署和二次开发。
欢迎评论交流RAG技术实现细节与应用场景!
代码领取
转发本推文到朋友圈
添加客服
发送代码编号
发送保留2小时并集齐10个点赞的截图
即可免费领取代码