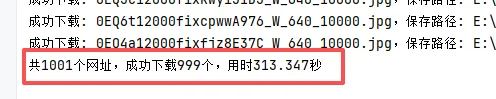
import requestsfrom pathlib import Pathimport pandas as pdimport timedef download_single_image(image_url, save_folder): try: headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36"} response = requests.get(image_url, headers=headers, timeout=timeout, stream=True) response.raise_for_status() # 检查请求是否成功 file_name = image_url.split("/")[-1].split("?")[0] # 图片文件名 file_path = save_folder / file_name # 路径 with open(file_path, "wb") as f: for chunk in response.iter_content(chunk_size=8192): # 分块写入,8192个字节为8KB f.write(chunk) print(f"成功下载: {file_name},保存路径: {save_folder}") return True except requests.exceptions.RequestException as e: print(f"下载失败 {image_url}: {str(e)}") return False except Exception as e: print(f"未知错误 {image_url}: {str(e)}") return Falses_t = time.time()jiange = 0.2timeout = 5 # 请求超时设置count_url = 0 # 网址数量count_pic = 0 # 下载数量xlsx_path = Path(r"E:\大众携程数据汇总(信息在前).xlsx")df = pd.read_excel(xlsx_path)df = df.dropna(subset=['img'])df_group = df.groupby(by="景点id")for name, group in df_group: folder_path = xlsx_path.parent / str(name) # 构建路径 folder_path.mkdir(parents=True, exist_ok=True) # 新建文件夹 for values in group['img']: lists = values.split("\n") for list in lists: if str(list).startswith("http"): # 过滤非网址 count_url += 1 if download_single_image(list, folder_path): count_pic += 1 time.sleep(jiange)print(f"共{count_url}个网址,成功下载{count_pic}个,用时{time.time() - s_t:.3f}秒")