Pandas是一个基于Python构建的开源数据分析库,它提供了强大的数据结构和运算功能。Pandas起源
Pandas诞生于2008年,它的开发者是Wes McKinney,一个量化金融分析工程师。因为疲于应付繁杂的财务数据,Wes McKinney便自学Python,并开发了Pandas。
Pandas“Python data analysis”的简写,同时也衍生自计量经济学术语“panel data”(面板数据)。
Pandas的诞生是为了分析金融财务数据,当然现在它已经应用在各个领域了。
它可以帮助你任意探索数据,对数据进行读取、导入、导出、连接、合并、分组、插入、拆分、透视、索引、切分、转换等,以及可视化展示、复杂统计、数据库交互、web爬取等。
同时Pandas还可以使用复杂的自定义函数处理数据,并与numpy、matplotlib、sklearn、pyspark、sklearn等众多科学计算库交互。
- 掌握pandas中series与dataframe
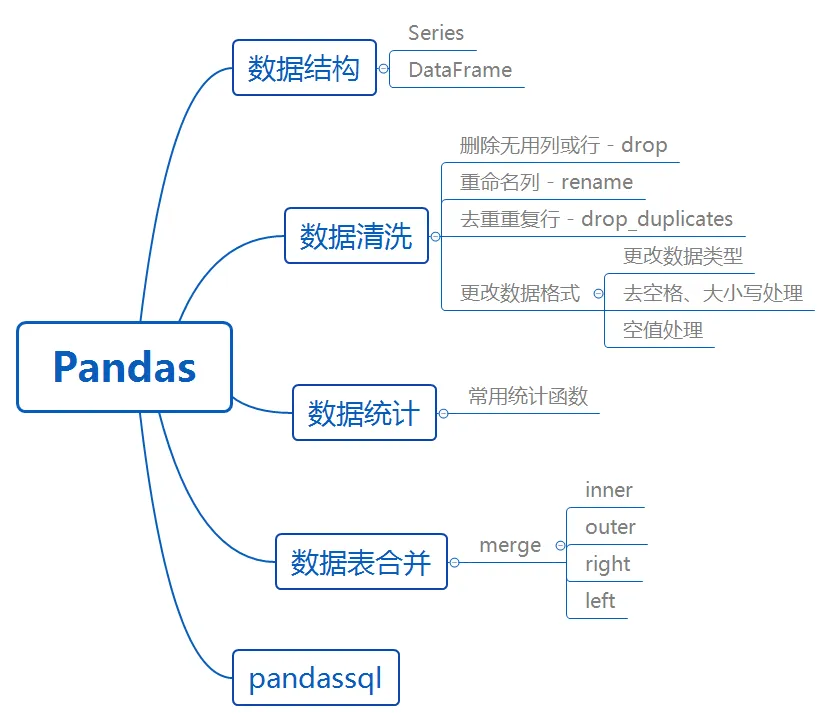
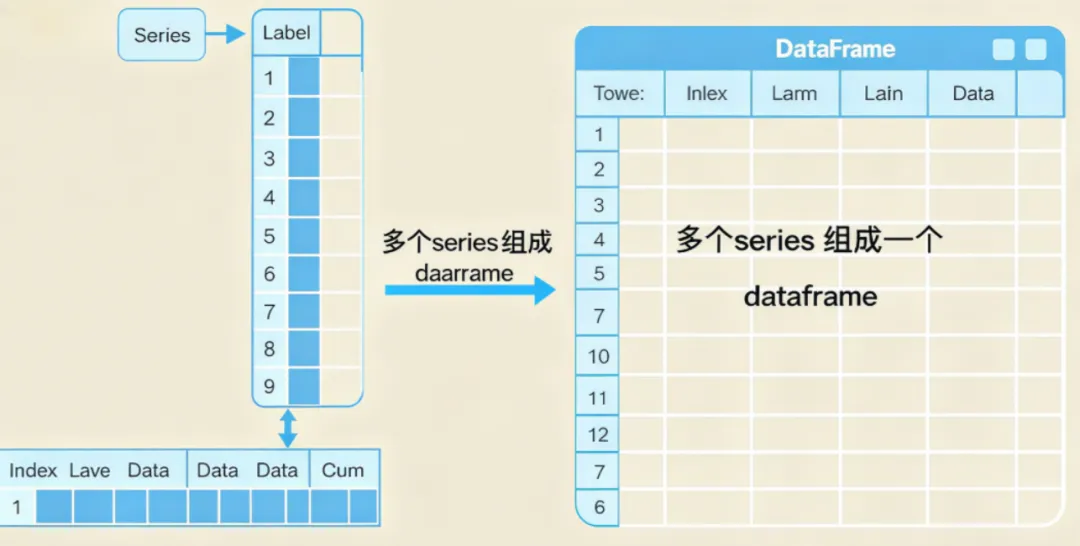
Pandas的两大核心:Series和DataFrame
想要熟练使用pandas,就必须要了解它的核心概念组成,其中Series和DataFrame就是最根本的数据结构核心
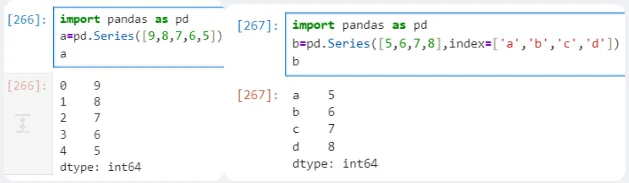
import pandas as pda=pd.Series([9,8,7,6,5])a
import pandas as pdb=pd.Series([5,6,7,8],index=['a','b','c','d'])b
可以发现当Series()内只有一维的时候索引下标默认是从0开始依次递增的,当有两维时列表的第二维表示的是对应的索引(‘index=’可以省略),另它的数据类型依然沿用NumPy中的数据类型。
当我们试图将某一个列表中的数据删除或添加就会出错(index和列表元素必须一样长),事实上在实际处理数据中缺少对应或对应缺失经常会发生,这里我们再说一下其他几种创建方式:由标量值创建(只能有一个),index来表示Series的尺寸。
import pandas as pdb=pd.Series(5,['a','b','c','d']) #注意这里是一个标量值并非列表(没有括号)b
由Python字典进行创建(别忘了是大括号),需要注意当后面没有指定index时索引下标按字典进行,如果有index列表则索引以index列表为准,此时会依照索引查看字典所对应的索引是否有数据,将属于和索引进行对应没有则为空。
d=pd.Series({'a':9,'b':8,'c':7}) #注意这里一定要有大括号de=pd.Series({'a':9,'b':8,'c':7},['c','b','a','d']) e
索引和数据都通过ndarray类型创建:
f=pd.Series(np.arange(5),index=np.arange(9,4,-1))f
2.DataFrame类型
DataFrame类型的创建
二维的ndarray创建:
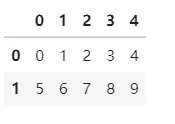
import pandas as pdimport numpy as npd=pd.DataFrame(np.arange(10).reshape(2,5))d
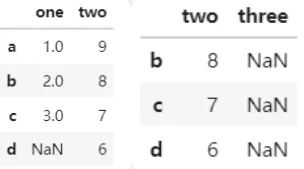
import pandas as pddt={'one':pd.Series([1,2,3],index=['a','b','c']), 'two':pd.Series([9,8,7,6],index=['a','b','c','d'])}d=pd.DataFrame(dt)dpd.DataFrame(dt,index=['b','c','d'],columns=['two','three'])
我们发现我们采用three列索引,但这一列并没有值,数据根据行列索引自动补齐。
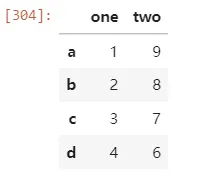
当我们index索引完全相同时,字典的索引创建就可以进行简化:
import pandas as pd dl={'one':[1,2,3,4],'two':[9,8,7,6]}d=pd.DataFrame(dl,index=['a','b','c','d'])d
一、生成数据表
1、首先导入pandas库
2、导入CSV或者xlsx文件
df = pd.DataFrame(pd.read_csv('name.csv',header=1))df = pd.DataFrame(pd.read_excel('name.xlsx'))
3、创建数据表
df = pd.DataFrame({"id":[1001,1002,1003,1004,1005,1006], "date":pd.date_range('20130102', periods=6), "city":['Beijing ', 'SH', ' guangzhou ', 'Shenzhen', 'shanghai', 'BEIJING '], "age":[23,44,54,32,34,32], "category":['100-A','100-B','110-A','110-C','210-A','130-F'], "price":[1200,np.nan,2133,5433,np.nan,4432]}, columns =['id','date','city','category','age','price'])
二、数据表查看
python运行1、维度查看:df.shape2、数据表基本信息(维度、列名称、数据格式、所占空间等):df.info()3、每一列数据的格式:df.dtypes4、某一列格式:df['B'].dtype5、空值:df.isnull()6、查看某一列空值:df['B'].isnull()
三、数据预处理
df1=pd.DataFrame({"id":[1001,1002,1003,1004,1005,1006,1007,1008], "gender":['male','female','male','female','male','female','male','female'],"pay":['Y','N','Y','Y','N','Y','N','Y',],"m-point":[10,12,20,40,40,40,30,20]})
1、数据表合并
merge
df_inner=pd.merge(df,df1,how='inner') # 匹配合并,交集df_left=pd.merge(df,df1,how='left') #df_right=pd.merge(df,df1,how='right')df_outer=pd.merge(df,df1,how='outer') #并集
append
join
result = left.join(right, on='key')
concat
pd.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False, keys=None, levels=None, names=None, verify_integrity=False, copy=True)
2、设置索引列
3、按照特定列的值排序:
df_inner.sort_values(by=['age'])
4、按照索引列排序:
5、如果prince列的值>3000,group列显示high,否则显示low:
df_inner['group'] = np.where(df_inner['price'] > 3000,'high','low')
6、对复合多个条件的数据进行分组标记
df_inner.loc[(df_inner['city'] == 'beijing') & (df_inner['price'] >= 4000), 'sign']=1
7、对category字段的值依次进行分列,并创建数据表,索引值为df_inner的索引列,列名称为category和size
pd.DataFrame((x.split('-') for x in df_inner['category']),index=df_inner.index,columns=['category','size'])
8、将完成分裂后的数据表和原df_inner数据表进行匹配
df_inner=pd.merge(df_inner,split,right_index=True, left_index=True)
四、数据表清洗
1、用数字0填充空值:df.fillna(value=0)2、使用列prince的均值对NA进行填充:df['prince'].fillna(df['prince'].mean())3、清除city字段的字符空格:df['city']=df['city'].map(str.strip)4、大小写转换:df['city']=df['city'].str.lower()5、更改数据格式:df['price'].astype('int') 6、更改列名称:df.rename(columns={'category': 'category-size'}) 7、删除后出现的重复值:df['city'].drop_duplicates()8 、删除先出现的重复值:df['city'].drop_duplicates(keep='last')9、数据替换:df['city'].replace('sh', 'shanghai')
五、数据提取
1、按索引提取单行的数值df_inner.loc[3]2、按索引提取区域行数值df_inner.iloc[0:5]3、重设索引df_inner.reset_index()4、设置日期为索引df_inner=df_inner.set_index('date') 5、提取4日之前的所有数据df_inner[:'2013-01-04']6、使用iloc按位置区域提取数据df_inner.iloc[:3,:2] #冒号前后的数字不再是索引的标签名称,而是数据所在的位置,从0开始,前三行,前两列。7、适应iloc按位置单独提起数据df_inner.iloc[[0,2,5],[4,5]] #提取第0、2、5行,4、5列8、使用ix按索引标签和位置混合提取数据df_inner.ix[:'2013-01-03',:4] #2013-01-03号之前,前四列数据9、判断city列的值是否为北京df_inner['city'].isin(['beijing'])10、判断city列里是否包含beijing和shanghai,然后将符合条件的数据提取出来df_inner.loc[df_inner['city'].isin(['beijing','shanghai'])] 11、提取前三个字符,并生成数据表pd.DataFrame(df_inner['category'].str[:3])
六、数据筛选
使用与、或、非三个条件配合大于、小于、等于对数据进行筛选,并进行计数和求和。
1、使用“与”进行筛选df_inner.loc[(df_inner['age'] > 25) & (df_inner['city'] == 'beijing'), ['id','city','age','category','gender']]2、使用“或”进行筛选df_inner.loc[(df_inner['age'] > 25) | (df_inner['city'] == 'beijing'), ['id','city','age','category','gender']].sort(['age']) 3、使用“非”条件进行筛选df_inner.loc[(df_inner['city'] != 'beijing'), ['id','city','age','category','gender']].sort(['id']) 4、对筛选后的数据按city列进行计数df_inner.loc[(df_inner['city'] != 'beijing'), ['id','city','age','category','gender']].sort(['id']).city.count()5、使用query 函数进行筛选df_inner.query('city == ["beijing", "shanghai"]')6、对筛选后的结果按prince进行求和df_inner.query('city == ["beijing", "shanghai"]').price.sum()
七、数据汇总
1、对所有的列进行计数汇总df_inner.groupby('city').count()2、按城市对id字段进行计数df_inner.groupby('city')['id'].count()3、对两个字段进行汇总计数df_inner.groupby(['city','size'])['id'].count()4、对city字段进行汇总,并分别计算prince的合计和均值df_inner.groupby('city')['price'].agg([len,np.sum, np.mean])
八、数据统计
数据采样,计算标准差,协方差和相关系数
1、简单的数据采样df_inner.sample(n=3) 2、手动设置采样权重weights = [0, 0, 0, 0, 0.5, 0.5]df_inner.sample(n=2, weights=weights) 3、采样后不放回df_inner.sample(n=6, replace=False) 4、采样后放回df_inner.sample(n=6, replace=True)5、 数据表描述性统计df_inner.describe().round(2).T #round函数设置显示小数位,T表示转置6、计算列的标准差df_inner['price'].std()7、计算两个字段间的协方差df_inner['price'].cov(df_inner['m-point']) 8、数据表中所有字段间的协方差df_inner.cov()9、两个字段的相关性分析df_inner['price'].corr(df_inner['m-point']) #相关系数在-1到1之间,接近1为正相关,接近-1为负相关,0为不相关10、数据表的相关性分析df_inner.corr()
九、数据输出
分析后的数据可以输出为xlsx格式和csv格式
1、写入Excel
df_inner.to_excel('excel_to_python.xlsx', sheet_name='bluewhale_cc')
2、写入到CSV
df_inner.to_csv('excel_to_python.csv')
 10个月宝宝每天需要喝多少奶粉?