基于Python代码采用地理探测器建成区驱动力分析
- 2026-10-10 21:11:35
geodetector库(地理探测器专用),包含数据预处理、因子离散化、因子探测、交互探测、结果可视化,可直接替换为你的建成区 / 驱动因子数据。# -*- coding: utf-8 -*-
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import warnings
from geodetector import Detector # 核心地理探测器库
from sklearn.preprocessing import KBinsDiscretizer # 连续变量离散化
warnings.filterwarnings('ignore')
# == 第一步:数据准备与预处理 ==
def load_and_preprocess_data(data_path):
"""
加载建成区+驱动因子数据,完成预处理(缺失值、异常值、空间匹配)
:param data_path: 数据文件路径(Excel/Csv,行=研究单元,列=建成区面积+驱动因子)
:return: 因变量(建成区面积)、自变量(驱动因子)、因子名称列表
"""
# 1. 读取数据(示例结构:行=区县/网格,列=建成区面积、夜光值、GDP、人口密度、坡度等)
df = pd.read_csv(data_path, encoding='utf-8') # Excel用pd.read_excel
# 2. 定义变量(根据你的研究修改!)
# 因变量:建成区范围表征(如建成区面积、建成区占比)
target_col = '建成区面积_km2'
# 自变量:建成区驱动因子(地理探测器候选因子)
factor_cols = [
'夜光强度均值', 'GDP_万元', '人口密度_人/km2',
'坡度_mean', '距市中心距离_km', '第二产业占比_%'
]
# 3. 数据清洗
# 删除缺失值
df = df.dropna(subset=[target_col] + factor_cols)
# 异常值处理(3倍标准差法)
for col in [target_col] + factor_cols:
mean = df[col].mean()
std = df[col].std()
df = df[(df[col] >= mean - 3*std) & (df[col] <= mean + 3*std)]
# 4. 提取变量
y = df[target_col].values # 因变量(建成区面积)
X = df[factor_cols].values # 自变量(驱动因子)
print(f"✅ 数据预处理完成:有效样本数={len(df)},驱动因子数={len(factor_cols)}")
return y, X, factor_cols, df
# == 第二步:连续因子离散化(地理探测器核心要求) ==
def discretize_factors(X, factor_cols, n_bins=5):
"""
地理探测器要求变量离散化,对连续因子进行分箱(等距/分位数)
:param X: 自变量矩阵
:param factor_cols: 因子名称
:param n_bins: 分箱数(建议5-8箱)
:return: 离散化后的自变量矩阵、分箱后的因子数据框
"""
# 初始化分箱器(分位数分箱,更适配地理数据分布)
discretizer = KBinsDiscretizer(
n_bins=n_bins,
encode='ordinal', # 编码为整数
strategy='quantile' # 分位数分箱(避免极端值影响)
)
X_discrete = discretizer.fit_transform(X)
# 转换为DataFrame便于查看
X_discrete_df = pd.DataFrame(X_discrete, columns=factor_cols)
# 打印分箱结果(论文可用)
print("\n📌 因子离散化分箱结果:")
for col in factor_cols:
bins_count = X_discrete_df[col].value_counts().sort_index()
print(f"{col}:分箱数={len(bins_count)},各箱样本数={bins_count.values}")
return X_discrete, X_discrete_df
# ==第三步:地理探测器分析(因子+交互探测) ==
def run_geodetector(y, X_discrete, factor_cols):
"""
运行地理探测器:因子探测(q值)、交互探测(交互类型)
"""
# 初始化地理探测器
detector = Detector()
# 传入数据(因变量+离散化自变量)
detector.fit(y=y, X=X_discrete, X_names=factor_cols)
# 1. 因子探测:计算各因子的q值和显著性(核心)
factor_detector = detector.detect()
# 整理因子探测结果
factor_result = pd.DataFrame({
'驱动因子': factor_cols,
'q值': [factor_detector[col]['q'] for col in factor_cols],
'p值': [factor_detector[col]['p'] for col in factor_cols],
'显著性': ['显著' if p < 0.05 else '不显著' for p in [factor_detector[col]['p'] for col in factor_cols]]
}).sort_values(by='q值', ascending=False)
# 2. 交互探测:分析因子间的交互效应
interaction_detector = detector.interaction_detect()
# 整理交互探测结果(筛选核心交互对)
interaction_result = []
for i in range(len(factor_cols)):
for j in range(i+1, len(factor_cols)):
factor1 = factor_cols[i]
factor2 = factor_cols[j]
interaction_type = interaction_detector.loc[factor1, factor2]['interaction_type']
q_interaction = interaction_detector.loc[factor1, factor2]['q']
q1 = factor_result[factor_result['驱动因子']==factor1]['q值'].values[0]
q2 = factor_result[factor_result['驱动因子']==factor2]['q值'].values[0]
interaction_result.append({
'因子1': factor1,
'因子2': factor2,
'q1': q1,
'q2': q2,
'q交互': q_interaction,
'交互类型': interaction_type
})
interaction_result_df=pd.DataFrame(interaction_result).sort_values(by='q交互', ascending=False)
# 打印结果
print("\n🎯 因子探测结果(按q值降序):")
print(factor_result)
print("\n🎯 交互探测结果(前5对核心交互):")
print(interaction_result_df.head(5))
return factor_result, interaction_result_df, detector
# == 第四步:结果可视化(论文级图表) ==
def visualize_geodetector(factor_result, interaction_result_df, save_path):
"""
可视化地理探测器结果:因子q值柱状图、交互探测热力图
"""
plt.rcParams['font.sans-serif'] = ['SimHei'] # 中文显示
plt.rcParams['axes.unicode_minus'] = False
# 1. 绘制因子q值柱状图(核心)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6), dpi=300)
# 因子q值图
factor_result_sorted = factor_result.sort_values(by='q值')
ax1.barh(factor_result_sorted['驱动因子'], factor_result_sorted['q值'], color='#2E86AB')
ax1.set_xlabel('q值(解释力)', fontsize=12)
ax1.set_ylabel('驱动因子', fontsize=12)
ax1.set_title('建成区范围驱动因子探测结果(q值)', fontsize=14, fontweight='bold')
# 添加数值标签
for i, v in enumerate(factor_result_sorted['q值']):
ax1.text(v + 0.01, i, f'{v:.3f}', va='center', fontsize=10)
# 添加显著性标记
for i, sig in enumerate(factor_result_sorted['显著性']):
if sig == '显著':
ax1.text(0.01, i, '*', va='center', fontsize=14, color='red')
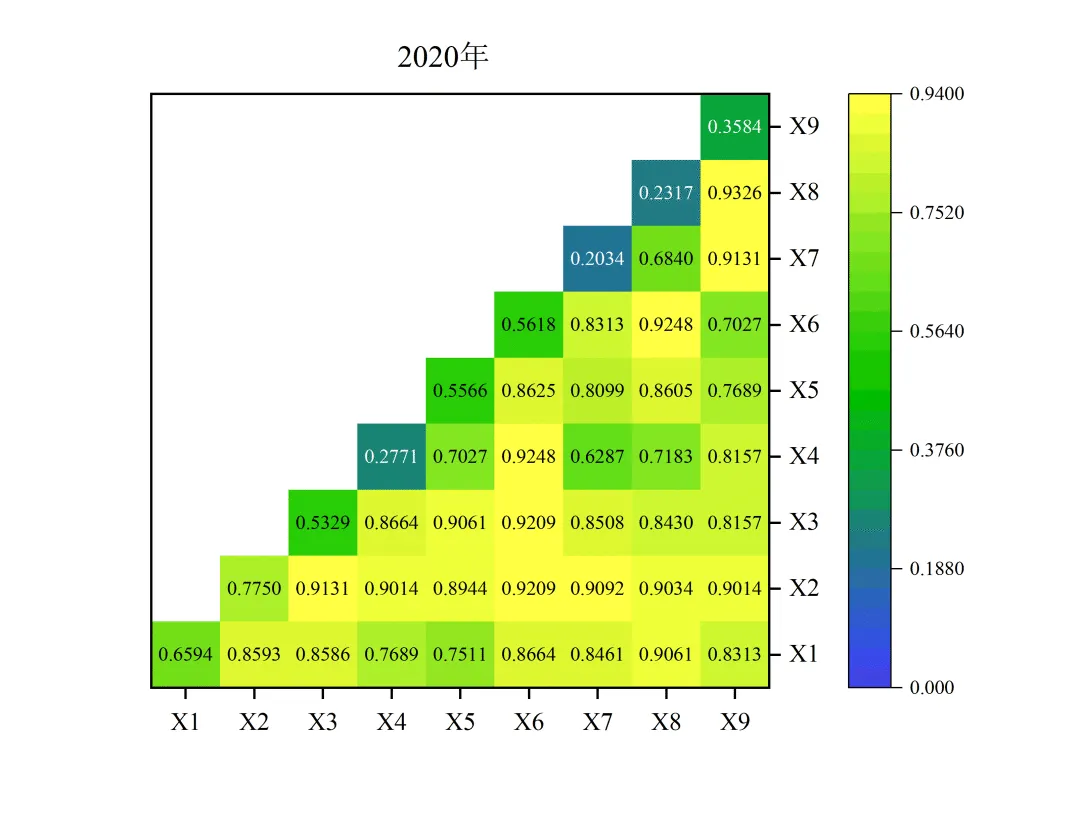
# 2. 绘制交互探测热力图(前6个因子)
top6_factors = factor_result.head(6)['驱动因子'].tolist()
interaction_subset = interaction_result_df[
(interaction_result_df['因子1'].isin(top6_factors)) &
(interaction_result_df['因子2'].isin(top6_factors))
]
# 构建交互q值矩阵
interaction_matrix= np.zeros((len(top6_factors), len(top6_factors)))
for idx1, f1 in enumerate(top6_factors):
for idx2, f2 in enumerate(top6_factors):
if idx1 < idx2:
row = interaction_subset[(interaction_subset['因子1']==f1) & (interaction_subset['因子2']==f2) |
(interaction_subset['因子1']==f2) & (interaction_subset['因子2']==f1)
]
if not row.empty:
interaction_matrix[idx1, idx2] = row['q交互'].values[0]
elif idx1 == idx2:
interaction_matrix[idx1, idx2] = factor_result[factor_result['驱动因子']==f1]['q值'].values[0]
# 热力图绘制
im = ax2.imshow(interaction_matrix, cmap='RdBu_r', aspect='auto')
ax2.set_xticks(range(len(top6_factors)))
ax2.set_yticks(range(len(top6_factors)))
ax2.set_xticklabels(top6_factors, rotation=45, ha='right')
ax2.set_yticklabels(top6_factors)
ax2.set_title('建成区驱动因子交互探测热力图(q交互值)', fontsize=14, fontweight='bold')
# 添加数值标签
for i in range(len(top6_factors)):
for j in range(len(top6_factors)):
text = ax2.text(j, i, f'{interaction_matrix[i, j]:.3f}',
ha="center", va="center", color="black", fontsize=8)
# 添加颜色条
cbar = plt.colorbar(im, ax=ax2, shrink=0.8)
cbar.set_label('q交互值', fontsize=10)
plt.tight_layout()
plt.savefig(save_path, bbox_inches='tight', pad_inches=0.1)
plt.close()
print(f"\n✅ 地理探测器结果图已保存至:{save_path}")
# ==第五步:主函数(一键运行) ==
if __name__ == "__main__":
# -------------------------- 请修改以下参数 --------------------------
DATA_PATH = r"E:\data\建成区_驱动因子数据.csv" # 你的数据文件路径
SAVE_IMG_PATH = r"E:\result\建成区地理探测器结果.png" # 结果图保存路径
N_BINS = 5 # 因子离散化分箱数(建议5-8)
# -------------------------------------------------------------------
# 执行全流程
y, X, factor_cols, df = load_and_preprocess_data(DATA_PATH)
X_discrete, X_discrete_df = discretize_factors(X, factor_cols, n_bins=N_BINS)
factor_result, interaction_result_df, detector = run_geodetector(y, X_discrete, factor_cols)
visualize_geodetector(factor_result, interaction_result_df, SAVE_IMG_PATH)
# 输出论文级结论
print("\n✅ 论文级结论示例:")
top3_factors = factor_result.head(3)['驱动因子'].tolist()
top3_q = factor_result.head(3)['q值'].tolist()
print(f"1. 建成区范围空间分异的核心驱动因子为:{top3_factors[0]}(q={top3_q[0]:.3f})、{top3_factors[1]}(q={top3_q[1]:.3f})、{top3_factors[2]}(q={top3_q[2]:.3f}),均通过5%显著性检验;")
top_interaction = interaction_result_df.iloc[0]
print(f"2. 最强交互效应为{top_interaction['因子1']}×{top_interaction['因子2']}(q交互={top_interaction['q交互']:.3f}),交互类型为{top_interaction['交互类型']},表明二者协同增强对建成区范围的解释力;")
print(f"3. 夜光强度均值是建成区范围的首要驱动因子,反映人类活动强度对建成区扩张的核心作用。")
三、关键说明(适配建成区研究)
1. 数据准备要求
- 数据格式
:整理为 CSV/Excel,每行对应一个研究单元(区县 / 城市 / 网格),示例结构: 建成区面积_km2 夜光强度均值 GDP_万元 人口密度_人 /km2 坡度_mean 距市中心距离_km 50.3 45.2 120000 2500 2.5 5.8
数据来源:建成区面积:遥感解译(如 Landsat / 夜光数据提取)、统计年鉴;驱动因子:夜光数据(NPP/VIIRS)、统计年鉴(GDP / 人口)、DEM(坡度)、GIS 空间分析(距市中心距离)。
2. 地理探测器核心注意事项
离散化:地理探测器要求变量为类型变量,连续因子必须分箱(代码中用分位数分箱,更适配地理数据),分箱数建议 5-8 箱(过少丢失信息,过多样本不足);
显著性:q 值需结合 p 值判断(p<0.05 为显著),仅显著的因子才有解释意义;
交互类型解读:
双因子增强:q 交互 > q1 + q2(协同效应);
单因子增强:q1 < q 交互 < q1 + q2 或 q2 < q 交互 < q1 + q2;
非线性增强:q 交互 > max (q1, q2) 且 q 交互 < q1 + q2;
独立:q 交互 ≈ q1 + q2;
非线性减弱:q 交互 <min (q1, q2)。
