
当前位置:首页>python>python爬虫篇之HTTP协议

python爬虫篇之HTTP协议

  • 2026-09-08 04:17:13
python爬虫篇之HTTP协议

4.4

HTTP协议

目录:

1、协议

2、请求

3、响应

4、请求头中最常见的一些重要内容(爬虫需要)

5、响应头中一些重要的内容

6、请求方式

1

协议

协议就是两个计算机之间为了能够流畅的进行沟通而设置的一个君子协定,常见的协议有TCP/IP.SOAP协议,HTTP协议,SMTP协议等等......

HTTP协议,Hyper Text Transfer Protocol (超文本传输协议)的缩写,是用于从万维网(WWW:World Wide Web)服务器传输超文本到本地浏览器的传说协议,直白点儿,就是浏览器和服务器之间的数据交互遵守的就是HTTP协议。

HTTP协议把一条消息分为三大块内容,无论是请求还是响应都是三块内容

2

请求

① 请求行 -> 请求方式(get/post)请求url地址 协议

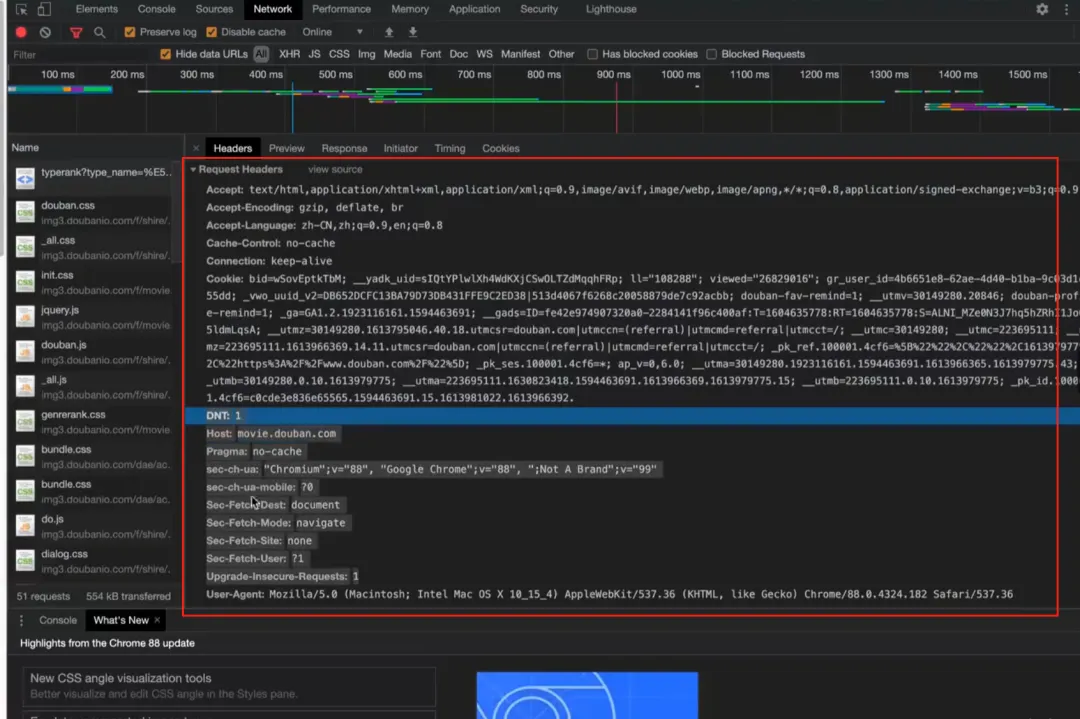
② 请求头 -> 放一些服务器要使用的附加信息

③ 请求体 -> 一般放一些请求参数

3

响应

① 状态行 -> 协议 状态码

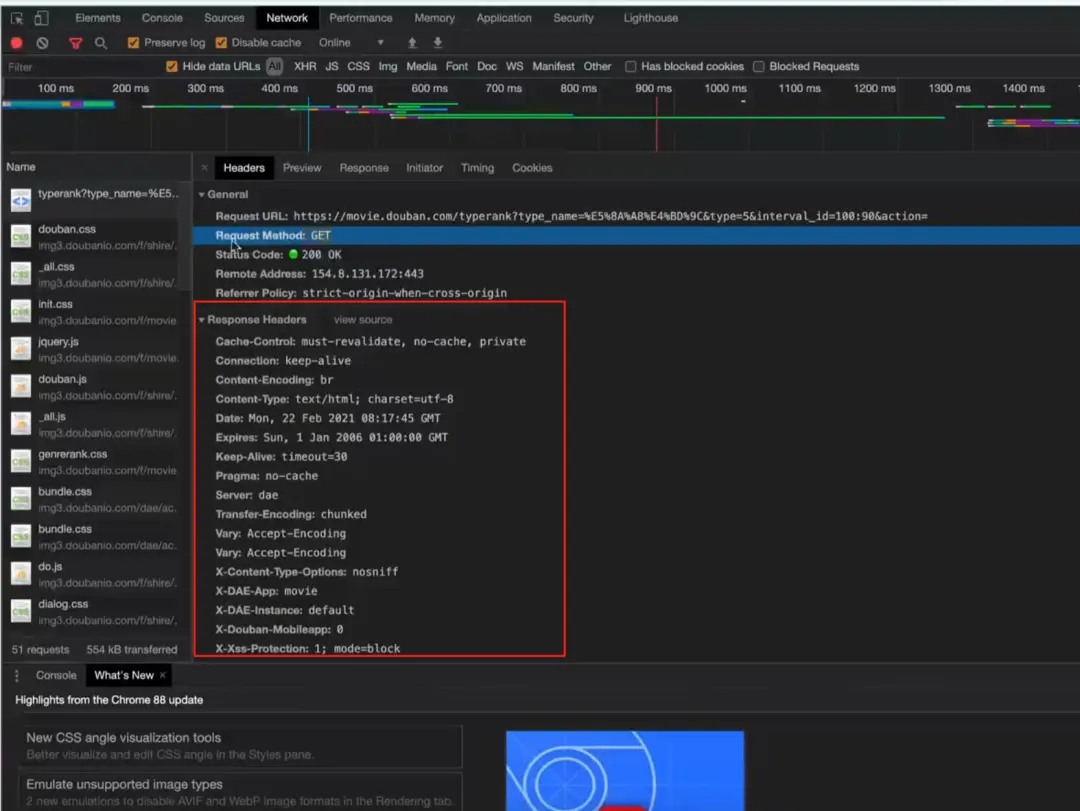
② 响应头 -> 放一些客户端要使用的一些附加信息

③ 响应体 -> 服务器返回的真正客户端要用的内容(HTML、json)等

在后面我们写爬虫的时候要格外注意请求头和响应头,这两个地方一般都隐含着一些比较重要的内容。

4

请求头中最常见的一些重要内容(爬虫需要)

① User-Agent:请求载体的身份标识(用啥发送的请求)

② Referer:防盗链(这次请求是从哪个页面来的?反爬会用到)

③ cookie:本地字符串数据信息(用户登录信息,反爬的token)

5

响应头中一些重要的内容

① cookie:本地字符串数据信息(用户登录信息,反爬的token)

② 各种神奇的莫名其妙的字符串(这个需要经验了,一般都是token字样,防止各种攻击和反爬)

6

请求方式

GET:显示提交

POST:隐示提交

  python爬虫须知

🔸 守规矩:爬前先看 robots.txt,尊重网站规则。

🔸 有礼貌:设置访问间隔(如 time.sleep),别把服务器挤爆。

🔸 装得像:带上合理 User-Agent和请求头,模拟真人浏览器。

🔸 不越界:绝不爬取个人隐私、机密或明确禁止的数据。

🔸 存得好:妥善处理数据,注明来源,注意脱敏。

最新文章

随机文章