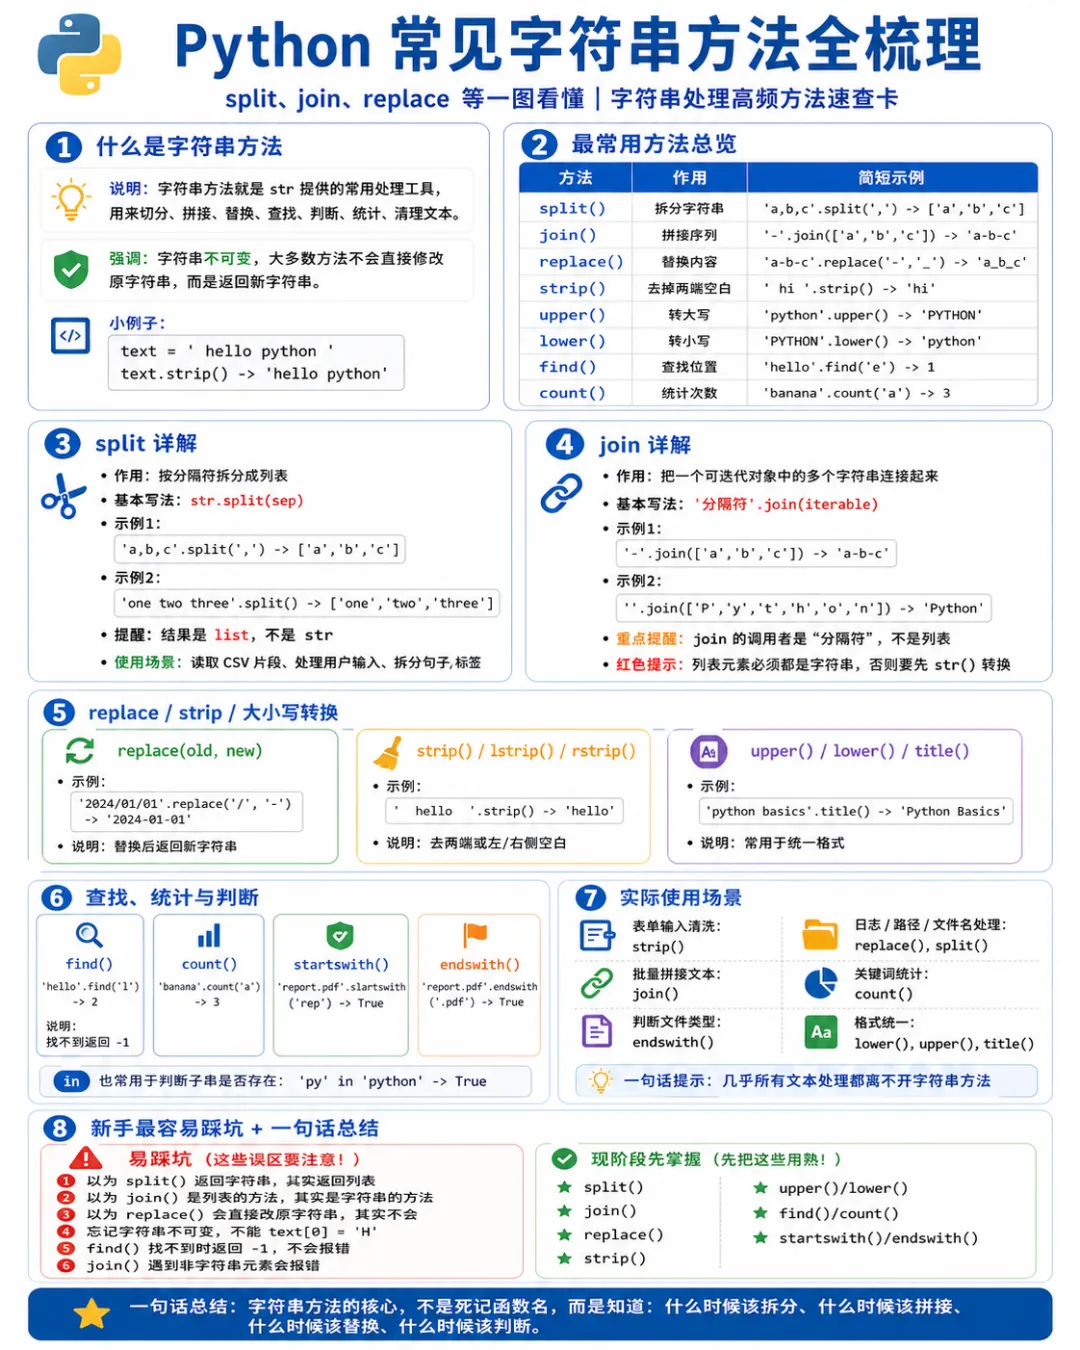
上一章我们已经把字符串的索引和切片讲透了。
你现在已经知道,字符串不是只能整段拿来用,它可以按位置取一个字符,也可以切出一小段内容。 但真实开发里,光靠索引和切片还不够。因为很多需求,不是让你硬数位置,而是让你直接去拆、去拼、去替换、去整理。
比如:
把一句话按逗号拆开 把多个单词重新拼成一句话 把错别字批量替换掉 去掉用户输入前后的空格 把英文全部转成大写或者小写 统计某个词出现了几次
这些事情,全都离不开字符串方法。
这一章,我们不讲太虚的概念,就直接把最常见、最实用、最值得你反复用的字符串方法梳理清楚。 你会发现,索引和切片像一把小刀,而字符串方法更像一整套工具箱。
一、为什么字符串方法这么重要
很多人学字符串时,容易有一个误区。
觉得只要会切片、会拼接,好像就差不多了。 其实远远不够。
因为现实里的文本处理,常常不是固定位置截取,而是更灵活的需求。
比如一行数据:
text = '张三,18,北京'
你要把它拆成三段。 这时候你当然可以硬切:
print(text[0:2])print(text[3:5])print(text[6:8])
但这很笨,而且一旦内容长度变化,代码立刻就废了。
而如果你会字符串方法,就可以更自然地写:
result = text.split(',')print(result)
一下就出来了。
所以字符串方法真正的价值,不是花哨,而是让文本处理更自然、更稳、更接近真实业务。
二、什么叫字符串方法
先看一个例子:
text = 'python'print(text.upper())
这里的 upper(),就是字符串方法。
你可以把方法理解成:
这个类型自带的专属功能
列表有自己的方法。 字典有自己的方法。 字符串当然也有自己的方法。
调用格式通常是:
字符串.方法名()
如果方法还需要额外信息,就把参数写到括号里。
比如:
text.replace('a', 'b')
意思就是:
把字符串里的 a 替换成 b
这一套写法,后面你会越用越多。
三、split():把一整段文字拆开
这是字符串里最常用的方法之一。
它的作用非常直接:
按某个分隔符,把字符串拆成列表。
看例子:
text = '苹果,香蕉,橙子'result = text.split(',')print(result)print(type(result))
输出:
['苹果', '香蕉', '橙子']<class 'list'>
注意,split() 的结果不是字符串,而是列表。
这非常重要。 因为很多文本数据,一开始就是一整行。 你只有先把它拆开,后面才能逐项处理。
比如用户信息:
user = '张三-18-北京'print(user.split('-'))
输出:
['张三', '18', '北京']
你看,这一下就从一整段文本,变成了一组清晰的数据。
四、split() 如果不写分隔符,会发生什么
如果你不写参数,split() 默认按空白字符拆分。
比如:
text = 'hello world python'print(text.split())
输出:
['hello', 'world', 'python']
这里的空白字符,不只是普通空格,也可能包括多个空格、换行、制表符这些。
比如:
text = 'hello world'print(text.split())
输出依然会很干净:
['hello', 'world']
这就是默认 split() 的一个很舒服的地方。 它会帮你自动处理连续空白。
所以以后你碰到用户输入里空格不整齐、日志文本有空白间隔时,这招会很好用。
五、split() 在真实场景里到底有多常见
非常常见。
比如拆 CSV 风格的数据:
line = '1001,张三,95'print(line.split(','))
比如拆路径片段:
path = 'users/admin/docs'print(path.split('/'))
比如拆一句英文:
sentence = 'I love Python'print(sentence.split())
比如拆时间:
time_text = '2026-03-26'print(time_text.split('-'))
输出:
['2026', '03', '26']
你会发现,很多时候我们不是在处理字符串,而是在把一整段字符串还原成结构化数据。
而 split(),就是最常见的第一步。
六、split() 还能限制拆几次
这一点很多新手容易忽略,但很实用。
看例子:
text = 'a-b-c-d'print(text.split('-', 1))
输出:
['a', 'b-c-d']
这里的 1 表示:
最多拆 1 次
再看:
print(text.split('-', 2))
输出:
['a', 'b', 'c-d']
这个功能适合什么场景?
比如你只想把一行内容拆成前半部分和后半部分, 而后半部分里面即使还有同样的分隔符,也不想继续拆。
这在处理文件名、配置项、日志记录时都挺实用。
七、join():把多个字符串重新拼起来
如果说 split() 是拆, 那么 join() 就是拼。
它的作用是:
用某个连接符,把一组字符串拼成一个新的字符串。
看例子:
words = ['我', '爱', 'Python']result = ''.join(words)print(result)
输出:
我爱Python
如果你想中间加空格:
result = ' '.join(words)print(result)
输出:
我 爱 Python
如果你想用逗号连接:
result = ','.join(words)print(result)
输出:
我,爱,Python
你会发现,join() 和 split() 有点像一对搭档。
一个负责拆开。 一个负责拼回去。
八、为什么 join() 经常比加号拼接更好用
很多新手一开始会这样拼字符串:
a = '我'b = '爱'c = 'Python'result = a + b + cprint(result)
这当然没错。 但当你面对很多段字符串时,join() 会更自然。
比如:
words = ['2026', '03', '26']print('-'.join(words))
输出:
2026-03-26
你要是用加号一个个拼,不但啰嗦,而且数据一多就很笨。
所以有个很实用的经验:
已知是多个字符串,想按统一规则拼起来,优先想到 join()
九、join() 有一个很经典的坑
这个方法要求,参与拼接的元素必须都是字符串。
比如这样就没问题:
items = ['1', '2', '3']print(','.join(items))
但如果你这样写:
items = [1, 2, 3]print(','.join(items))
就会报错。
因为 join() 不会自动帮你把整数变成字符串。
正确写法要么提前转好,要么自己处理:
items = [1, 2, 3]items = [str(x) for x in items]print(','.join(items))
输出:
1,2,3
这一点以后你会经常碰到。 尤其是在把数字列表拼成日志、输出提示、文件内容时,很容易踩坑。
十、replace():把旧内容替换成新内容
这个方法也特别高频。
作用非常简单:
把字符串里的某部分内容替换成另一部分。
看例子:
text = '我喜欢Java'new_text = text.replace('Java', 'Python')print(new_text)
输出:
我喜欢Python
这里你要注意一件事:
replace() 不会原地修改原字符串。 它会返回一个新字符串。
所以正确写法通常是:
new_text = text.replace(...)
或者:
text = text.replace(...)
因为字符串本身不可变,这一点和前面讲的索引、切片逻辑是一致的。
十一、replace() 还能控制替换次数
比如:
text = 'ha ha ha'print(text.replace('ha', 'he', 1))
输出:
he ha ha
这里最后的 1 表示:
只替换 1 次
再看:
print(text.replace('ha', 'he', 2))
输出:
he he ha
这个功能在什么地方有用?
比如你只想替换第一个匹配项, 不想把整段文本里所有内容都替掉。
在清洗文本、修正标题、处理日志时,这种控制很方便。
十二、strip():去掉两边多余内容
这也是非常实战的一个方法。
最常见的用途,就是去掉字符串两边的空格。
text = ' hello python 'print(text.strip())
输出:
hello python
注意,strip() 默认只去两边,不会动中间。
比如:
text = ' hello python 'print(text.strip())
输出是:
hello python
中间那几个空格还在。
这个点一定别搞混。
strip() 是去头去尾,不是全局清理。
十三、lstrip() 和 rstrip()
如果你只想去左边,可以用 lstrip()。
text = ' hello'print(text.lstrip())
如果你只想去右边,可以用 rstrip()。
text = 'hello 'print(text.rstrip())
这两个方法没有 strip() 那么高频,但也很常见。 尤其是处理用户输入、文件内容、日志文本时,经常会顺手用上。
十四、strip() 不只能去空格
这一点很重要。
比如:
text = '---python---'print(text.strip('-'))
输出:
python
也就是说,strip() 可以指定要去掉什么字符。
再比如:
text = '***hello***'print(text.strip('*'))
输出:
hello
不过这里要注意,它去的是两边连续出现的指定字符,不是中间全部替换。
这一点和 replace() 是两回事。
十五、upper() 和 lower():大小写转换
这两个在英文文本处理中很常用。
upper() 转大写:
text = 'python'print(text.upper())
输出:
PYTHON
lower() 转小写:
text = 'PYTHON'print(text.lower())
输出:
python
这有什么用?
非常多。
比如你要比较两个英文字符串时,大小写不统一就很麻烦。 这时候通常会先统一大小写再判断。
a = 'Python'b = 'python'print(a.lower() == b.lower())
输出:
True
这在处理用户名、邮箱、标签、命令输入时都很常见。
十六、title():让每个单词首字母大写
看例子:
text = 'hello python world'print(text.title())
输出:
Hello Python World
这个方法在格式化英文标题、人名展示、界面文本整理时会用到。
虽然它不像 split()、replace() 那么高频, 但也属于比较顺手的常用工具。
十七、capitalize():让首字母大写
比如:
text = 'python is good'print(text.capitalize())
输出:
Python is good
它和 title() 的区别是:
capitalize() 只处理整个字符串开头title() 会处理每个单词开头
这个细节你区分一下就行。
十八、count():统计出现次数
这个方法很实用,而且特别直观。
比如:
text = 'banana'print(text.count('a'))
输出:
3
再比如统计某个单词出现几次:
text = 'python python java python'print(text.count('python'))
输出:
3
这在关键词统计、简单文本分析、日志筛查时都很好用。
十九、startswith() 和 endswith():判断开头和结尾
这两个方法下一章还会重点讲,但这里先串起来理解更顺。
看例子:
filename = 'report.pdf'print(filename.endswith('.pdf'))
输出:
True
再比如:
url = 'https://example.com'print(url.startswith('https://'))
输出:
True
这两个方法的好处在于,语义非常清晰。
你一看代码就知道:
这是在判断是不是以什么开头 是不是以什么结尾
比自己手动切片再判断,通常更自然。
二十、find():查找位置
这个方法也很常用。
text = 'I love Python'print(text.find('Python'))
输出:
7
意思是,Python 这段内容第一次出现的位置,从索引 7 开始。
如果找不到,会返回:
-1
比如:
print(text.find('Java'))
输出:
-1
这一点很重要。 因为它和直接报错不一样。find() 找不到时不会炸,而是用 -1 告诉你没找到。
二十一、split、join、replace 三兄弟,经常一起出现
这组方法在实际开发里特别常见。
比如一段标签文本:
text = 'Python,Java,Python,Go'
你想先拆开:
tags = text.split(',')print(tags)
然后把其中的 Java 改成 JavaScript:
tags = [tag.replace('Java', 'JavaScript') for tag in tags]print(tags)
最后再拼回去:
result = '|'.join(tags)print(result)
输出可能是:
Python|JavaScript|Python|Go
你看,这就是很典型的文本处理流程。
先拆 再改 再拼
很多字符串题,表面看五花八门,实际上就是在这几步之间来回组合。
二十二、一个特别真实的小案例:清洗用户输入
假设用户输入了这样一行信息:
text = ' 张三 , 18 , 北京 '
现在你希望它变成更规整的数据。
第一步,先去掉两边空格:
text = text.strip()print(text)
第二步,按逗号拆开:
parts = text.split(',')print(parts)
你会发现,每一项两边还带着空格。 所以第三步,继续清理:
clean_parts = [item.strip() for item in parts]print(clean_parts)
输出:
['张三', '18', '北京']
这就是一个特别典型的字符串处理过程。
如果你不会这些方法,代码会写得非常别扭。 而一旦熟了,很多真实数据清洗都会变得很顺。
二十三、一个特别真实的小案例:批量拼通知文本
假设你有一个名单:
names = ['张三', '李四', '王五']
你想把它拼成一句通知:
message = '今天到场的同学有:' + '、'.join(names)print(message)
输出:
今天到场的同学有:张三、李四、王五
这就是 join() 最舒服的使用场景之一。
很多提示语、日志、导出文本、邮件内容,都会这么拼。
二十四、一个特别真实的小案例:清洗文件扩展名
比如用户传来一批文件名:
files = ['report.PDF', 'photo.JPG', 'data.CSV']
你想统一变成小写:
new_files = [name.lower() for name in files]print(new_files)
输出:
['report.pdf', 'photo.jpg', 'data.csv']
这就是大小写转换最典型的用法。
你会发现,方法本身不复杂。 难的是你能不能一看到问题,就自然想到该用哪个方法。
二十五、最容易犯的几个错
先说第一个。
很多人以为字符串方法会直接改原字符串。 比如:
text = 'python'text.upper()print(text)
输出还是:
python
因为你没有接收返回值。
正确写法要么是:
new_text = text.upper()
要么是:
text = text.upper()
第二个错,是分不清 strip() 和 replace()。
strip() 是去两边。replace() 是全文替换。
第三个错,是 join() 里混进了数字。
这个前面已经说过,join() 要求参与拼接的元素必须都是字符串。
第四个错,是 split() 完之后忘了结果已经是列表。 一拆开,类型就变了,后面操作思路也要跟着变。
二十六、别死记方法,要按用途去记
这一章方法不少,但你别用背单词的方式去记。
更好的方式是按用途分类。
想拆开内容,先想到 split()想重新拼起来,先想到 join()想替换旧文本,先想到 replace()想去掉两边杂质,先想到 strip()想统一大小写,先想到 upper() 和 lower()想统计出现次数,先想到 count()想判断开头结尾,先想到 startswith() 和 endswith()想找位置,先想到 find()
这样记,会比单独背名字顺很多。
二十七、练习题:这一章特别适合多敲几遍
下面这些练习非常典型,建议你自己动手。
1. 把 apple,banana,orange 拆成列表
text = 'apple,banana,orange'print(text.split(','))
2. 把列表 ['2026', '03', '26'] 拼成 2026-03-26
parts = ['2026', '03', '26']print('-'.join(parts))
3. 把 我喜欢Java 替换成 我喜欢Python
text = '我喜欢Java'print(text.replace('Java', 'Python'))
4. 去掉 hello python 两边的空格
text = ' hello python 'print(text.strip())
5. 把 python 转成大写,再把 PYTHON 转成小写
print('python'.upper())print('PYTHON'.lower())
6. 统计 banana 里 a 出现了几次
print('banana'.count('a'))
7. 判断 report.pdf 是否以 .pdf 结尾
print('report.pdf'.endswith('.pdf'))
8. 查找 Python 在 I love Python 中第一次出现的位置
print('I love Python'.find('Python'))
这些题你只要亲手敲一遍,字符串方法的感觉就会明显起来。
二十八、本章小结
这一章我们正式把字符串方法这套工具箱打开了。
你要带走的核心,不是机械背下所有名字,而是知道它们各自解决什么问题。
split() 负责拆join() 负责拼replace() 负责改strip() 负责清upper() 和 lower() 负责统一大小写count() 负责统计find() 负责找位置startswith() 和 endswith() 负责判断开头结尾
学会这些以后,你处理字符串就不再只是靠切片硬抠位置了。 你开始有了一套更自然、更接近真实需求的处理方式。
下一章我们继续讲 查找与判断:startswith、endswith、find、in 的用法。 那一章会把字符串里最常见的查找和判断动作单独讲透。