DeepSeek+Python,普通电脑也能飞
- 2026-10-11 07:28:37
说实话,我第一次在笔记本上跑通DeepSeek的时候,有点不敢信。
一台用了三年的普通笔记本,没有独立显卡,16G内存,打开Ollama,输入一行命令,15分钟后——它居然在本地跑起来了。不是那种等半天吐一个字的勉强,是真真切切能对话的流畅。
那一刻我突然意识到: 大模型本地化的门槛,真的降下来了。
过去一年,大家聊AI聊的都是"云端怎么用"。OpenAI的API、DeepSeek的官网、各种ChatGPT套壳——本质上都是同一个模式:你发请求,云端的巨兽帮你算,算完把结果送回来。
但这个模式有几个绕不开的痛点: 要联网、要花钱、数据要出境。
现在,DeepSeek+Python+Ollama这套组合拳,直接把这些痛点一个个锤碎了。
三步搞定本地部署,真的不难
先说最核心的事:怎么在你的电脑上跑起来。
第一步:装Ollama。 去官网下载安装包,Windows/Mac/Linux全支持,双击安装,跟装个普通软件没区别。不需要配环境、不需要装CUDA、不需要折腾依赖——这已经是2026年最大的进步了。两年前你想本地跑个大模型,光装环境就能把人劝退。
第二步:拉模型。 打开终端,输入一行命令:
ollama pull deepseek-r1:8b
8B参数的蒸馏版,大约5GB。网速正常的话,5-10分钟下完。如果你的电脑内存8G以上,就选这个版本;实在配置低,1.5B版本1GB出头,连老笔记本都能跑。
第三步:开聊。 输入 ollama run deepseek-r1:8b ,出现 >>> 提示符,直接打字提问就行。
就这么简单。三步,15分钟,你的电脑就有了一个本地AI。
实测数据:RTX 4060显卡上,DeepSeek-R1 8B版本能达到35 tokens/秒的生成速度,比很多人打字都快。纯CPU模式也有3-5 tokens/秒,写个邮件、总结个文档完全够用。
Python接入:这才是封神的关键
单纯在终端里聊天,也就是个玩具。 真正让DeepSeek封神的,是Python。
因为Python是AI领域的"第一语言",DeepSeek从设计之初就跟Python生态深度绑定。这意味着你不需要学新语言、不需要换工具链,直接在你熟悉的Python环境里就能调用DeepSeek的全部能力。
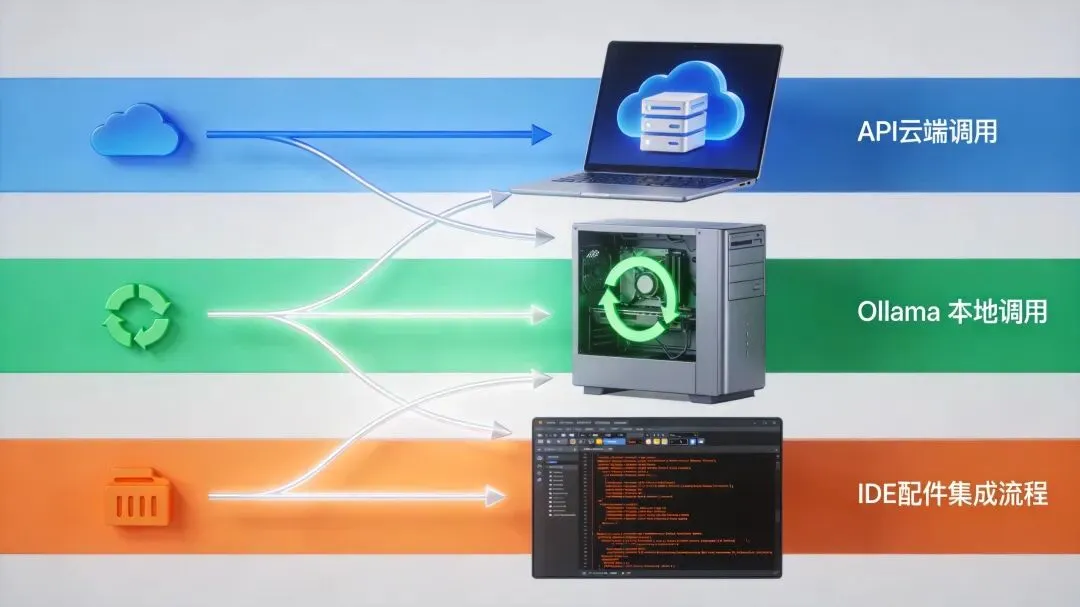
三种接入方式,从简到繁:
方式一:API调用(最简单)
注册DeepSeek开放平台,拿到API Key,然后:
importrequests
response=requests.post(
"https://api.deepseek.com/v1/chat/completions",
headers={"Authorization":"Bearer sk-你的密钥"},
json={"model":"deepseek-chat",
"messages":[{"role":"user","content":"你好"}]}
)
print(response.json()["choices"][0]["message"]["content"])
5行代码,搞定。新用户注册还送500万tokens的额度,够你玩很久。
方式二:本地Ollama + Python(最自由)
模型已经在本地了,Python直接调Ollama的API:
importrequests
res=requests.post("http://localhost:11434/api/generate",
json={"model":"deepseek-r1:8b",
"prompt":"用Python写一个快速排序","stream":False})
print(res.json()["response"])
零成本,零延迟,数据不出本机。隐私敏感场景的刚需。
方式三:PyCharm/VSCode插件(最实用)
装个Continue插件或CodeGPT插件,配置好DeepSeek的API Key或本地Ollama地址,你的IDE直接变成AI编程助手。
写代码时按Tab自动补全,选中代码右键一键解释、重构、生成注释。实测重复代码量减少60%以上,调试效率提升明显。这比你在浏览器和IDE之间来回切,体验好了不止一个档次。
为什么说"封神"?三个碾压级优势
说封神不是夸张,是跟之前的方案对比出来的。
优势一:成本碾压。
OpenAI的GPT-4 API,100万输入tokens要30美元。DeepSeek的API,同级别能力只要2美元。差了15倍。
本地跑的话,成本直接归零——电费除外。对个人开发者和中小团队来说,这个差距不是省不省钱的问题,是"用得起"和"用不起"的区别。
优势二:隐私碾压。
所有数据在本地跑,不需要上传到任何云端服务器。你的代码、你的文档、你的客户数据——全在你自己的硬盘上。
对于律师、医生、金融机构这些隐私敏感行业,这个特性直接决定了能不能用。你总不能把客户的合同扔到OpenAI的服务器上让GPT帮你分析吧?但本地DeepSeek完全可以。
优势三:灵活性碾压。
云端API是黑箱,你只能调参不能改模型。本地部署的DeepSeek可以微调——用你自己的数据训练,让它在你的领域里更准。PyTorch + Hugging Face这套Python生态,微调流程已经非常成熟。
法律领域微调一下,它就更懂法条;医疗领域微调一下,它就更懂病历。这种定制化能力,云端API给不了你。
实话实说:不是没有坑
吹了半天,该说说问题了。
坑一:模型越大越聪明,但也越吃资源。
1.5B版本傻瓜都能跑,但回答质量也就那样——简单问题还行,稍微复杂点就开始胡说。7B/8B是甜点,性价比最高。14B以上就需要16GB+显存了,普通电脑扛不住。
所以选版本别贪大,8B是普通电脑的最佳选择。
坑二:国内下载模型经常超时。
Ollama默认走国外源,速度感人。解决方案:用国内镜像, export OLLAMA_MIRROR=https://ollama.ac.cn ,或者直接去魔搭社区下载GGUF文件离线导入。
坑三:DeepSeek-R1是推理模型,输出带思考过程。
它会先 <think > 一段推理链,再给最终答案。第一次用的人经常以为出bug了——怎么答个问题叨叨叨说半天?这不是bug,是特性。R1的强项就是推理,思考过程可见反而是优点。如果不想看,加个 --no-think 参数就行。
坑四:纯CPU模式确实慢。
3-5 tokens/秒,写短东西没问题,长文本就得有点耐心。如果你是重度用户,还是建议弄个独立显卡。RTX 3060就够跑8B模型了,二手市场一千多块。
2026年,普通人该怎么做?
最后给一个实在的建议。
如果你是开发者 ,别犹豫,今天就把Ollama装上,跑一个DeepSeek-R1 8B。5分钟的事,你会感受到什么叫"AI编程助手就在我电脑里"。然后接上Continue插件,让DeepSeek深度融入你的开发流程。
如果你是知识工作者 ,试试DeepSeekMine或者Cherry Studio,它们把DeepSeek+本地知识库封装成了开箱即用的产品,不需要你写一行代码。
如果你只是好奇 ,装个Ollama,跑个1.5B版本体验一下。模型只有1GB,对电脑几乎零压力。
大模型本地化的趋势已经不可逆了。从"只有大公司跑得起"到"普通笔记本15分钟搞定",这个门槛的降低速度,比大多数人想象的快得多。
而DeepSeek用Python做桥梁,把这个门槛又往下踩了一级。
你的电脑,其实比你以为的更强大。#DeepSeek #Python #本地部署 #Ollama #AI编程 #开源大模型 #国产AI
