由于借助 AI 工具学习编程已经变得非常容易了,因此之后的课程就不再默认进行视频讲解了,如果特别需要视频讲解也可以联系李老师预约讲解~讲义材料学习过程中遇到的问题也可以及时与李老师联系。
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/99121a81bb3840cdb4007238fc322022
今天给大家分享使用 Python 测算各城市数字产业集聚程度的方法。该方法参考屠西伟、史丹(2025)《数字产业集聚与企业能源效率改进》,通过区位熵来综合测度城市的数字产业集聚水平。
附件中提供了该参考文献的 PDF 文件,感兴趣的小伙伴可以阅读原文。
指标来源与计算原理
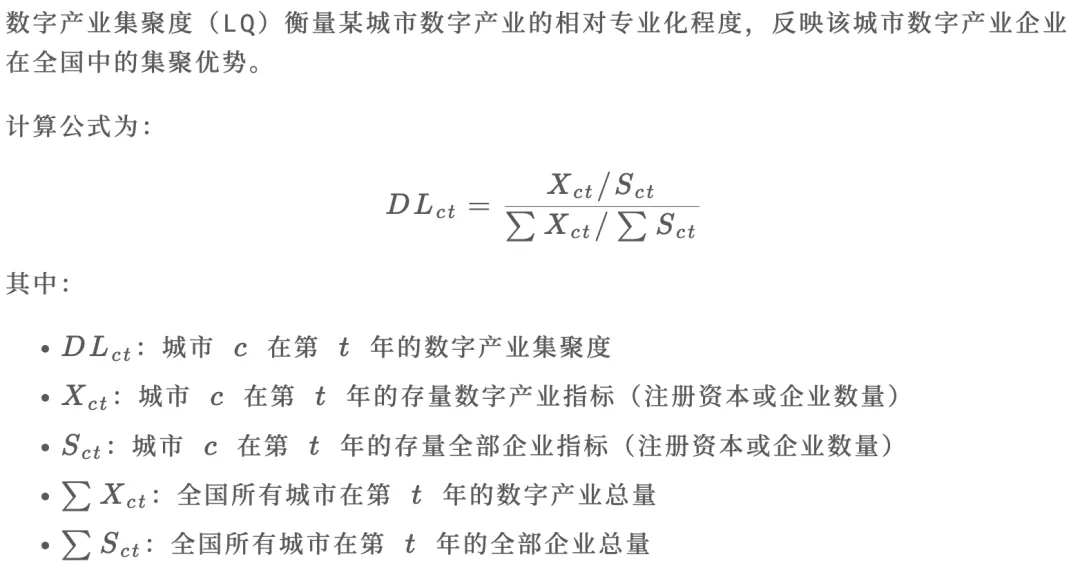
数字产业集聚度(Location Quotient)
区位熵的经济含义
- DL > 1:该城市数字产业集聚度高于全国平均水平,具有相对专业化优势
两种测算方法
本文介绍两种测算方式,主要区别在于分子分母的衡量单位不同:
| XctX_{ct}Xct | SctS_{ct}Sct | | |
|---|
| 注册资本版 | | | | |
| 企业数量版 | | | | |
计算步骤概述
整个计算流程分为以下几个步骤:
- 读取行业分类:加载《数字经济及其核心产业统计分类(2021)》代码表
- 构建注销查找表:从注销企业 CSV 中提取
newgcid → exit_year 映射 - 单年聚合:逐年读取注册企业 CSV,先过滤已注销企业,再按城市聚合
- 计算区位熵:按公式计算 DL,并进行 Winsorize 极端值处理
数据说明
数据来源
1949~2023 年工商企业注册信息数据(含经纬度及其所属的省市区县)(版本2):https://rstata.duanshu.com/#/brief/course/6d38a3f10cdb467492f3204d1ebdd313
1970~2023 年各年各省市区县、各行业注销公司工商信息及数量统计面板数据:https://rstata.duanshu.com/#/brief/course/bcdf21ad0e614645b8449e69342e0851
- 数字经济核心产业分类:
数字经济及其核心产业统计分类.dta,提取自《数字经济及其核心产业统计分类(2021)》。
注销企业处理逻辑
本文采用个体层面过滤的方法处理注销企业:
第 t 年存量企业 = t 年及之前注册的且 t 年及之前未注销的企业
具体实现:预先从注销企业 CSV 提取 newgcid → exit_year 查找表,缓存为 pickle 文件,在每年聚合前关联该表,直接过滤掉 exit_year <= t 的企业,再对存活企业进行聚合。
使用 reticulate 创建与管理 Python 虚拟环境
在 R 中通过 reticulate 包来调用 Python,最好的实践是为项目创建一个专属的 Python 虚拟环境,将所需依赖隔离到独立空间,避免与系统 Python(如 Anaconda)发生版本冲突。
重要说明(避免"已初始化"报错):reticulate 在 R 会话中只能绑定一次 Python——一旦某个 {python} 代码块运行,Python 解释器就被锁定,之后再调用 use_virtualenv() 会报错。因此,虚拟环境的激活必须在所有 {python} 代码块之前完成。本文档的解决方案是在 setup chunk 中通过 Sys.setenv(RETICULATE_PYTHON = ...) 提前锁定 Python 路径。
安装 reticulate(仅首次)
options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))if (!requireNamespace("reticulate", quietly = TRUE)) { install.packages("reticulate") message("reticulate 安装完成!") message("reticulate 已安装,版本:", packageVersion("reticulate"))虚拟环境初始化原理(已在 setup chunk 中完成)
本文档的 setup chunk(隐藏运行)包含如下逻辑:
.venv_python <- virtualenv_python(.venv_name)if(!file.exists(.venv_python)){ virtualenv_create(.venv_name) .venv_python <- virtualenv_python(.venv_name)# 通过环境变量抢先锁定 Python(优先级最高)Sys.setenv(RETICULATE_PYTHON = .venv_python)use_virtualenv(.venv_name, required =TRUE)在虚拟环境中安装 Python 包(仅首次)
py_pkgs <- c("numpy", "pandas", "matplotlib")installed <- py_list_packages(".venv")$packageneed_install <- setdiff(py_pkgs, installed)if (length(need_install) > 0) { virtualenv_install(".venv", packages = need_install) message("已安装缺失的包:", paste(need_install, collapse = ", ")) message("所有 Python 包已就绪,无需安装")验证激活状态
步骤一:读取数字经济产业行业代码
加载分类标准
digi_dta = pd.read_stata("数字经济及其核心产业统计分类.dta")digi_dta = digi_dta[digi_dta['国民经济行业代码'].notna() & (digi_dta['国民经济行业代码'] != "")]# 提取 3 位前缀(匹配 CSV 行业中类代码后 3 位数字)digi_prefixes = set(digi_dta['国民经济行业代码'].str[:3].unique())digi_codes_4d = set(digi_dta['国民经济行业代码'].unique())《数字经济及其核心产业统计分类(2021)》使用 4 位行业代码,而工商注册信息 CSV 中的行业代码字段格式为 I641(中类)或 I6411(小类),均带有字母前缀。
代码的匹配策略如下:
| | |
|---|
行业小类代码 | code[1:5] | |
行业中类代码 | code[1:4] | |
优先使用小类代码,兜底使用中类代码,确保最大覆盖率。
步骤二:构建注销查找表
注销企业处理是整个计算中最关键的一步。
预构建查找表
代码要点:
usecols=['newgcid', '退出日期']:只读两列,大幅节省内存drop_duplicates(subset=['newgcid'], keep='first'):每个企业只保留最早的注销记录to_pickle(exit_pkl):缓存为 pickle 文件,多进程工人从磁盘按需加载,避免跨进程序列化开销
步骤三:单年聚合函数
函数设计
这是计算流程的核心函数,逻辑为:读取 → 过滤注销 → 识别数字产业 → 企业缩尾(注册资本版)→ 按城市聚合。
注册资本版与企业数量版的唯一区别在于:注册资本版在聚合前需做企业层面 Winsorize,企业数量版(计数)无需缩尾。以下以注册资本版为例说明。
五个步骤解析:
| | |
|---|
| pd.read_csv(..., usecols=...) | 只读必要列,单年文件可达 200MB+,列选择可节省 60% 内存 |
| dt[dt['exit_year'].isna() | (dt['exit_year'] > year_val)] | NaN 表示未注销;> year_val 表示当年末尚未退出 |
| dt['行业小类_数字'].isin(digi_codes_4d) | isin() |
| .clip(lower=p05, upper=p95) | 先于聚合,在企业个体层面截断极端注册资本,防止天价壳公司拉偏城市 |
| dt['注册资本'] * dt['is_digi'].astype(int) | 利用布尔→0/1转换,sum(注册资本 * is_digi) 即数字产业注册资本 |
并行执行
ProcessPoolExecutor.map() 等价于 R 的 future_map(),自动将任务分发到多个子进程并行执行。partial() 将固定参数绑定为偏函数,只将年份作为可变参数传入 map()。
关键区别(Python vs R):
| | |
|---|
future::plan(multisession) | ProcessPoolExecutor(max_workers=N) | |
furrr::future_map() | executor.map() | |
saveRDS() | to_pickle() | |
options(future.globals.maxSize) | | |
步骤四:构建面板与计算累计存量
补全面板并计算累计值
注册数据是流量(某年新注册的企业),而区位熵需要存量(截至该年仍存活的企业总量)。由于已在聚合前过滤了注销企业,这里只需按城市做累计加总即可。
关键函数对照:
| | |
|---|
CJ(a, b) | pd.MultiIndex.from_product([a, b]) | |
set(dt, i, j, value) | df[col].fillna(0) | |
cumsum(), by=city_code | groupby('city_code')[col].cumsum() | |
步骤五:计算区位熵与极端值处理
计算 DL
np.where() 是 Python 的向量化条件函数,等价于 R 的 fifelse()。这里对零分母做安全保护,避免产生 Inf。
Winsorize 处理极端值
本项目采用两层 Winsorize 策略:
- 企业层面(步骤三已完成):对每个年份内的企业注册资本做 5%/95% 截断
- 城市层面:对最终 DL 指标做 5%/95% 截断
dl_valid = panel_full['DL'].dropna()dl_valid = dl_valid[np.isfinite(dl_valid)]p05 = dl_valid.quantile(0.05)p95 = dl_valid.quantile(0.95)panel_full['DL_raw'] = panel_full['DL'] # 保留原始值供对比panel_full['DL'] = panel_full['DL'].clip(lower=p05, upper=p95).clip(lower=p05, upper=p95) 等价于 R 的 pmax(pmin(DL, p95), p05),一步到位完成 Winsorize 截断。
步骤六:合并城市名称与输出
从注册文件反查城市名称
city_map = pd.DataFrame(columns=['city_code', 'city_name'])for y insorted(reg_years, reverse=True): fpath = os.path.join(dir_reg, f"{y}.csv")ifnot os.path.exists(fpath): dt = pd.read_csv(fpath, usecols=['市', '市代码'], dtype={'市代码': str}, na_values=[''], keep_default_na=True) dt.columns = ['city_name', 'city_code'] dt = dt[dt['city_code'].notna() & (dt['city_code'] != "") & dt['city_name'].notna() & (dt['city_name'] != "") & (dt['city_name'] != " ")] dt = dt.drop_duplicates(subset=['city_code'], keep='first') dt = dt[~dt['city_code'].isin(city_map['city_code'])] city_map = pd.concat([city_map, dt], ignore_index=True)output = output.merge(city_map, left_on='citycode', right_on='city_code', how='left')保存为 DTA 文件
# Stata 15+ (version=118) 支持 Unicode 标签output['city_name'] = output['city_name'].fillna('') data_label='数据处理:微信公众号 RStata','stock_cap_total': '存量注册资本_万元','stock_cap_digi': '存量数字企业注册资本_万元',Python 的 to_stata() 使用 version=118(Stata 15+ 格式),支持 Unicode 变量标签。variable_labels 参数设置中文标签,在 Stata 中通过 describe 可以看到。列名必须为 ASCII,因此用英文列名 + 中文标签的组合。
以上所有计算步骤对应的完整代码参见附件中的 计算数字产业集聚度_注册资本版.py 和 计算数字产业集聚度_企业数量版.py,可直接在终端运行。
结果展示(2010–2012 示例)
以下直接读取已生成的结果文件进行展示。运行前请先执行上述 Python 脚本生成 DTA 文件。
读取计算结果
dt_cap = pd.read_stata("数字产业集聚度_注册资本_各城市.dta")dt_cnt = pd.read_stata("数字产业集聚度_企业数量_各城市.dta")print(f"注册资本版:{len(dt_cap)} 行,{dt_cap['citycode'].nunique()} 个城市,年份 {int(dt_cap['year'].min())}-{int(dt_cap['year'].max())}")print(f"企业数量版:{len(dt_cnt)} 行,{dt_cnt['citycode'].nunique()} 个城市,年份 {int(dt_cnt['year'].min())}-{int(dt_cnt['year'].max())}")描述性统计
print("========== 注册资本版 描述性统计 ==========")dl_cap = dt_cap['DL'].dropna()dl_cap = dl_cap[np.isfinite(dl_cap) & (dl_cap >= 0)]print(f"Mean: {dl_cap.mean():.4f} Median: {dl_cap.median():.4f} SD: {dl_cap.std():.4f}")print(f"Min: {dl_cap.min():.4f} Max: {dl_cap.max():.4f} N: {len(dl_cap)}")print("\n========== 企业数量版 描述性统计 ==========")dl_cnt = dt_cnt['DL'].dropna()dl_cnt = dl_cnt[np.isfinite(dl_cnt) & (dl_cnt >= 0)]print(f"Mean: {dl_cnt.mean():.4f} Median: {dl_cnt.median():.4f} SD: {dl_cnt.std():.4f}")print(f"Min: {dl_cnt.min():.4f} Max: {dl_cnt.max():.4f} N: {len(dl_cnt)}")Top-10 城市(2012 年)
print("========== 注册资本版 Top-10(2012 年)==========")top10_cap = dt_cap[dt_cap['year'] == 2012].nlargest(10, 'DL')for _, row in top10_cap.iterrows():print(f" {row['city_name']} DL={row['DL']:.3f} 注册资本_亿元={row['stock_cap_total']/1e4:.2f}")print("\n========== 企业数量版 Top-10(2012 年)==========")top10_cnt = dt_cnt[dt_cnt['year'] == 2012].nlargest(10, 'DL')for _, row in top10_cnt.iterrows():print(f" {row['city_name']} DL={row['DL']:.3f} 企业数={int(row['stock_n_total'])}")两种方法的 Top-10 城市排名存在差异,主要原因如下:
- 注册资本版更受大体量企业影响——若某城市少数几家高注册资本的数字企业占全国注册资本比例高,区位熵会被抬高
- 企业数量版更反映数字产业在城市中的普及度,对城市规模中性
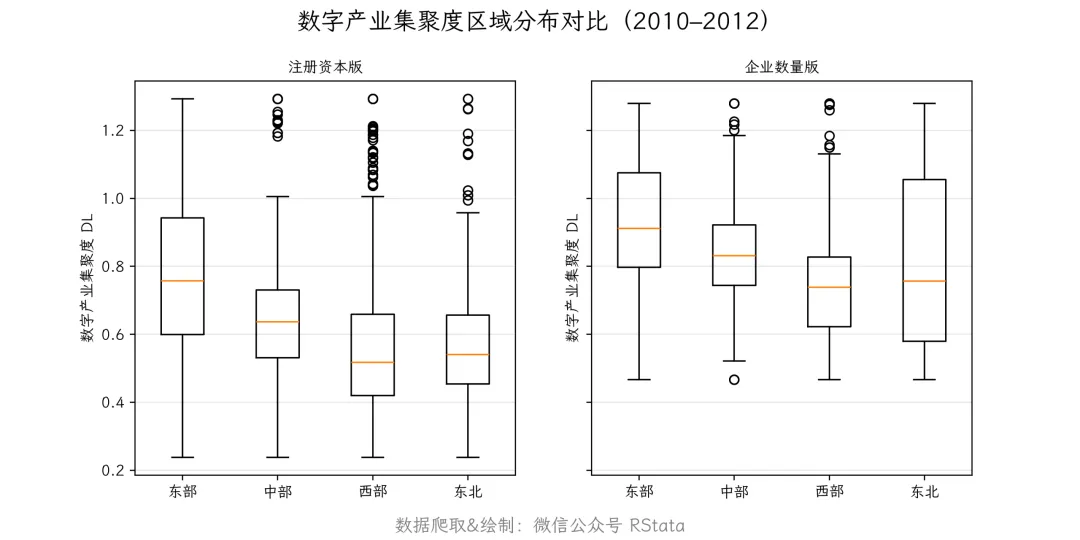
区域对比
与论文结果的对比
参考论文(屠西伟、史丹 2025)的结论,数字产业集聚度应呈现 东部 > 中部 > 西部 > 东北 的梯度格局。以示例数据计算的结果中:
- 差异之处:东北与西部的排序可能与论文相反,需要全量数据 + GDP 加权才能最终确认
可视化:区域对比
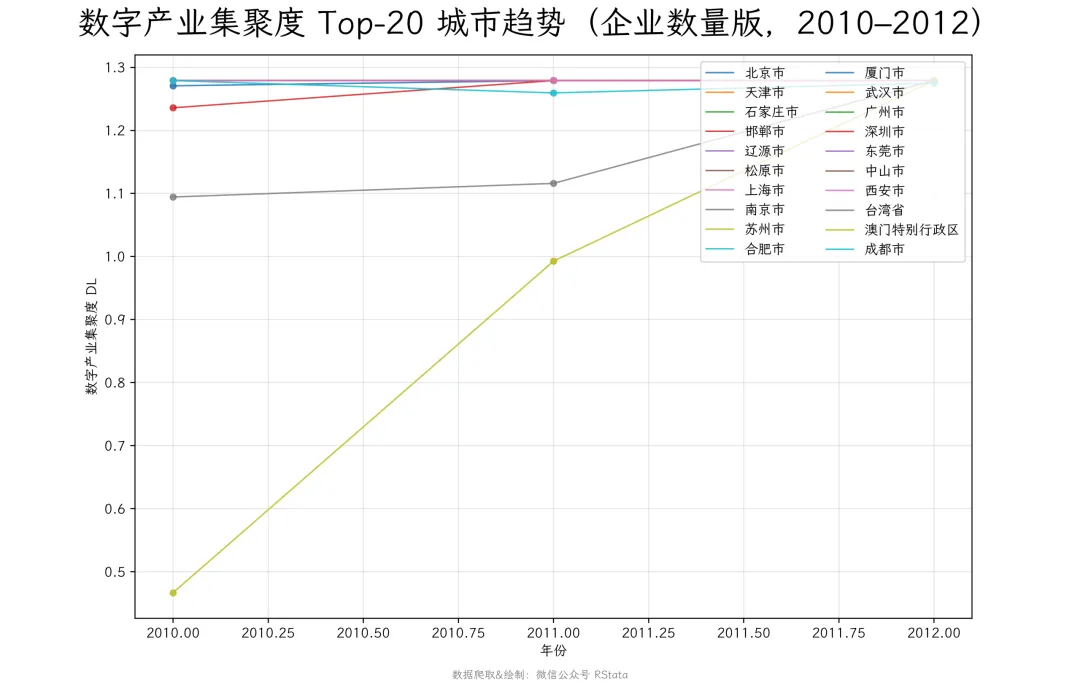
可视化:Top-20 城市趋势
latest = int(dt_cnt['year'].max())top_cities = dt_cnt[dt_cnt['year'] == latest].nlargest(20, 'DL')['citycode'].tolist()trend_dt = dt_cnt[dt_cnt['citycode'].isin(top_cities)]fig, ax = plt.subplots(figsize=(11, 7)) sub = trend_dt[trend_dt['citycode'] == city].sort_values('year') name = sub['city_name'].iloc[0] if'city_name'in sub.columns else city ax.plot(sub['year'], sub['DL'], label=name, linewidth=1.1, alpha=0.85) ax.scatter(sub['year'], sub['DL'], s=18, alpha=0.85)ax.set_xlabel('年份', fontproperties=font_prop)ax.set_ylabel('数字产业集聚度 DL', fontproperties=font_prop)fig.suptitle('数字产业集聚度 Top-20 城市趋势(企业数量版,2010–2012)', fontsize=24, fontproperties=font_prop, y=0.99)ax.legend(loc='upper right', fontsize=12, ncol=2, prop=font_prop)fig.text(0.5, 0.01, '数据爬取&绘制:微信公众号 RStata', fontsize=8, ha='center', va='bottom', color='gray', fontproperties=font_prop)plt.subplots_adjust(top=0.92, bottom=0.10)如何参加课程?
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/99121a81bb3840cdb4007238fc322022