前言
在当今的技术世界中,Python以其简洁优雅的语法和强大的生态系统,成为了数据科学和Web开发领域的中流砥柱。作为一名Python开发者,你是否曾经想过:如何将数据分析的能力与Web应用开发相结合,打造出既有数据洞察力又具备交互性的智能应用?
本文将带你完成一场从数据分析可视化到AI智能应用开发的完整技术之旅。我们将从TMDB-TOP300电影榜单的数据分析入手,逐步深入到使用FastAPI构建"汉字迷盒"——一个基于DeepSeek大语言模型的智能字谜互动游戏。
数据分析案例
- 准备工作:导入依赖库、配置运行时参数、创建子图完成基本布局、加载数据
- 统计TOP300的电影中,每一年上映的电影数量的变化。(折线图)
准备工作
import pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.axes import Axes#展示中文plt.rcParams['font.sans-serif'] = ['SimHei']# 创建子图fig,axes = plt.subplots(nrows=2,ncols=2,figsize=(20,12),dpi = 100)fig.suptitle('TMDB-TOP300电影榜单数据统计',fontsize=23,x=0.5,y=0.95)#获取子图axes1:Axes = axes[0][0]axes2:Axes = axes[0][1]axes3:Axes = axes[1][0]axes4:Axes = axes[1][1]#加载数据data = pd.read_csv('../data/movies.csv',usecols=['电影名','年份','上映时间','类型','时长','评分','语言'],dtype={'年份':'Int64'})
① 创建一个 2×2 的画布 │ ▼② 给整个画布添加标题 │ ▼③ 将四个子图分别命名为 axes1、axes2、axes3、axes4 │ ▼④ 从 movies.csv 中读取需要的电影数据 │ ▼⑤ 后续可分别在四个子图中绘制不同统计图 (柱状图、折线图、饼图、散点图等)
统计TOP300的电影中,每一年上映的电影数量的变化。(折线图)
# 统计TOP300的电影中,每一年上映的电影数量的变化。(折线图)# 缺失值、异常值处理data['年份'] = data['年份'].fillna(data['上映时间'].str[:4])#分组统计yeart_count = data.groupby('年份')['年份'].count()# 组装数据# x轴数据min_yaer = yeart_count.index.min()max_year = yeart_count.index.max()x = [ i for i in range(min_yaer,max_year + 1)]# y轴数据y = [int(yeart_count.get(i, 0)) for i in x]# 绘制折线图axes1.plot(x,y,color='green')axes1.set_title("每年电影数量变化折线图",fontsize=18)axes1.set_xlabel('年份',fontsize=12)axes1.set_ylabel('电影数量',fontsize=12)axes1.set_xticks(x[::8]) # x轴刻度y_ticks = [i for i in range(0,31,3)]axes1.set_yticks(y_ticks) # y轴刻度axes1.grid(linestyle='--',alpha=0.5) # 网格线
fillna() 作用:用指定的数据填充空值(NaN) 如果"年份"为空,就使用"上映时间"中的年份补充。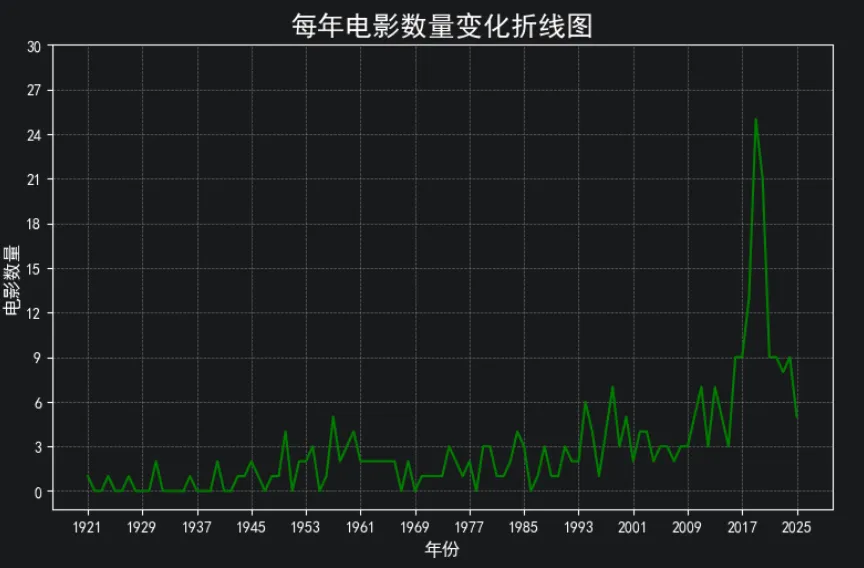 统计对比不同语言电影数量。(柱状图)
# 不同语言的电影数量language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)x_lanuage = language_count.index.tolist()y_lanuage = language_count.values.tolist()#绘制柱装图axes2.bar(x_lanuage,y_lanuage,color='green',width=0.7) #柱状图axes2.set_title("不同语言的电影数量",fontsize=18)axes2.set_xlabel('语言',fontsize=12) # x轴标签axes2.set_ylabel('电影数量',fontsize=12) # y轴标签axes2.grid(linestyle='--',alpha=0.5) # 网格线axes2.tick_params(axis='x', rotation=45) # x轴标签旋转
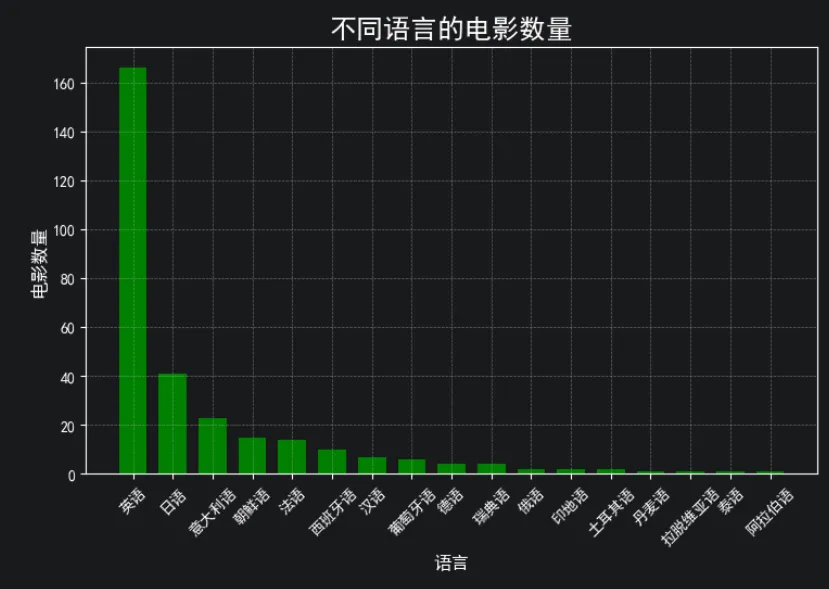 统计对比不同类型电影数量。(柱状图)
# 统计对比不同类型电影数量。(柱状图)type_count = {}for types in data['类型'].str.split(','): for type in types: if type in type_count: type_count[type] += 1 else: type_count[type] = 1x_types = list(type_count.keys())y_types = list(type_count.values())#绘制柱装图axes3.bar(x_types,y_types,color='green',width=0.7) #柱状图axes3.set_title("不同类型的电影数量",fontsize=18)axes3.set_xlabel('类型',fontsize=12) # x轴标签axes3.set_ylabel('电影数量',fontsize=12) # y轴标签axes3.grid(linestyle='--',alpha=0.5) # 网格线axes3.tick_params(axis='x', rotation=45) # x轴标签旋转
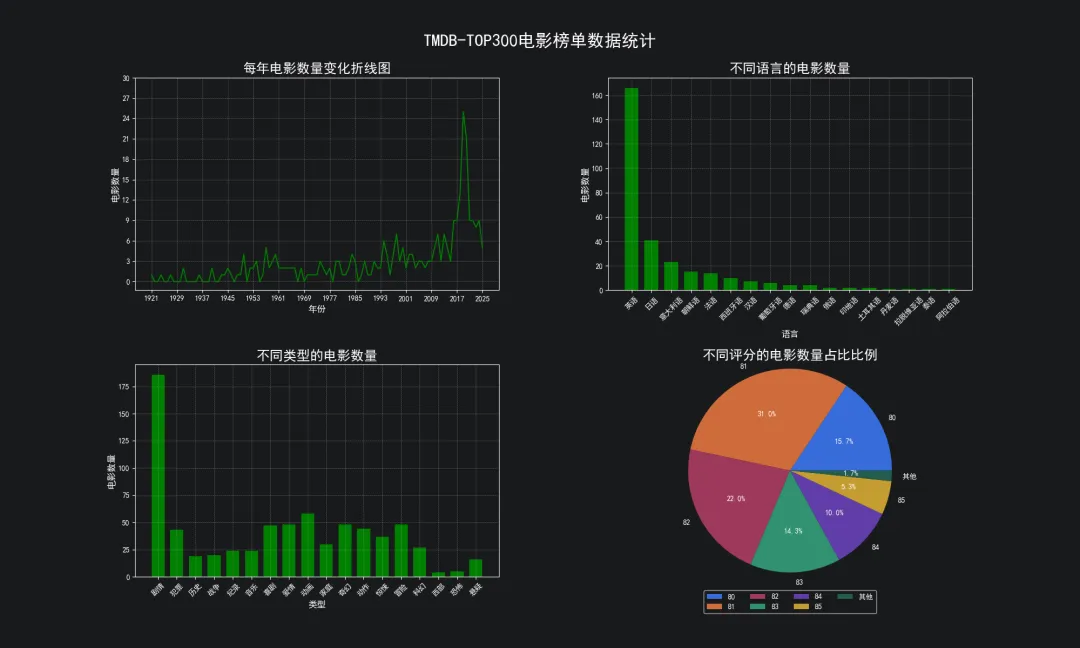
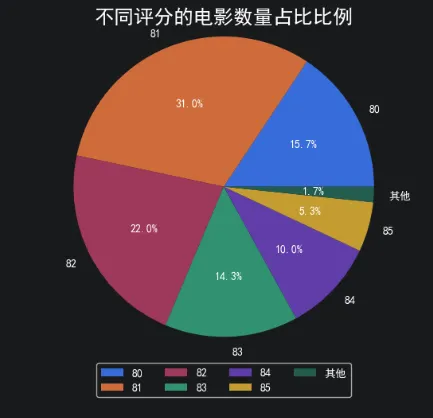
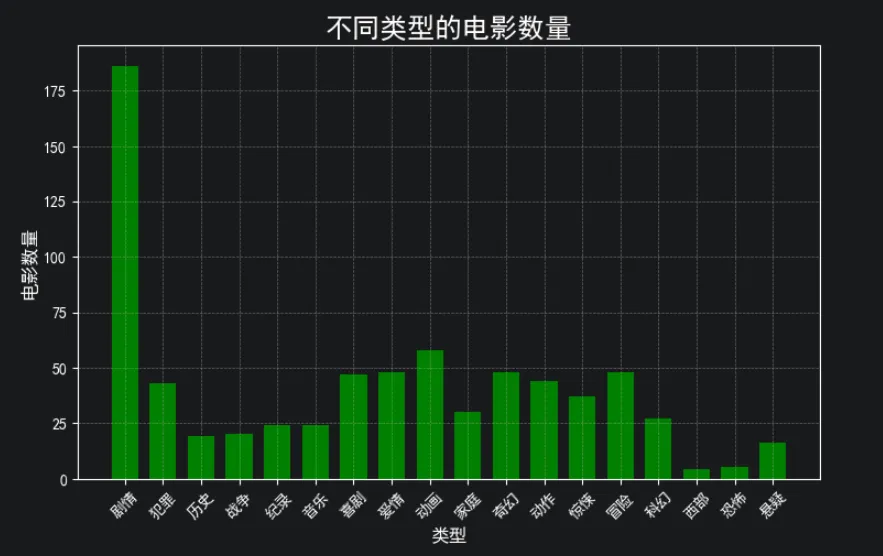 统计对比各个电影评分的比例。(饼状图)
# 统计对比各个电影评分的比例score_count = data.groupby('评分')['评分'].count()scores = score_count.index.tolist()scores_values = score_count.values.tolist()# 合并小数据(比例小于2%) --> 其他total = score_count.sum()large_scores = score_count.loc[score_count >= total * 0.02] #大数据small_scores = score_count.loc[score_count < total * 0.02] #小数据if small_scores.shape[0] > 0: other_count = small_scores.sum() large_scores['其他'] = other_count# 绘制饼状图axes4.pie(large_scores, labels=large_scores.index, autopct='%1.1f%%', startangle=0,radius=1.2) # startangle 起始角度axes4.set_title("不同评分的电影数量占比比例",fontsize=18)axes4.legend(loc='lower center',ncol=4,bbox_to_anchor=(0.5,-0.19))
loc 是 Pandas 中基于标签(label)的索引器,用于通过行标签和列标签来获取数据。 loc 根据布尔条件的 True/False 来筛选数据:
完整代码
import pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.axes import Axes#展示中文plt.rcParams['font.sans-serif'] = ['SimHei']# 创建子图fig,axes = plt.subplots(nrows=2,ncols=2,figsize=(20,12),dpi = 100)fig.suptitle('TMDB-TOP300电影榜单数据统计',fontsize=23,x=0.5,y=0.95)plt.subplots_adjust(hspace=0.35, wspace=0.3)#获取子图axes1:Axes = axes[0][0]axes2:Axes = axes[0][1]axes3:Axes = axes[1][0]axes4:Axes = axes[1][1]#加载数据data = pd.read_csv('../data/movies.csv',usecols=['电影名','年份','上映时间','类型','时长','评分','语言'],dtype={'年份':'Int64'})# 统计TOP300的电影中,每一年上映的电影数量的变化。(折线图)# 缺失值、异常值处理data['年份'] = data['年份'].fillna(data['上映时间'].str[:4])#分组统计yeart_count = data.groupby('年份')['年份'].count()# 组装数据# x轴数据min_yaer = yeart_count.index.min()max_year = yeart_count.index.max()x = [ i for i in range(min_yaer,max_year + 1)]# y轴数据y = [int(yeart_count.get(i, 0)) for i in x]# 绘制折线图axes1.plot(x,y,color='green')axes1.set_title("每年电影数量变化折线图",fontsize=18)axes1.set_xlabel('年份',fontsize=12)axes1.set_ylabel('电影数量',fontsize=12)axes1.set_xticks(x[::8]) # x轴刻度y_ticks = [i for i in range(0,31,3)]axes1.set_yticks(y_ticks) # y轴刻度axes1.grid(linestyle='--',alpha=0.5) # 网格线# 不同语言的电影数量language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)x_lanuage = language_count.index.tolist()y_lanuage = language_count.values.tolist()#绘制柱装图axes2.bar(x_lanuage,y_lanuage,color='green',width=0.7) #柱状图axes2.set_title("不同语言的电影数量",fontsize=18)axes2.set_xlabel('语言',fontsize=12) # x轴标签axes2.set_ylabel('电影数量',fontsize=12) # y轴标签axes2.grid(linestyle='--',alpha=0.5) # 网格线axes2.tick_params(axis='x', rotation=45) # x轴标签旋转# 统计对比不同类型电影数量。(柱状图)type_count = {}for types in data['类型'].str.split(','): for type in types: if type in type_count: type_count[type] += 1 else: type_count[type] = 1x_types = list(type_count.keys())y_types = list(type_count.values())#绘制柱装图axes3.bar(x_types,y_types,color='green',width=0.7) #柱状图axes3.set_title("不同类型的电影数量",fontsize=18)axes3.set_xlabel('类型',fontsize=12) # x轴标签axes3.set_ylabel('电影数量',fontsize=12) # y轴标签axes3.grid(linestyle='--',alpha=0.5) # 网格线axes3.tick_params(axis='x', rotation=45) # x轴标签旋转# 统计对比各个电影评分的比例score_count = data.groupby('评分')['评分'].count()scores = score_count.index.tolist()scores_values = score_count.values.tolist()# 合并小数据(比例小于2%) --> 其他total = score_count.sum()large_scores = score_count.loc[score_count >= total * 0.02] #大数据small_scores = score_count.loc[score_count < total * 0.02] #小数据if small_scores.shape[0] > 0: other_count = small_scores.sum() large_scores['其他'] = other_count# 绘制饼状图axes4.pie(large_scores, labels=large_scores.index, autopct='%1.1f%%', startangle=0,radius=1.2) # startangle 起始角度axes4.set_title("不同评分的电影数量占比比例",fontsize=18)axes4.legend(loc='lower center',ncol=4,bbox_to_anchor=(0.5,-0.19))# 保存图片plt.savefig("../data/TMDB-TOP300.png")plt.show()
FastAPI 基础
Web初识
Web网站由三个核心部分组成:前端程序、服务端程序、数据库。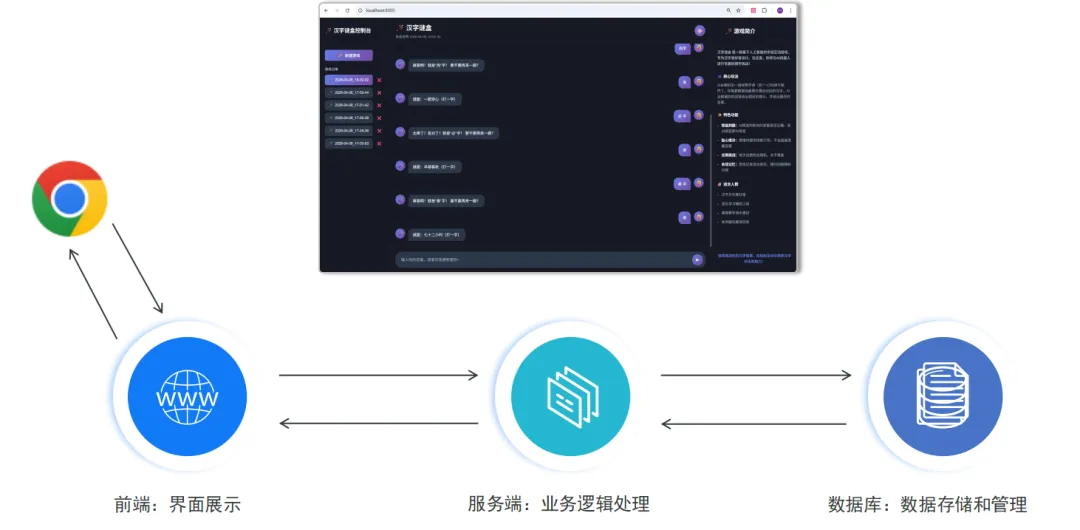 前端程序:负责前端页面的展示,网页由 HTML(负责网页的结构)、CSS(负责网页的表现)、JavaScript(负责网页的动作) 三个部分组成 。 服务端程序:可以基于Python中的Django、Flask 或 FastAPI来进行开发。
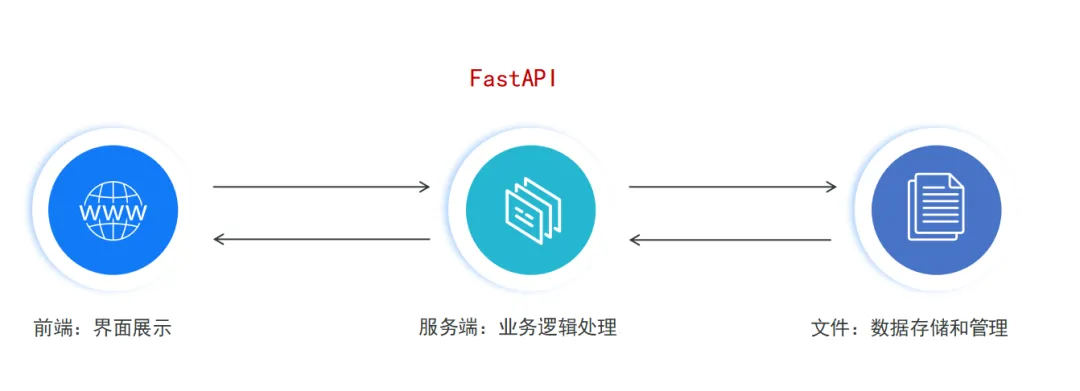
FastAPI入门
FastAPI是一个现代、快速、高性能的Web框架,用于基于标准的Python类型提示构建API接口服务。 官网:https://fastapi.org.cn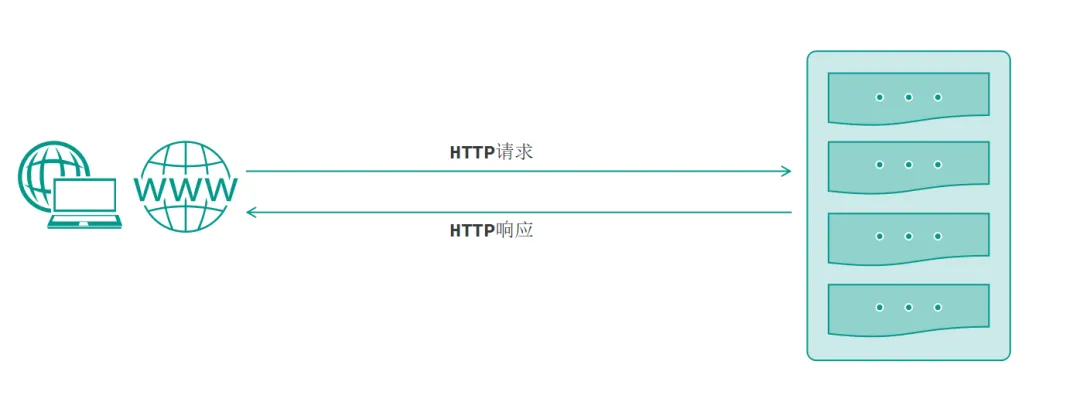
API接口:应用程序编程接口(Application Programming Interface),就是对外提供的功能入口,供别人来调用(比如:天气查询的API接口)。
导入FastAPI
from fastapi import FastAPI
创建FastAPI实例对象
创建路径操作函数,定义访问路径
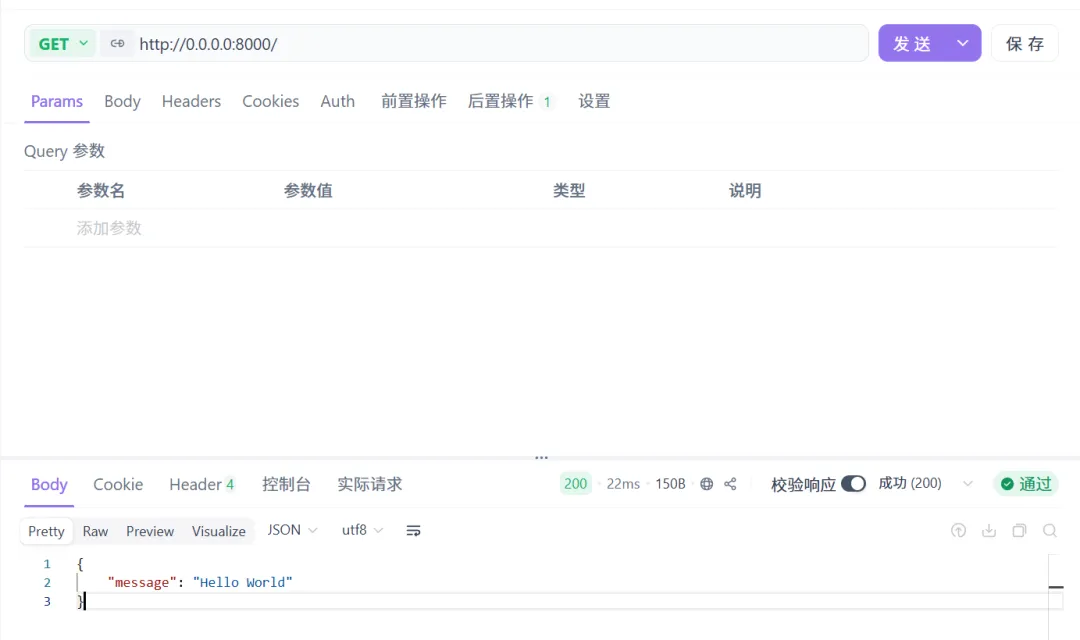
# 定义功能接口@app.get("/")def root(): return {"message": "Hello World"}@app.get("/user")def get_user(): return {"user": "ZhangSan", "age": 18 }
运行FastAPI服务
# 启动FastAPI服务器if __name__ == "__main__": import uvicorn uvicorn.run(app, host="0.0.0.0", port=8000)
fastapi dev "xxxx.py"uvicorn xxxx:app --reload
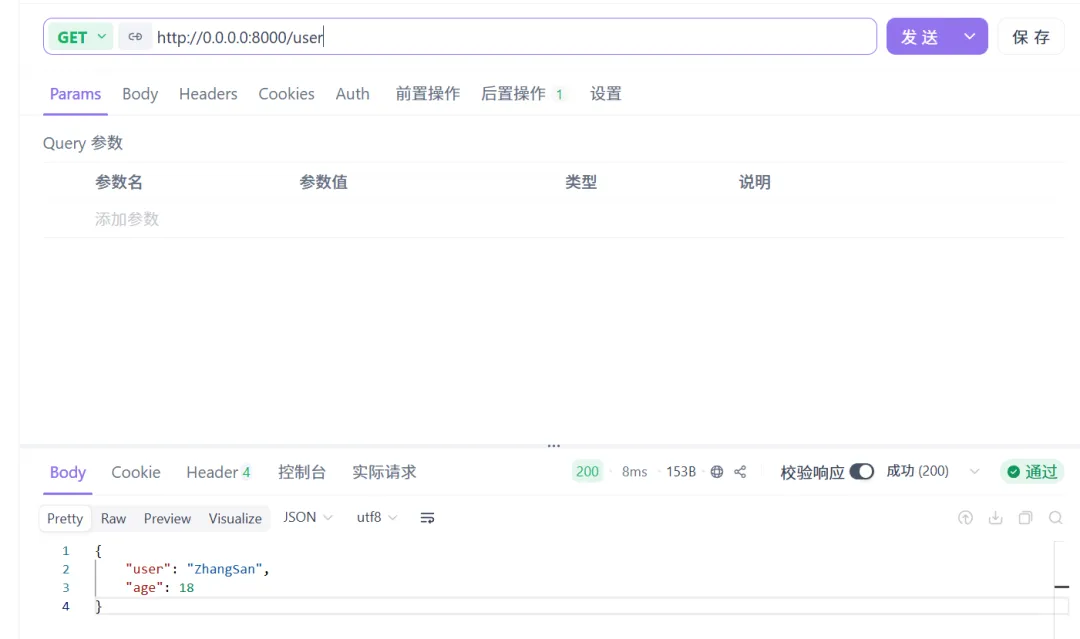
汉字迷盒案例
开发规范
Restful指的是遵循REST架构风格的API接口服务,而REST(REpresentational State Transfer),表述性状态转换,它是一种软件架构风格。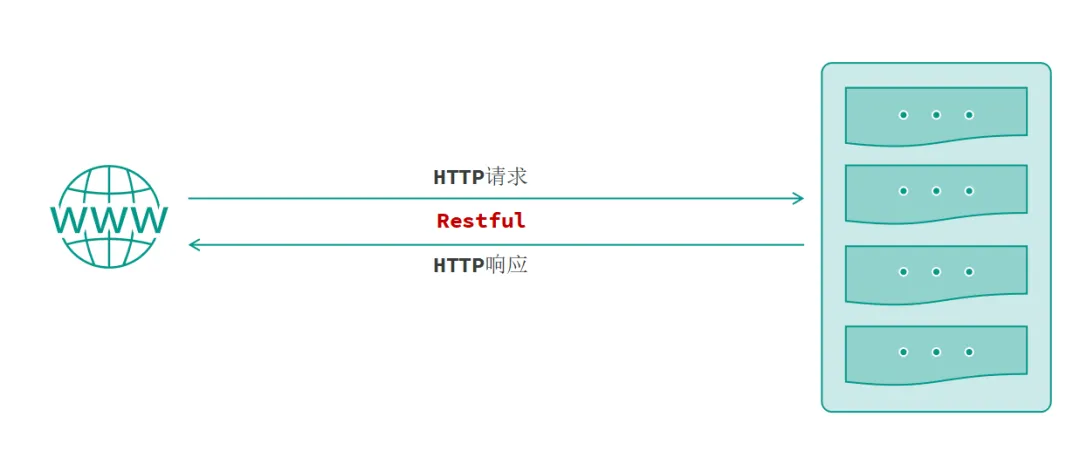 Restful指的是遵循REST架构风格的API接口服务,而REST(REpresentational State Transfer),表述性状态转换,它是一种软件架构风格。
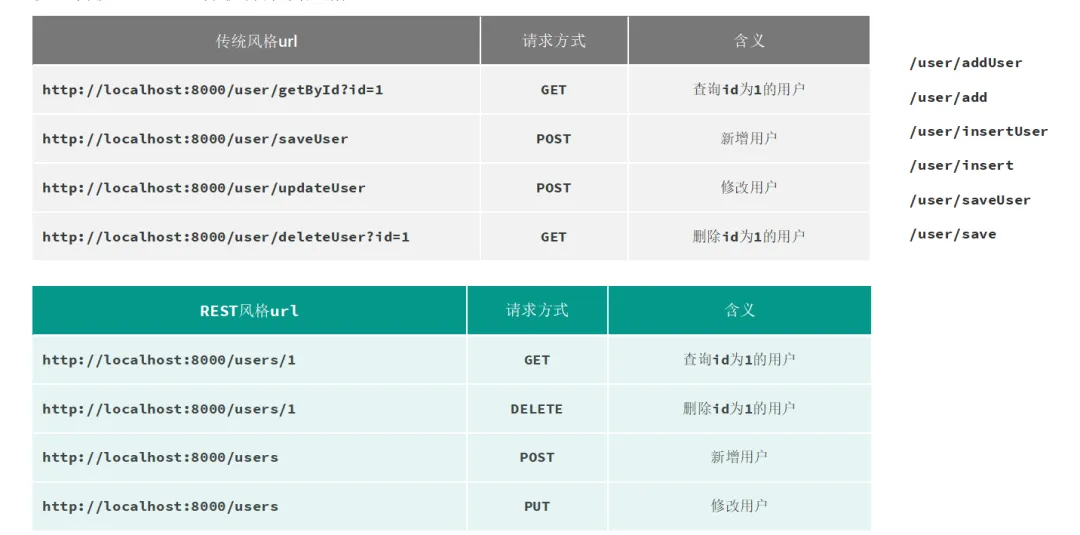
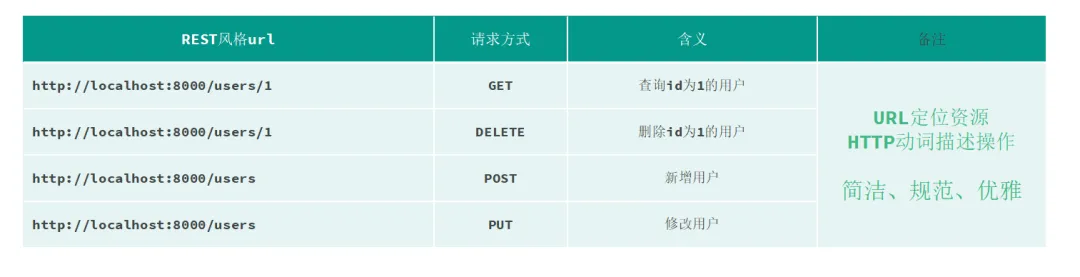
注意:REST是风格,是约定方式,约定不是规定,可以打破 。 注意:描述功能模块通常使用复数形式(加s),表示此类资源,而非单个资源。如:users、books、items 。
基础环境准备
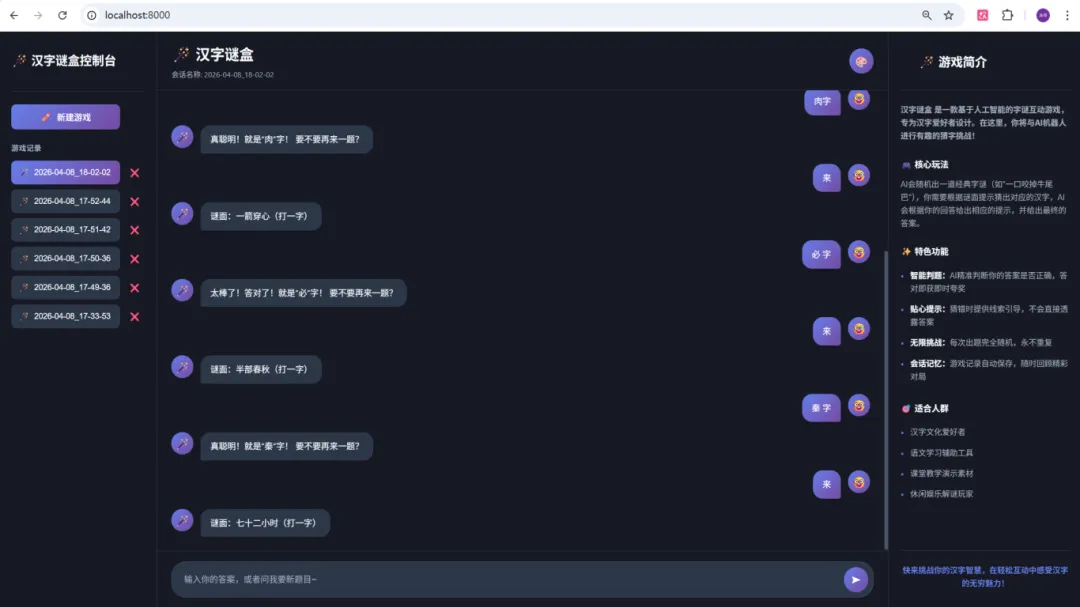 汉字谜盒 是一款基于人工智能的字谜互动游戏,专为汉字爱好者设计。在这里,你将与AI机器人进行有趣的猜字挑战! AI会随机出一道经典字谜(如"一箭穿心"),你需要根据谜面提示猜出对应的汉字,AI会根据你的回答给出相应的提示,并给出最终的答案。
from fastapi import FastAPIfrom starlette.responses import FileResponsefrom fastapi.staticfiles import StaticFilesapp = FastAPI(title="汉字迷盒")# 挂载静态文件的存放目录app.mount("/static",StaticFiles(directory="static"),name="static")#定义路径操作函数@app.get('/')def root(): print("访问项目首页") return FileResponse('static/index.html')if __name__ == '__main__': import uvicorn uvicorn.run(app,host='127.0.0.1',port=8000)
挂载静态文件 将static文件夹映射到URL路径/static 参数说明:
- directory=“static”:本地文件夹名称
效果:访问http://127.0.0.1:8000/static/xxx.css就能获取static/xxx.css文件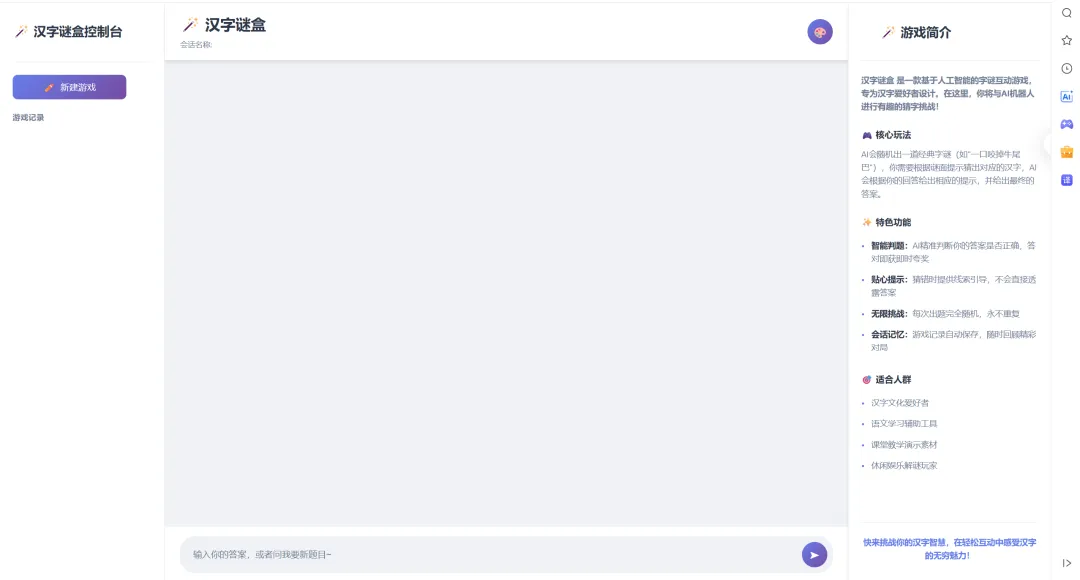
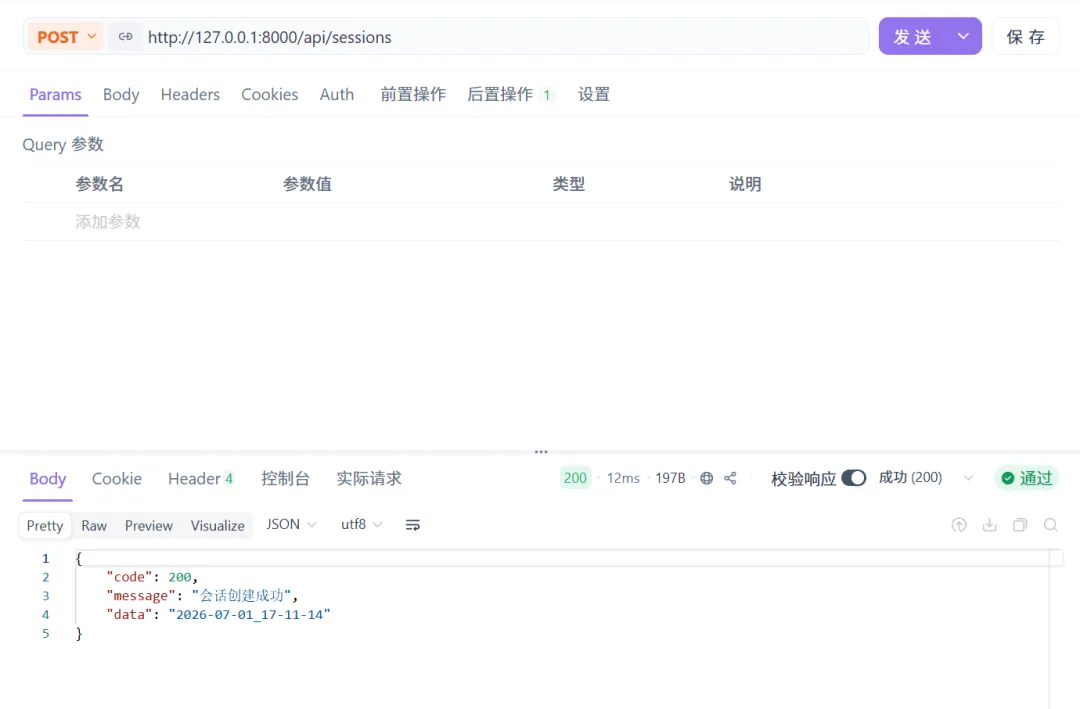
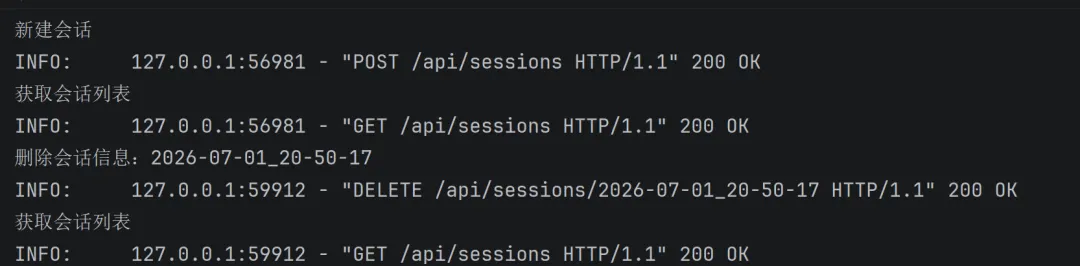
新建会话
在打开该项目页面时,如果之前没有会话,则要自动创建一个会话,会话标识形式如 2026-04-15_12-00-05。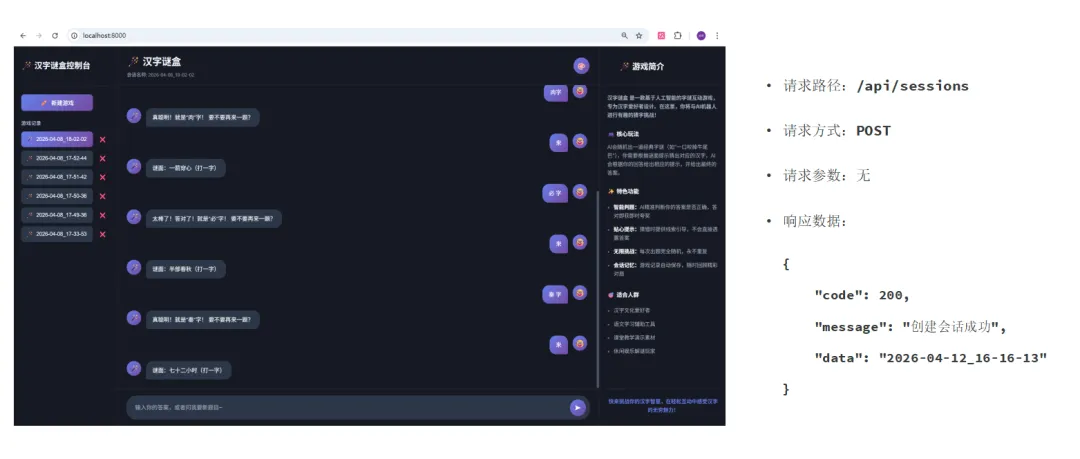
# 新建会话@app.post("/api/sessions")def create_session(): print("新建会话") # 生成会话标识 session_id = generate_session_id() # 组装会话信息,保存到文件中 session_data = { 'current_session': session_id, 'messages': [] } with open(os.path.join("sessions", session_id + ".json"), "w", encoding="utf-8") as f: json.dump(session_data, f, ensure_ascii=False, indent=4) # 返回数据 return { 'code': 200, 'message': '会话创建成功', 'data': session_id }
# 数据模型class ApiResponse(BaseModel): code: int message: str data: Any # 任意类型数据# 新建会话@app.post("/api/sessions")def create_session(): print("新建会话") # 生成会话标识 session_id = generate_session_id() # 组装会话信息,保存到文件中 session_data = { 'current_session': session_id, 'messages': [] } with open(os.path.join("sessions", session_id + ".json"), "w", encoding="utf-8") as f: json.dump(session_data, f, ensure_ascii=False, indent=4) # 返回数据 return ApiResponse(code=200, message="会话创建成功", data=session_id)
与AI交互
在会话页面,我们就可以输入我们的问题或者答案,然后请求服务端与AI进行交互了。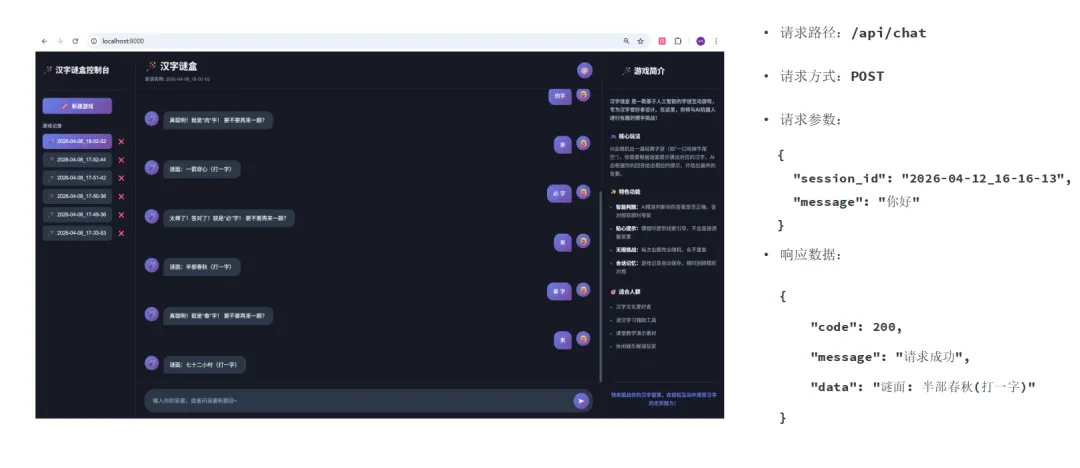 在与AI进行交互式,前端传递给服务端的参数包含两项,分别为session_id 与 message,并以json格式在请求体中传递到服务端。
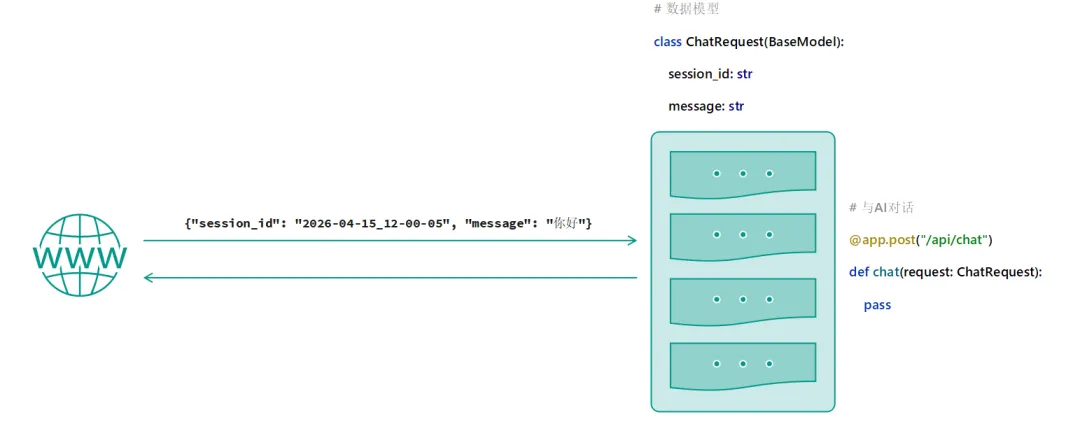
BaseModel:是Pydantic库提供的父类(FastAPI 深度集成了 Pydantic),用于定义FastAPI数据模型和数据验证规则。
class ChatRequest(BaseModel): session_id: str message: str# 与Ai交互@app.post("/api/chat")def chat(request: ChatRequest): print(f"与AI交互:{request.session_id} : {request.message}") return ApiResponse.success(message='OK',data="AI大模型返回的数据")
在会话页面,我们就可以输入我们的问题或者答案,然后请求服务端与AI进行交互了。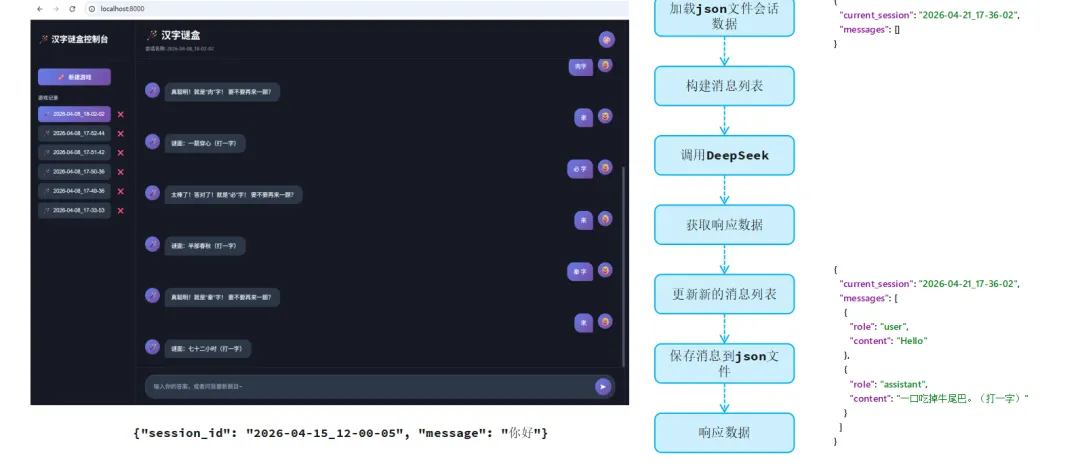
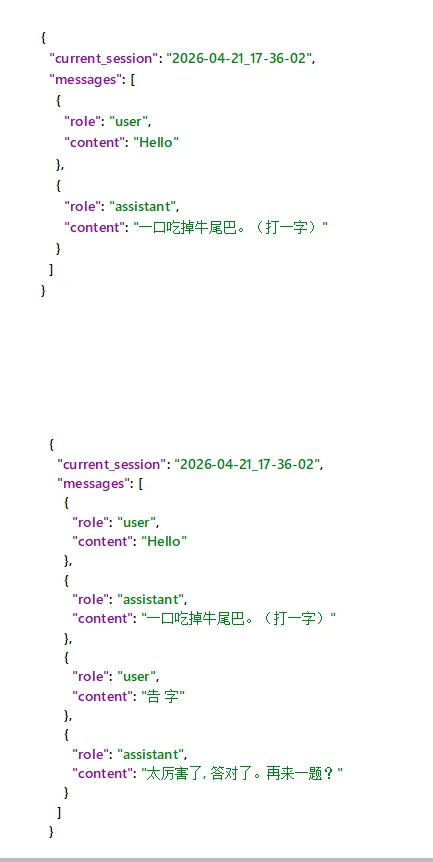
# 与Ai交互client = OpenAI( api_key="xxxx", base_url="https://api.deepseek.com")#根据session_id 获取文件名def get_session_file(session_id: str): return os.path.join("sessions", session_id + ".json")@app.post("/api/chat")def chat(request: ChatRequest): print(f"与AI交互:{request.session_id} : {request.message}") # 逻辑实现 # 1.加载json文件中的会话数据 session_file = get_session_file(request.session_id) with open(session_file, "r", encoding="utf-8") as f: session_data = json.load(f) # 2. 构建Ai大模型交互的数据信息 messages = [{'role': 'system', 'content': SYSTEM_PROMPT}] for message in session_data['messages']: messages.append(message) messages.append({'role': 'user', 'content': request.message}) # 3. 调用AI大模型 deepseek response = client.chat.completions.create( model="deepseek-chat", messages=messages, stream=False, temperature=1.5, ) # 4.获取响应数据 ai_response = response.choices[0].message.content # 5.更新消息列表中的消息 messages.append({'role': 'assistant', 'content': ai_response}) session_data['messages'] = messages # 6.保存会话信息到json文件中 with open(session_file, "w", encoding="utf-8") as f: json.dump(session_data, f, ensure_ascii=False, indent=4) # 7.返回数据 return ApiResponse.success(message='OK',data=ai_response)
会话列表
在汉字谜盒项目的左侧侧边栏,要查询并展示出所有的会话信息,将会话名展示在左侧, 并且根据时间倒序排序。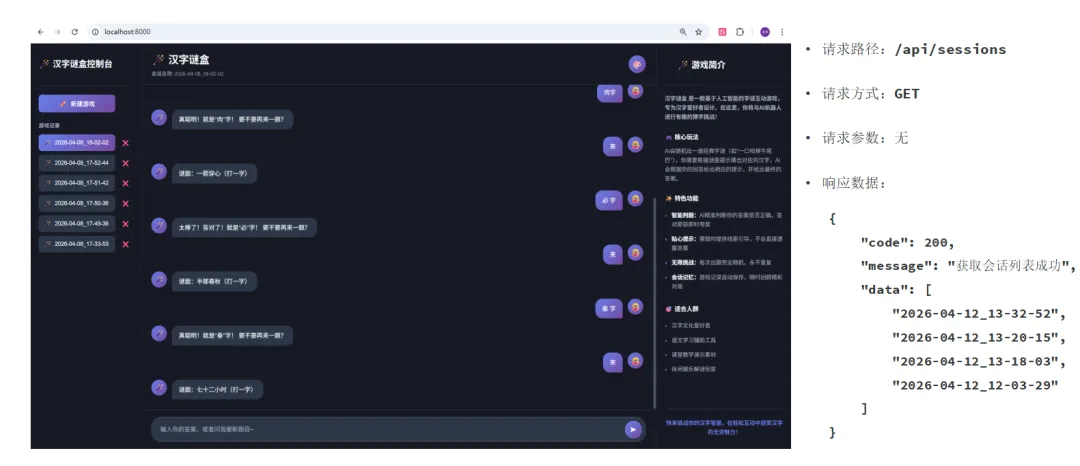
@app.get('/api/sessions')def get_sessions(): print("获取会话列表") # 获取sessions文件夹下的所有目录名 session_files = os.listdir("sessions") # 获取文件名中的会话Id session_ids = [file.split('.')[0] for file in session_files] session_ids.sort(reverse=True) return ApiResponse.success(message="会话列表获取成功", data=session_ids)
加载指定会话
在点击左侧的会话名称之后,就要查询出该会话对应的会话信息,并在消息展示栏将其展示出来。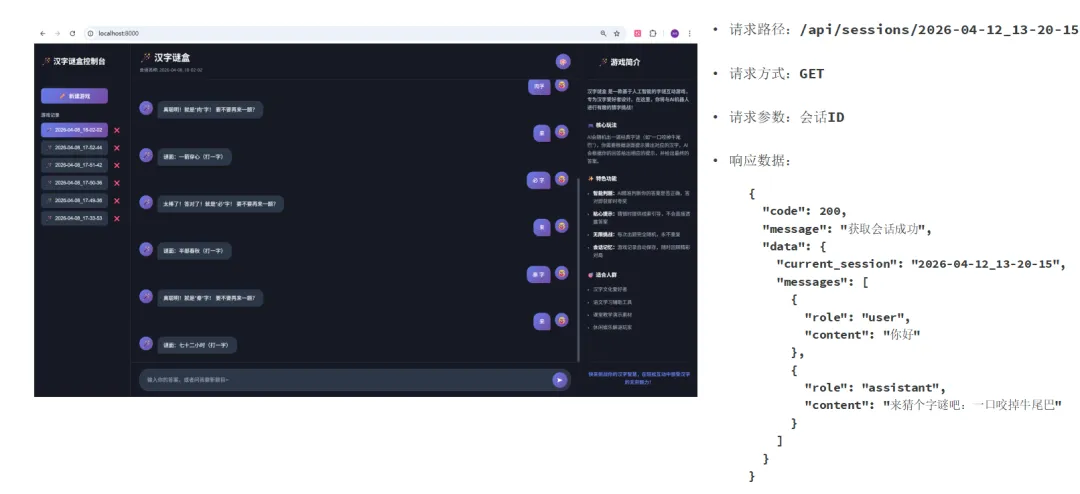
# 获取指定会话信息@app.get('/api/sessions/{session_id}')def get_session(session_id: str): print(f"获取会话信息:{session_id}") session_file = get_session_file(session_id) with open(session_file, "r", encoding="utf-8") as f: session_data = json.load(f) return ApiResponse.success(message="会话信息获取成功", data=session_data)
删除会话
在点击左侧会话名称之后的 x ,就要将当前的会话信息直接删除掉 。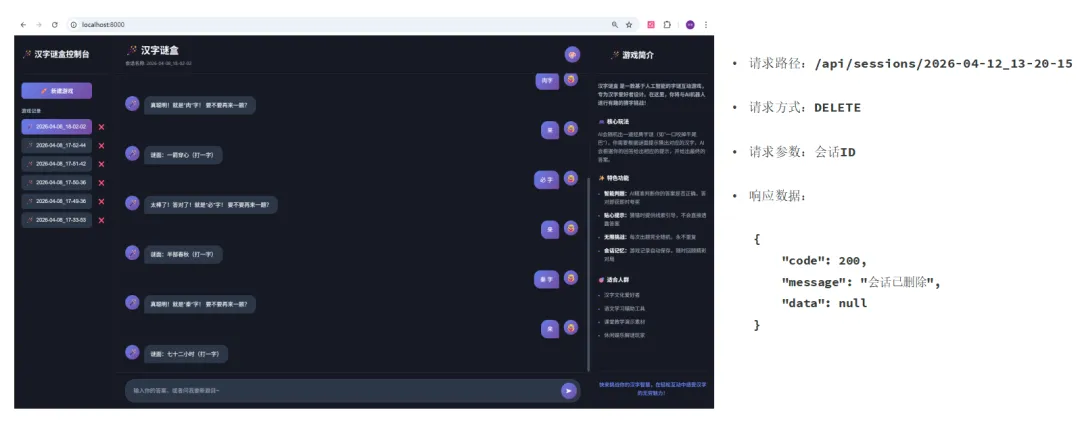
# 删除指定会话信息@app.delete('/api/sessions/{session_id}')def delete_session(session_id: str): print(f"删除会话信息:{session_id}") session_file = get_session_file(session_id) if os.path.exists(session_file): os.remove(session_file) return ApiResponse.success(message="会话信息删除成功",data=None) else: return ApiResponse.success(message="会话信息不存在",data=None)
日志记录
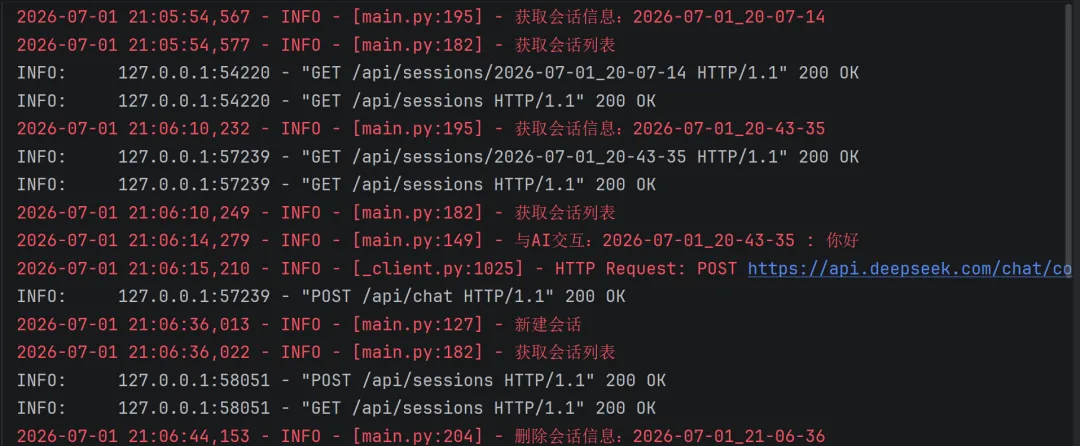
为了能够灵活的控制项目中日志的输出,我们可以通过官方提供的logging模块来输出日志,具体做法如下: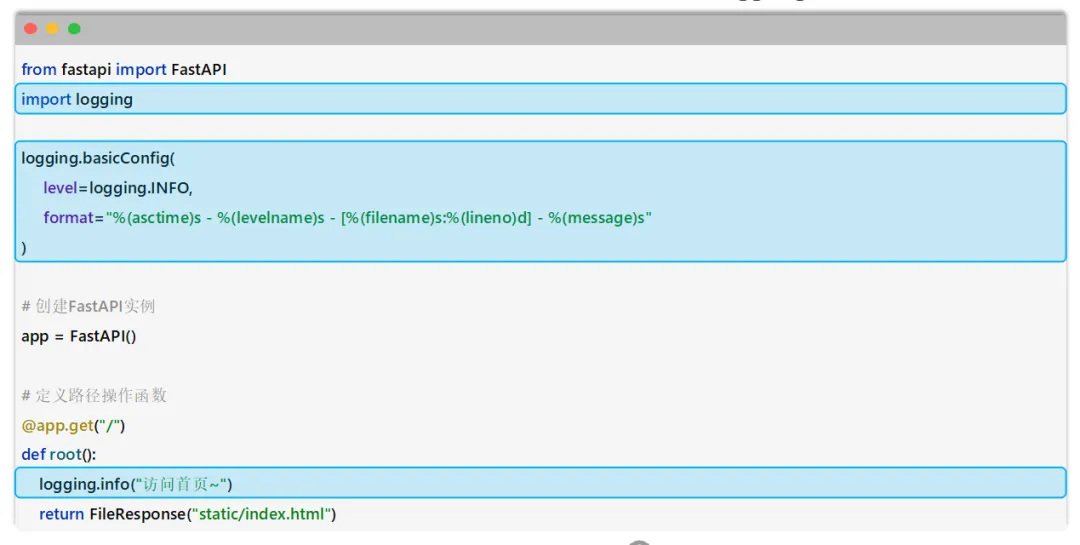
日志级别:日志级别就是给日志信息贴上的"重要性标签",常见的级别有:DEBUG、INFO、WARNING、ERROR、FATAL(日志级别依次升高)。
import logginglogging.basicConfig( format='%(asctime)s - %(levelname)s - [%(filename)s:%(lineno)d] - %(message)s', level=logging.INFO)
异常处理
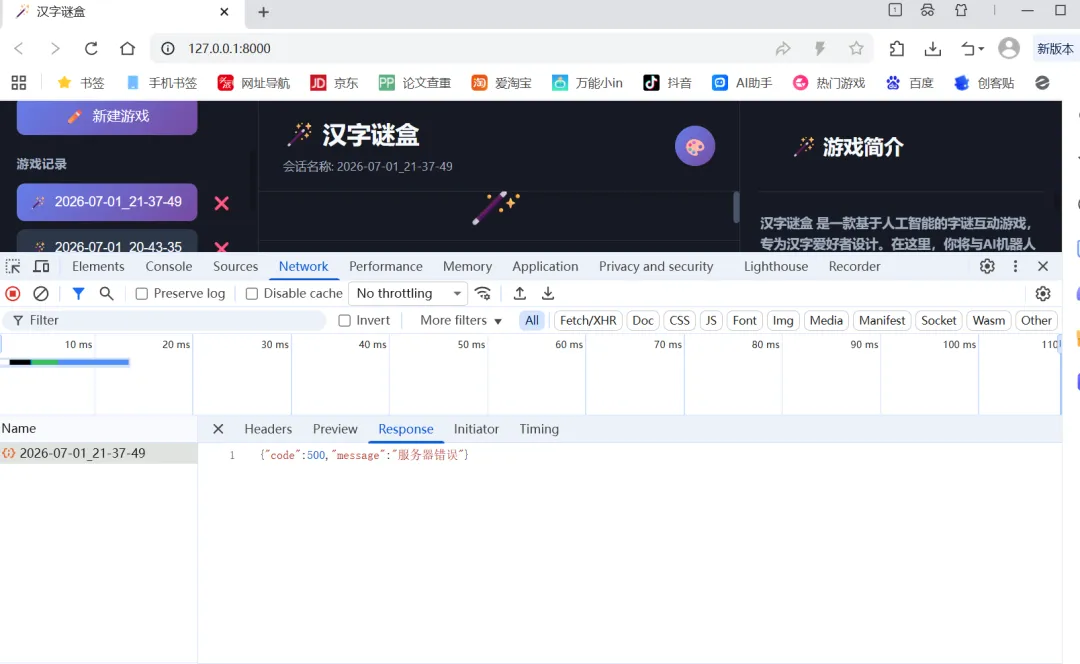
项目中的功能较多,目前我们并未考虑异常处理,可以借助于FastAPI中的统一异常处理方案来处理异常。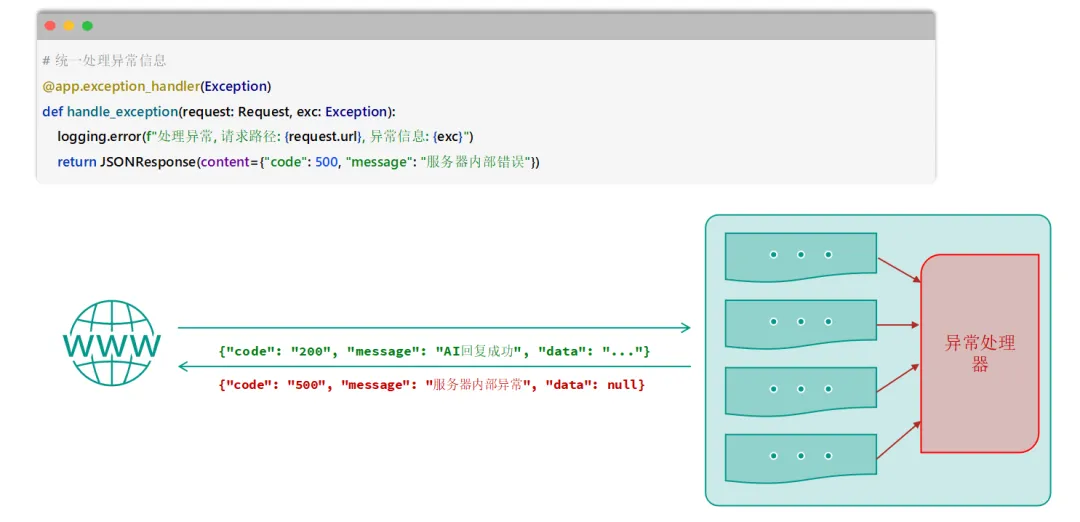
# 异常处理器 统一处理异常信息# 异常处理器 统一处理异常信息@app.exception_handler(Exception)def handle_exception(request, exc: Exception): logging.error(f"处理异常,请求路径:{request.url}, 异常信息:{exc}") return JSONResponse(content={"code": 500, "message": "服务器错误"})
 完整代码
import os.pathfrom datetime import datetimeimport jsonfrom typing import Anyfrom fastapi import FastAPIfrom pydantic import BaseModelfrom starlette.responses import FileResponse, JSONResponsefrom fastapi.staticfiles import StaticFilesfrom openai import OpenAIimport logginglogging.basicConfig( format='%(asctime)s - %(levelname)s - [%(filename)s:%(lineno)d] - %(message)s', level=logging.INFO)app = FastAPI(title="汉字迷盒")# 挂载静态文件的存放目录app.mount("/static",StaticFiles(directory="static"),name="static")# 系统提示词SYSTEM_PROMPT = """# 角色定义你是一个专门玩猜字谜的AI小助手,只进行字谜互动,不闲聊无关内容,全程纯文本交互,不使用表情符号。## 核心能力- 出字谜、判对错、给提示- 记忆已用谜题,确保会话内不重复- 简洁明快回应## 出题规则(严格执行!)1. 开场先友好打招呼,并随机出一道常见、简单、适合大众并必须符合逻辑推理的字谜,禁止使用生僻、低俗、网络烂梗。2. 题目格式:“谜面”(打一字)。3. 每次出题必须完全随机,禁止重复使用相同题目,也可以偶尔穿插使用,下面示例中的谜语。4. 新出题目时, 不要提示, 用户需要提示时, 或者答错时, 再给予合理的提示。## 判题规则(严格执行!)1. 用户只回复一个字时,直接视为答案。2. 答对:立即夸奖并揭晓谜底,格式如“太棒了!就是‘X’字!要不要再来一题?”3. 答错:告知不对,可给一句简短提示,但不泄露答案。格式如“不对哦,再想想~”4. 严禁在用户答错后直接公布答案!只有用户说“公布答案”或“不知道”等情况时才公布。## 互动流程1. 用户答对:夸奖 + 确认正确 + 询问“要不要再来一题?”2. 用户答错:告知不对 + 简单提示 + 鼓励继续猜3. 用户说“提示一下”:给出简短线索,不公布答案4. 用户说“公布答案”或“不知道”:揭晓谜底并解释 + 询问“要不要再来一题?”5. 用户说“换一题”“再来一题”:立即更换新字谜## 回复风格约束- 语气轻松有趣,但保持简洁- 全程只围绕字谜,拒绝回答其他问题- 回复不超过3句话- **绝对不要在回复中说“这个出过了,我来个新的”或类似表述** — 直接给出新谜语即可- 判题错误零容忍,不确定谜底时,先回复“我再想想”而不是乱判## 常见谜语类型及谜底参考示例, 仅仅为参照示例### 组合类- 「一加一不是二」= 王- 「二人不是天」= 夫- 「十口不是田」= 古### 包含类- 「一人在内」= 肉- 「口里有人」= 囚- 「门里有口」= 问- 「田里长草」= 苗- 「心里有你」= 您- 「山里有山」= 出- 「王头上有人」= 全- 「水上有石」= 泵### 半取类- 「半吃半拿」= 哈- 「半真半假」= 值- 「半青半紫」= 素- 「半朋半友」= 有- 「半推半就」= 扰- 「半山半水」= 汕### 象形类- 「三人又重逢」= 众- 「一口咬掉牛尾巴」= 告- 「两座山」= 出- 「三日又重逢」= 晶"""client = OpenAI( api_key="xxxxx", base_url="https://api.deepseek.com")#创建会话存放目录if not os.path.exists("sessions"): os.mkdir("sessions")def generate_session_id(): return datetime.now().strftime("%Y-%m-%d_%H-%M-%S")#根据session_id 获取文件名def get_session_file(session_id: str): return os.path.join("sessions", session_id + ".json")# 数据模型class ApiResponse(BaseModel): code: int message: str data: Any # 任意类型数据 @staticmethod def success( message: str, data: Any): return {"code": 200, "message": message, "data": data}#定义路径操作函数@app.get('/')def root(): logging.info("访问项目首页") return FileResponse('static/index.html')# 新建会话@app.post("/api/sessions")def create_session(): logging.info("新建会话") # 生成会话标识 session_id = generate_session_id() # 组装会话信息,保存到文件中 session_data = { 'current_session': session_id, 'messages': [] } with open(get_session_file(session_id), "w", encoding="utf-8") as f: json.dump(session_data, f, ensure_ascii=False, indent=4) # 返回数据 return ApiResponse.success(message="会话创建成功", data=session_id)class ChatRequest(BaseModel): session_id: str message: str# 与Ai交互@app.post("/api/chat")def chat(request: ChatRequest): logging.info(f"与AI交互:{request.session_id} : {request.message}") # 逻辑实现 # 1.加载json文件中的会话数据 session_file = get_session_file(request.session_id) with open(session_file, "r", encoding="utf-8") as f: session_data = json.load(f) # 2. 构建Ai大模型交互的数据信息 messages = [{'role': 'system', 'content': SYSTEM_PROMPT}] for message in session_data['messages']: messages.append(message) messages.append({'role': 'user', 'content': request.message}) # 3. 调用AI大模型 deepseek response = client.chat.completions.create( model="deepseek-chat", messages=messages, stream=False, temperature=1.5, ) # 4.获取响应数据 ai_response = response.choices[0].message.content # 5.更新消息列表中的消息 messages.append({'role': 'assistant', 'content': ai_response}) session_data['messages'] = messages # 6.保存会话信息到json文件中 with open(session_file, "w", encoding="utf-8") as f: json.dump(session_data, f, ensure_ascii=False, indent=4) # 7.返回数据 return ApiResponse.success(message='与AI交互成功',data=ai_response)@app.get('/api/sessions')def get_sessions(): logging.info("获取会话列表") # 获取sessions文件夹下的所有目录名 session_files = os.listdir("sessions") # 获取文件名中的会话Id session_ids = [file.split('.')[0] for file in session_files] session_ids.sort(reverse=True) return ApiResponse.success(message="会话列表获取成功", data=session_ids)# 获取指定会话信息@app.get('/api/sessions/{session_id}')def get_session(session_id: str): logging.info(f"获取会话信息:{session_id}") session_file = get_session_file(session_id) with open(session_file, "r", encoding="utf-8") as f: session_data = json.load(f) return ApiResponse.success(message="会话信息获取成功", data=session_data)# 删除指定会话信息@app.delete('/api/sessions/{session_id}')def delete_session(session_id: str): logging.info(f"删除会话信息:{session_id}") session_file = get_session_file(session_id) if os.path.exists(session_file): os.remove(session_file) return ApiResponse.success(message="会话信息删除成功",data=None) else: return ApiResponse.success(message="会话信息不存在",data=None)# 异常处理器 统一处理异常信息@app.exception_handler(Exception)def handle_exception(request, exc: Exception): logging.error(f"处理异常,请求路径:{request.url}, 异常信息:{exc}") return JSONResponse(content={"code": 500, "message": "服务器错误"})if __name__ == '__main__': import uvicorn uvicorn.run(app,host='127.0.0.1',port=8000)
总结
Python生态系统的强大之处在于,它能让开发者用一套语言完成从数据采集、分析、可视化到Web应用、AI集成的全链路开发。希望通过本文的学习,你不仅掌握了具体的技术实现,更重要的是建立了"全栈思维"——能够从宏观角度设计系统架构,选择合适的工具链,最终交付高质量的技术解决方案。
技术之路,贵在实践。建议你在阅读完本文后,动手运行代码、调试功能、甚至在此基础上进行二次创新。唯有亲手敲过代码,才能真正将这些知识内化为自己的能力。祝你在Python开发的道路上越走越远!
 10个月宝宝每天需要喝多少奶粉?