Python 的数据结构看起来简单:list、tuple、set、dict。真正写业务代码时,难点不在记住方法名,而在选对容器。
同样是一组数据,你可以用列表保存顺序,用集合去重,用字典按键查找,用元组表达固定记录。容器选错,后面就会出现重复循环、复杂判断、性能下降和可读性变差。
这篇文档基于 Python 3.14 中文官方教程《5. 数据结构》整理。官方教程覆盖列表、列表推导式、del、元组、集合、字典、循环技巧、条件控制和序列比较。本文会在此基础上扩展常见实战:deque、Counter、defaultdict、排序 key、堆、浅拷贝、分组、去重、Top K 和日志分析。
先建立一张选择地图
 选择数据结构时,先问四个问题:
数据是否需要保持顺序?需要频繁按位置访问,就用 list 或 tuple。
数据是否需要修改?需要增删改,用 list;表达固定记录,用 tuple。
数据是否需要唯一性和成员检测?用 set。
数据是否天然是“键 → 值”?用 dict。
除此之外,标准库还有几类非常实用的专用容器:collections.deque 适合队列和滑动窗口,collections.Counter 适合计数,collections.defaultdict 适合分组聚合,heapq 适合优先级队列和 Top K。
列表:最常用的可变序列
官方教程先从 list 开始,因为列表是 Python 最常用的容器。它是有序、可变、按整数索引访问的序列。官方列出的核心方法包括 append、extend、insert、remove、pop、clear、index、count、sort、reverse、copy。
列表最适合这几类场景:
保存一串同类元素,例如用户 ID、日志行、商品对象。
需要按位置访问,例如 items[0]、items[-1]。
需要追加、排序、切片、批量构造。
users = ["alice", "bob", "carol"]users.append("dave")users.extend(["eric", "frank"])first = users[0]last_two = users[-2:]users.sort()
有一个设计点值得记住:会原地修改列表的方法通常返回 None。例如 append、sort、reverse。这能提醒你区分“修改原对象”和“生成新对象”。
numbers = [3, 1, 2]result = numbers.sort()print(numbers) # [1, 2, 3]print(result) # None
实战里,sorted(numbers) 更适合生成新列表,numbers.sort() 更适合原地更新。
raw_scores = [80, 95, 72]ranked = sorted(raw_scores, reverse=True)print(raw_scores) # [80, 95, 72]print(ranked) # [95, 80, 72]
列表做栈:天然合适
官方教程用 append 和 pop 演示了栈。栈是后进先出结构,列表末尾追加和弹出都很自然。
stack = []stack.append("parse")stack.append("validate")stack.append("save")while stack: step = stack.pop() print(step)
这类写法常见于撤销栈、深度优先搜索、括号匹配和表达式求值。
def is_valid_parentheses(text: str) -> bool: pairs = {")": "(", "]": "[", "}": "{"} stack = [] for char in text: if char in "([{": stack.append(char) elif char in pairs: if stack == [] or stack.pop() != pairs[char]: return False return stack == []
列表做队列:语义可以,性能绕路
官方教程提醒:列表也能做先进先出队列,但从列表开头插入或删除会移动后续元素。队列更适合 collections.deque。
from collections import dequequeue = deque(["task-1", "task-2"])queue.append("task-3")while queue: task = queue.popleft() print("handle", task)
经验规则很简单:栈用 list,队列用 deque。
列表推导式:把“构造新列表”写清楚
官方教程把列表推导式解释为一种更简洁的列表构造方式:对可迭代对象中的元素应用表达式,或筛选满足条件的元素。
squares = [x * x for x in range(10)]even_squares = [x * x for x in range(10) if x % 2 == 0]
它最适合表达“从 A 变成 B”的数据转换。
raw_names = [" Alice ", "BOB", " carol"]names = [name.strip().lower() for name in raw_names]
推导式可以包含多个 for,官方例子里用它展开嵌套列表。
matrix = [[1, 2, 3], [4, 5, 6]]flat = [num for row in matrix for num in row]
这里的顺序和普通嵌套循环一致:
flat = []for row in matrix: for num in row: flat.append(num)
推导式也有边界。表达式一旦塞进复杂分支、多个函数调用和嵌套推导,阅读成本会快速上升。官方教程在矩阵转置示例里也提到,实际应用中可以优先使用内置函数,例如 zip(*matrix)。
matrix = [ [1, 2, 3], [4, 5, 6],]columns = list(zip(*matrix))
我的经验规则:一行能读懂,就用推导式;需要解释执行步骤,就改成普通循环。
del:按索引、切片和变量名删除
官方教程把 del 单独拿出来讲,因为它和 pop 的语义不同。pop 会返回被移除的值,del 表达的是“删除这个位置或这个名字”。
items = ["a", "b", "c", "d"]del items[0]del items[1:]
清空列表也可以用切片删除:
items = [1, 2, 3]del items[:]
del 还能删除变量绑定:
cache = {"token": "abc"}del cache
业务代码里,del mapping[key] 通常比把值设为 None 更明确。如果 None 也是合法业务值,删除键和值为 None 是两种语义。
profile = {"nickname": None, "age": 30}del profile["age"] # age 这个字段被移除profile["nickname"] = None # nickname 字段存在,值为空
元组:用不可变表达一条记录
元组是有序、不可变的序列。官方教程强调,元组通常用于异质元素序列,通过解包或索引访问;列表通常用于同质元素集合。
point = (120.5, 31.2)x, y = point
函数返回多个值时,本质上常常就是返回元组。
def split_name(full_name: str) -> tuple[str, str]: first, last = full_name.split(maxsplit=1) return first, lastfirst, last = split_name("Ada Lovelace")
一个元素的元组需要尾随逗号,这是很多初学者会踩的点。
not_tuple = ("hello")one_item_tuple = ("hello",)
元组本身不可变,但可以包含可变对象。这个细节很重要。
record = ([1, 2], "ok")record[0].append(3)print(record) # ([1, 2, 3], 'ok')
所以,“元组不可变”指的是元组槽位绑定不可变。槽位里引用的对象如果自身可变,内部状态仍然可以变化。
实战里,元组适合这几类场景:
作为轻量记录,例如坐标、范围、数据库行。
作为多返回值。
作为可哈希的复合键,前提是内部元素也可哈希。
sales = { ("2026-07-14", "CN"): 1200, ("2026-07-14", "US"): 900,}
集合:去重和成员检测
集合是无重复元素的无序容器。官方教程强调两个基本用途:成员检测和消除重复元素。集合还支持并集、交集、差集和对称差集。
tags = ["python", "web", "python", "ai"]unique_tags = set(tags)print("python" in unique_tags)
集合运算在权限、标签、推荐、差异对比里非常自然。
old_permissions = {"read", "write"}new_permissions = {"read", "delete"}added = new_permissions - old_permissionsremoved = old_permissions - new_permissionskept = old_permissions & new_permissionschanged = old_permissions ^ new_permissions
创建空集合要用 set()。{} 创建的是空字典。
empty_set = set()empty_dict = {}
集合的迭代顺序适合视为实现细节。需要稳定输出时,配合 sorted。
for tag in sorted(unique_tags): print(tag)
实战里,集合经常用于“已访问”状态:
def unique_in_order(items): seen = set() result = [] for item in items: if item in seen: continue seen.add(item) result.append(item) return result
这个写法同时保留输入顺序和去重结果。
字典:Python 里最重要的映射结构
字典是键值对映射。官方教程强调,字典用键索引,键必须唯一,并且通常需要是不可变类型。字符串、数字和只包含不可变对象的元组都可以作为键;列表作为键会破坏哈希稳定性,因此适合做值,适合做键。
profile = { "id": 1001, "name": "Ada", "role": "admin",}profile["active"] = True
直接访问缺失键会抛 KeyError。业务代码里可以用 get 表达“可选值”。
nickname = profile.get("nickname", "匿名用户")
检查键是否存在,用 in。
if "role" in profile: print(profile["role"])
Python 3.7 以后,普通字典保持插入顺序已经是语言保证。官方教程也在示例中提到,list(d) 会按插入次序返回键列表。需要排序输出时,用 sorted(d) 或 sorted(d.items())。
for key in sorted(profile): print(key, profile[key])
字典推导式
字典推导式适合从序列构建映射。
users = ["alice", "bob", "carol"]index = {name: i for i, name in enumerate(users)}
常见实战:把接口返回的列表转成按 ID 查询的字典。
rows = [ {"id": 1, "name": "Ada"}, {"id": 2, "name": "Guido"},]users_by_id = {row["id"]: row for row in rows}
这个转换能把后续查找从“遍历列表”变成“按键访问”。
循环技巧:让遍历代码更像数据本身
官方教程总结了几种非常 Pythonic 的循环方式。
遍历字典键和值,用 items()。
for key, value in profile.items(): print(key, value)
遍历序列时需要索引,用 enumerate()。
for line_no, line in enumerate(lines, start=1): print(line_no, line)
并行遍历多个序列,用 zip()。
names = ["Ada", "Guido"]scores = [98, 95]for name, score in zip(names, scores): print(name, score)
逆序遍历,用 reversed()。
for item in reversed(history): print(item)
排序后遍历,用 sorted()。
for name in sorted(users): print(name)
这里的核心思想是:让循环表达“你想怎样看数据”,少写临时变量和手动下标。
条件控制:容器参与布尔判断
官方教程把条件控制放在数据结构之后讲,很合理。容器经常直接参与条件判断。
空列表、空字典、空集合、空元组在布尔上下文中为假;非空容器为真。
成员检测用 in。
if user_id in active_users: ...
and 和 or 是短路运算符。它们从左到右求值,结果确定后停止。作为普通值使用时,返回最后参与求值的对象。
name = user.get("nickname") or user.get("name") or "匿名用户"
这个技巧很实用,但也要控制范围。如果 0、空字符串、空列表都是合法业务值,就把条件写明确。
value = payload.get("count")if value is None: value = 0
is 用来判断对象身份,== 用来判断值相等。判断 None 时使用 is None。
序列比较:按字典序逐项比较
官方教程说明,序列之间可以按字典序比较:先比第一个元素,再比第二个元素,直到出现不同或某个序列结束。
(1, 2, 3) < (1, 2, 4)["a", "b"] < ["a", "c"]
这个机制在排序中很有用。比如按分数降序、时间升序排序,可以把排序 key 设计成元组。
records = [ {"name": "Ada", "score": 98, "time": 35}, {"name": "Guido", "score": 98, "time": 31}, {"name": "Linus", "score": 95, "time": 28},]ranked = sorted(records, key=lambda r: (-r["score"], r["time"]))
Python 会先比较 -score,分数相同时再比较 time。
深入扩展:标准库里的专用容器
官方教程在队列部分提到 collections.deque,标准库的 collections 文档还提供了更多专用容器。它们补充了内置 list、tuple、set、dict 的能力。
deque:双端队列和滑动窗口
deque 的两端追加和弹出都很快。队列、最近 N 条记录、滑动窗口都适合它。
from collections import dequerecent = deque(maxlen=3)for event in ["login", "click", "pay", "logout"]: recent.append(event)print(list(recent)) # ['click', 'pay', 'logout']
滑动平均:
from collections import dequedef moving_average(values, window_size): window = deque() total = 0 for value in values: window.append(value) total += value if len(window) > window_size: total -= window.popleft() yield total / len(window)
Counter:计数、词频、排行榜
Counter 是字典子类,专门用于计数 hashable 对象。标准库文档说明,缺失元素的计数返回 0,most_common() 可以返回高频元素。
from collections import Counterstatus_codes = [200, 200, 404, 500, 200, 404]counter = Counter(status_codes)print(counter[403]) # 0print(counter.most_common(2)) # [(200, 3), (404, 2)]
多重集合运算也很实用:
from collections import Counterinventory = Counter(apple=5, banana=2)order = Counter(apple=3, banana=4)available = inventory - ordermissing = order - inventory
defaultdict:让分组聚合更干净
defaultdict 会为缺失键自动创建默认值。它适合分组、聚合、邻接表。
from collections import defaultdictorders = [ {"user": "alice", "amount": 80}, {"user": "bob", "amount": 50}, {"user": "alice", "amount": 20},]amounts_by_user = defaultdict(list)for order in orders: amounts_by_user[order["user"]].append(order["amount"])
聚合求和:
total_by_user = defaultdict(int)for order in orders: total_by_user[order["user"]] += order["amount"]
图的邻接表:
graph = defaultdict(list)graph["A"].append("B")graph["A"].append("C")
heapq:优先级队列和 Top K
heapq 提供堆队列算法,常用于小顶堆。它适合优先级队列、Top K、合并有序数据流。
import heapqscores = [90, 75, 98, 82, 100, 88]top3 = heapq.nlargest(3, scores)
任务调度:
import heapqtasks = []heapq.heappush(tasks, (2, "send email"))heapq.heappush(tasks, (1, "write report"))heapq.heappush(tasks, (3, "archive logs"))while tasks: priority, task = heapq.heappop(tasks) print(priority, task)
如果只需要最大或最小的少量元素,heapq.nlargest() 和 heapq.nsmallest() 通常比完整排序更贴近需求。
实战:日志分析里的组合拳
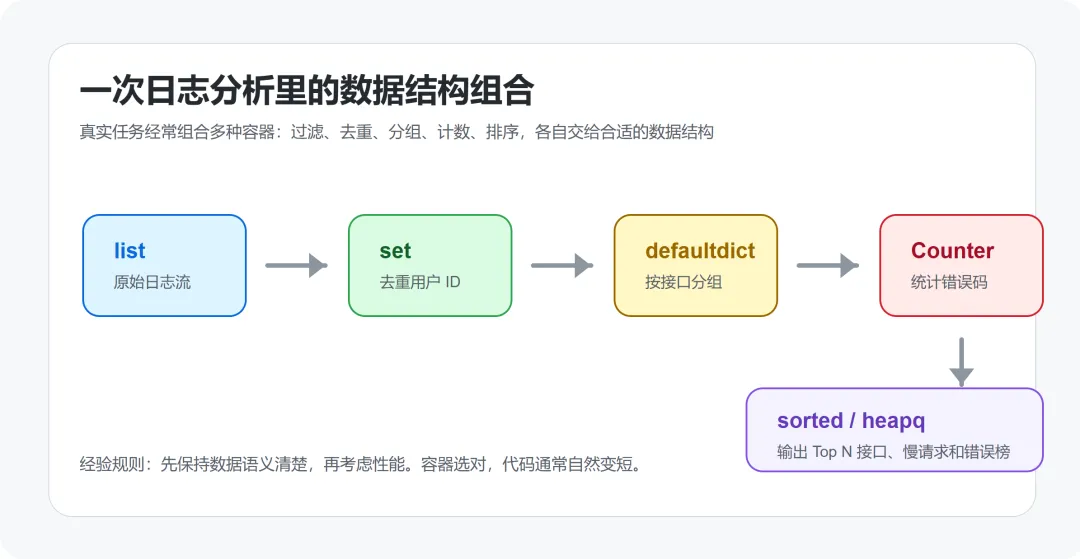
下面这个例子把多个结构组合起来:列表保存原始记录,集合去重用户,defaultdict 按接口分组,Counter 统计错误码,heapq 找慢请求。
from collections import Counter, defaultdictimport heapqlogs = [ {"user": "u1", "path": "/api/orders", "status": 200, "ms": 120}, {"user": "u2", "path": "/api/orders", "status": 500, "ms": 860}, {"user": "u1", "path": "/api/profile", "status": 200, "ms": 90}, {"user": "u3", "path": "/api/orders", "status": 404, "ms": 210},]active_users = {row["user"] for row in logs}by_path = defaultdict(list)for row in logs: by_path[row["path"]].append(row)status_counter = Counter(row["status"] for row in logs)slowest = heapq.nlargest(2, logs, key=lambda row: row["ms"])print(active_users)print(status_counter.most_common())print(slowest)
这段代码的重点是语义分工:
set 表达唯一用户。
defaultdict(list) 表达一对多分组。
Counter 表达频次统计。
heapq.nlargest 表达 Top N。
容器选对以后,代码就像在描述问题本身。
浅拷贝、深拷贝和可变对象
官方教程里 list.copy() 是浅拷贝。浅拷贝会复制外层容器,但内部对象仍然共享。
rows = [[1, 2], [3, 4]]copied = rows.copy()copied[0].append(99)print(rows) # [[1, 2, 99], [3, 4]]print(copied) # [[1, 2, 99], [3, 4]]
需要递归复制内部对象时,用 copy.deepcopy()。
from copy import deepcopyrows = [[1, 2], [3, 4]]copied = deepcopy(rows)copied[0].append(99)print(rows) # [[1, 2], [3, 4]]print(copied) # [[1, 2, 99], [3, 4]]
这个问题在默认参数里尤其常见。可变对象适合在函数内部创建。
def collect(item, bucket=None): if bucket is None: bucket = [] bucket.append(item) return bucket
排序:key 比比较函数更重要
官方教程提到 list.sort() 和 sorted(),排序 HOWTO 进一步推荐使用 key 函数。key 会为每个元素生成排序依据。
users = [ {"name": "Ada", "age": 36}, {"name": "Guido", "age": 70}, {"name": "Carol", "age": 36},]users_by_age = sorted(users, key=lambda user: (user["age"], user["name"]))
多字段排序优先用元组 key。需要降序时,可以对数值取负,或在整体上使用 reverse=True。
ranked = sorted(users, key=lambda user: (-user["age"], user["name"]))
排序稳定性也很有价值。稳定排序表示相等 key 的元素保留原顺序。你可以分两次排序来表达不同优先级。
records.sort(key=lambda r: r["name"])records.sort(key=lambda r: r["score"], reverse=True)
第二次按分数排,分数相同的记录仍保留第一次按名字排好的顺序。
选型清单
遇到一组数据,可以按下面顺序判断:
需要按插入顺序保存并频繁追加:list。
需要栈:list.append 加 list.pop。
需要队列或两端操作:deque。
需要固定记录或多返回值:tuple。
需要去重、交并差、快速成员检测:set。
需要按键查找、缓存、索引:dict。
需要计数:Counter。
需要按键分组:defaultdict(list)。
需要优先级队列或 Top K:heapq。
需要只读配置叠加:ChainMap。
常见坑
第一,原地方法返回 None。写 items = items.sort() 会把 items 变成 None。
第二,空集合用 set()。{} 是空字典。
第三,集合无序。输出或测试断言需要稳定顺序时,用 sorted()。
第四,元组里放可变对象时,内部对象依然可变。
第五,浅拷贝只复制外层容器。嵌套结构需要确认共享关系。
第六,遍历时修改同一个列表容易漏元素。更安全的方式是构造新列表。
clean = [x for x in raw_data if x is not None]
总结
Python 数据结构的核心,是用合适的容器表达数据语义。
列表表达有序可变序列;元组表达固定记录;集合表达唯一性和集合运算;字典表达键值索引;deque、Counter、defaultdict、heapq 则把常见业务模式进一步封装成标准工具。
容器选对,代码会更短,也更接近问题本身。
资料来源
本文主要参考 Python 3.14 中文官方文档:
•5. 数据结构[1]•collections 容器数据类型[2]•排序的技术[3]•heapq 堆队列算法[4]
References
[1] 5. 数据结构: https://docs.python.org/zh-cn/3.14/tutorial/datastructures.html
[2] collections 容器数据类型: https://docs.python.org/zh-cn/3.14/library/collections.html
[3] 排序的技术: https://docs.python.org/zh-cn/3.14/howto/sorting.html
[4] heapq 堆队列算法: https://docs.python.org/zh-cn/3.14/library/heapq.html
 10个月宝宝每天需要喝多少奶粉?