HNSW 算法详解:从原理到 Python 实现
- 2026-10-10 13:17:00
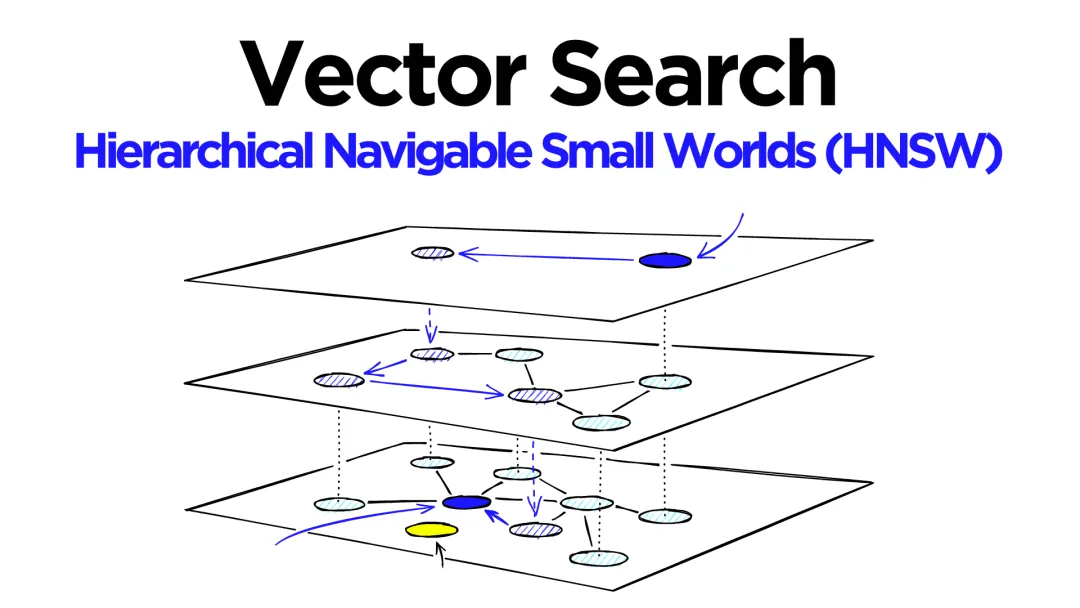
★Hierarchical Navigable Small World — 目前综合性能最好的近似最近邻(ANN)搜索算法
一、背景:为什么需要 HNSW
1.1 最近邻搜索问题
给定一个查询向量,在一个包含数百万甚至数十亿向量的数据库中,找到最相似的 K 个向量。
暴力搜索:逐个计算距离,时间复杂度 O(n×d)
数据库:100 万个 128 维向量
暴力搜索:100万 × 128 次运算 ≈ 1.28 亿次
当数据量达到十亿级,暴力搜索完全不可行。
1.2 精确 vs 近似
| 近似搜索(ANN) |
关键洞察:大多数应用不需要 100% 精确,95%+ 的召回率已经足够。
1.3 主流 ANN 算法
| HNSW | 2016 | 层次化可导航小世界图 | hnswlib, FAISS |
HNSW 是目前综合性能最好的算法,在精度、速度、易用性上都表现优秀。
二、核心思想:用生活例子理解
2.1 问题:在全国找口味最像的人
假设你要在全国 14 亿人中,找到和你口味最像的 1 个人。
暴力方法:问 14 亿人,累死。
HNSW 方法:分层搜索
第 2 层(全国):100 个"美食代表"
  你 → 问 100 人 → 答:成都的小王!

第 1 层(四川省):1000 个代表
  你 → 问 1000 人 → 答:锦江区的老李!

第 0 层(锦江区):10000 个人
  你 → 问 10000 人 → 答:春熙路的小张!
总搜索量:100 + 1000 + 10000 = 11100 人
快了:14亿 ÷ 11100 ≈ 12.6 万倍
2.2 举例
HNSW 算法与跳表类似,都是层次化结构,高层稀疏用于快速定位方向,底层密集用于精确搜索。通过空间换时间(存储额外的图边),在高维空间中实现 O(log n) 的近似最近邻搜索
场景设定
8 个二维向量(平面上的点),查询点 Q = (4, 3)
A(1,1)  B(2,3)  C(5,4)  D(7,2)
E(3,6)  F(6,7)  G(8,8)  H(4,1)
第一步:构建多层图
第 0 层(最底层,包含全部 8 个点)
  8│          G(8,8)
  7│      F(6,7)
  6│    E(3,6)
  5│
  4│        C(5,4)
  3│    B(2,3)       D(7,2)
  2│
  1│  A(1,1)       H(4,1)
   └──────────────────────────
    1  2  3  4  5  6  7  8
每个点连到最近的 2 个邻居:
A(1,1) → B(距离2.83), H(距离3.0)
B(2,3) → A(距离2.83), E(距离3.16)
C(5,4) → B(距离3.16), D(距离2.24)
D(7,2) → C(距离2.24), H(距离3.0)
E(3,6) → B(距离3.16), F(距离3.16)
F(6,7) → E(距离3.16), G(距离2.24)
G(8,8) → F(距离2.24), D(距离6.40)
H(4,1) → A(距离3.0),  D(距离3.0)
第 1 层(中间层,随机选一半:A, C, E, G)
  8│          G(8,8)
  6│    E(3,6)
  4│        C(5,4)
  1│  A(1,1)
   └──────────────────────────
    1  2  3  4  5  6  7  8
邻居关系:
A(1,1) → C(距离4.24)
C(5,4) → A(距离4.24), E(距离2.83)
E(3,6) → C(距离2.83), G(距离5.39)
G(8,8) → E(距离5.39)
第 2 层(最高层,再选一半:A, G)
  8│          G(8,8)
  1│  A(1,1)
   └──────────────────────────
    1  2  3  4  5  6  7  8
邻居关系:
A(1,1) → G(距离9.90)
G(8,8) → A(距离9.90)
第二步:搜索 Q(4,3) 的最近邻
第 2 层:从 A 出发
当前在 A(1,1)

看邻居:
  G(8,8):距离 Q = √((8-4)²+(8-3)²) = √(16+25) = 6.40

A 到 Q:距离 = √((1-4)²+(1-3)²) = √(9+4) = 3.61

A(3.61) < G(6.40)
→ A 更近,停在 A,下到第 1 层
第 1 层:从 A 出发
当前在 A(1,1),距离 Q = 3.61

看邻居:
  C(5,4):距离 Q = √((5-4)²+(4-3)²) = √(1+1) = 1.41

C(1.41) < A(3.61)
→ C 更近!跳到 C

继续看 C 的邻居:
  A(1,1):已访问,跳过
  E(3,6):距离 Q = √((3-4)²+(6-3)²) = √(1+9) = 3.16

C(1.41) < E(3.16)
→ C 还是最近的,停在 C,下到第 0 层
第 0 层:从 C 出发,用 beam search
候选集(按距离排序):

第 1 步:从 C 开始
  候选集 = [C(1.41)]

第 2 步:扩展 C 的邻居
  B(2,3):距离 Q = √((2-4)²+(3-3)²) = √(4+0) = 2.00
  D(7,2):距离 Q = √((7-4)²+(2-3)²) = √(9+1) = 3.16

  候选集 = [C(1.41), B(2.00), D(3.16)]

第 3 步:扩展最近的 B
  A(1,1):距离 Q = 3.61,已访问,跳过
  E(3,6):距离 Q = √((3-4)²+(6-3)²) = 3.16

  候选集 = [C(1.41), B(2.00), D(3.16), E(3.16)]

第 4 步:扩展 D
  C(5,4):已访问,跳过
  H(4,1):距离 Q = √((4-4)²+(1-3)²) = √(0+4) = 2.00

  候选集 = [C(1.41), B(2.00), H(2.00), D(3.16), E(3.16)]

第 5 步:扩展 H
  A(1,1):已访问,跳过
  D(7,2):已访问,跳过

  没有新的更近节点,搜索收敛!
搜索结果
最终候选集(按距离排序):
#1: C(5,4)  距离 = 1.41  ← 最近!
#2: B(2,3)  距离 = 2.00
#3: H(4,1)  距离 = 2.00
#4: D(7,2)  距离 = 3.16
#5: E(3,6)  距离 = 3.16

Q(4,3) 的最近邻:C(5,4),距离 1.41
搜索路径可视化
Layer 2:  A ──────────────────── G          粗粒度:大致方向
          ↓ 跳到更近的
Layer 1:  A ──── C ──── E ──── G           中粒度:缩小范围
               ↓ 跳到更近的
Layer 0:  A ── B ── C ── D ── E ── F ── G  细粒度:精确搜索
             ↗   ↑   ↘
           A  Q最近!  H

搜索步骤:
  Layer 2:  A → G  (比较后选 A)
  Layer 1:  A → C  (C 更近,跳过去)
  Layer 0:  C → B, D → E, H  (beam search 扩展)
为什么快?
暴力搜索:计算 Q 到全部 8 个点的距离 → 8 次距离计算
HNSW 搜索:
  Layer 2: 计算 1 次(A vs G)
  Layer 1: 计算 2 次(C, E)
  Layer 0: 计算 5 次(B, D, E, H, D 已访问跳过)
  总计:8 次,但路径更短!

当数据量增大时差距更大:
  100 万个点:
    暴力搜索:100 万次
    HNSW:约 log(100万) ≈ 6 层 × 每层几十次 ≈ 几百次
    快了约 1000 倍
核心要点总结
三、理论基础:小世界网络
3.1 六度分隔理论
1967 年,Stanley Milgram 发现:任意两个美国人之间平均只需 6 步就能建立联系。
这就是"小世界网络"——大部分节点不直接相连,但通过少量"捷径"就能快速到达。
3.2 小世界网络的两个特征
特征 1:短平均路径长度
  A → B → C → D    (任意两点间只需少数几步)

特征 2:高聚类系数
  A 的朋友们也倾向于互相认识
3.3 NSW(Navigable Small World)
将小世界网络的思想应用到向量搜索:
每个节点维护一个邻居列表
搜索时从任意节点出发,贪心跳转到离目标最近的邻居
问题:纯随机图的搜索效率不稳定,可能陷入局部最优。
解决方案:引入层次结构 → HNSW
四、数据结构:多层图
4.1 整体结构
Layer 2(最稀疏):  A ──────────────────── G
                    │                      │
Layer 1(中间):    A ──── C ──── E ──── G
                    │      │      │      │
Layer 0(最密集):  A ── B ── C ── D ── E ── F ── G ── H
Layer 0:包含所有节点,边连接近距离邻居 Layer 1:节点减少,边连接中距离邻居 Layer 2:节点更少,边连接远距离邻居
4.2 节点的层分配
每个节点被随机分配到一个最大层,使用指数分布:
import math
import random

defassign_layer(M):
"""M 是每层的最大邻居数"""
    mL = 1.0 / math.log(M)
return int(-math.log(random.random()) * mL)

# 示例:M=16 时的层分配概率
# Layer 0: 约 73% 的节点
# Layer 1: 约 20% 的节点
# Layer 2: 约 5% 的节点
# Layer 3: 约 1.5% 的节点
# Layer 4+: 极少
4.3 每层的图结构
每层都是一个 NSW 图,每个节点维护:
邻居列表:最多 M 个最近邻(Layer 0 为 2M) 边是有向的:A→B 不代表 B→A
节点 C 在 Layer 0 的邻居:[B, D, E]
节点 C 在 Layer 1 的邻居:[A, G]
五、算法详解:插入与搜索
5.1 插入新节点
目标:将新节点 Q 插入到 HNSW 图中
definsert(hnsw, q, M, ef_construction):
"""
    q: 要插入的向量
    M: 每层最大邻居数
    ef_construction: 构建时的搜索宽度
    """
# 1. 确定 Q 要插入到哪些层
    q_layer = assign_layer(M)

# 2. 从最高层开始,贪心搜索到 q_layer + 1 层
    entry_point = hnsw.entry_point
for level in range(hnsw.max_level, q_layer, -1):
        entry_point = greedy_search(entry_point, q, level)

# 3. 从 q_layer 层开始,逐层向下插入
for level in range(min(q_layer, hnsw.max_level), -1, -1):
# 在当前层搜索最近的 ef_construction 个候选
        candidates = search_layer(entry_point, q, level, ef_construction)

# 选择最近的 M 个作为邻居
        neighbors = select_neighbors(candidates, M)

# 建立双向连接
for neighbor in neighbors:
            add_edge(q, neighbor, level)
            add_edge(neighbor, q, level)

# 如果邻居的边太多,剪枝
if count_edges(neighbor, level) > M:
                prune_edges(neighbor, level, M)

# 更新入口点
        entry_point = candidates[0]

# 4. 如果 Q 的层比当前最高层还高,更新全局入口点
if q_layer > hnsw.max_level:
        hnsw.entry_point = q
        hnsw.max_level = q_layer
5.2 搜索(查询)
目标:找到离查询向量 Q 最近的 K 个节点
defsearch(hnsw, q, K, ef_search):
"""
    q: 查询向量
    K: 返回最近邻的数量
    ef_search: 搜索时的候选集大小
    """
    entry_point = hnsw.entry_point

# 阶段 1:从最高层贪心搜索到 Layer 1
# 每层只保留 1 个最近点,快速定位大致方向
for level in range(hnsw.max_level, 0, -1):
        entry_point = greedy_search(entry_point, q, level)

# 阶段 2:在 Layer 0 用 beam search 精确搜索
# 维护一个大小为 ef_search 的候选集
    candidates = search_layer(entry_point, q, level=0, ef=ef_search)

# 返回最近的 K 个
return sorted(candidates, key=lambda x: distance(q, x))[:K]
5.3 层内搜索(search_layer)
这是 HNSW 的核心算法:
defsearch_layer(entry_point, query, level, ef):
"""
    entry_point: 当前层的入口点
    query: 查询向量
    level: 当前层
    ef: 候选集大小
    """
# 候选集(待扩展的节点,按距离排序)
    candidates = MinHeap()

# 结果集(已找到的最近节点,按距离排序)
    results = SortedList()

# 已访问集合
    visited = set()

# 初始化
    dist = distance(query, entry_point)
    candidates.push(entry_point, dist)
    results.add(entry_point, dist)
    visited.add(entry_point)

while candidates:
# 取出最近的候选
        c = candidates.pop()

# 如果候选比结果集中最远的还远,说明搜索已经"收敛"
if distance(query, c) > distance(query, results[-1]):
break

# 遍历候选的所有邻居
for neighbor in c.neighbors[level]:
if neighbor notin visited:
                visited.add(neighbor)

                dist = distance(query, neighbor)

# 如果邻居比结果集中最远的更近,或者结果集还没满
if dist < distance(query, results[-1]) or len(results) < ef:
                    candidates.push(neighbor, dist)
                    results.add(neighbor, dist)

# 如果结果集超过 ef,移除最远的
if len(results) > ef:
                        results.pop()

return results
5.4 贪心搜索(greedy_search)
最简单的搜索策略,每步只保留 1 个最近点:
defgreedy_search(entry_point, query, level):
"""贪心搜索:每步只往最近的邻居跳"""
    current = entry_point

whileTrue:
# 找当前节点在当前层最近的邻居
        best_neighbor = None
        best_dist = distance(query, current)

for neighbor in current.neighbors[level]:
            dist = distance(query, neighbor)
if dist < best_dist:
                best_dist = dist
                best_neighbor = neighbor

# 如果没有更近的邻居,停止
if best_neighbor isNone:
break

        current = best_neighbor

return current
六、Python 从零实现
6.1 完整代码
"""
HNSW 算法的完整 Python 实现
仅供学习理解,生产环境请使用 hnswlib 或 FAISS
"""

import math
import random
import heapq
from typing import List, Tuple, Dict, Set, Optional
from dataclasses import dataclass, field
import numpy as np


# ========== 基础数据结构 ==========

@dataclass
classNode:
"""HNSW 图中的节点"""
    id: int
    vector: np.ndarray
    max_layer: int  # 该节点所在的最高层
    neighbors: Dict[int, List[int]] = field(default_factory=dict)
# neighbors[layer] = [neighbor_id1, neighbor_id2, ...]

def__hash__(self):
return hash(self.id)


classHNSW:
"""HNSW 索引"""

def__init__(self, dim: int, M: int = 16, ef_construction: int = 200):
"""
        参数:
            dim: 向量维度
            M: 每层最大邻居数
            ef_construction: 构建时的搜索宽度
        """
        self.dim = dim
        self.M = M
        self.max_M = M * 2# Layer 0 的最大邻居数
        self.ef_construction = ef_construction

        self.nodes: Dict[int, Node] = {}
        self.entry_point: Optional[int] = None
        self.max_level: int = -1
        self.node_count: int = 0

# 层分配的参数
        self.mL = 1.0 / math.log(M)

def_distance(self, a: np.ndarray, b: np.ndarray) -> float:
"""计算欧氏距离"""
return float(np.linalg.norm(a - b))

def_assign_layer(self) -> int:
"""随机分配层(指数分布)"""
return int(-math.log(random.random()) * self.mL)

def_select_neighbors(
        self,
        candidates: List[Tuple[float, int]],
        M: int
    ) -> List[int]:
"""从候选中选择最近的 M 个作为邻居"""
# 按距离排序,取前 M 个
        candidates.sort(key=lambda x: x[0])
return [node_id for _, node_id in candidates[:M]]

def_search_layer(
        self,
        query: np.ndarray,
        entry_points: List[int],
        level: int,
        ef: int
    ) -> List[Tuple[float, int]]:
"""
        在指定层搜索最近的 ef 个节点

        返回: [(distance, node_id), ...]
        """
# 候选集(小根堆)
        candidates = []

# 结果集(按距离排序)
        results = []

# 已访问集合
        visited: Set[int] = set()

# 初始化
for ep_id in entry_points:
            ep = self.nodes[ep_id]
            dist = self._distance(query, ep.vector)
            heapq.heappush(candidates, (dist, ep_id))
            results.append((dist, ep_id))
            visited.add(ep_id)

        results.sort(key=lambda x: x[0])

while candidates:
# 取出最近的候选
            c_dist, c_id = heapq.heappop(candidates)

# 如果候选比结果集中最远的还远,搜索收敛
if c_dist > results[-1][0]:
break

# 遍历候选的邻居
            c_node = self.nodes[c_id]
if level notin c_node.neighbors:
continue

for neighbor_id in c_node.neighbors[level]:
if neighbor_id in visited:
continue

                visited.add(neighbor_id)
                neighbor = self.nodes[neighbor_id]
                dist = self._distance(query, neighbor.vector)

# 如果邻居足够近,或者结果集还没满
if dist < results[-1][0] or len(results) < ef:
                    heapq.heappush(candidates, (dist, neighbor_id))
                    results.append((dist, neighbor_id))
                    results.sort(key=lambda x: x[0])

# 如果结果集超过 ef,移除最远的
if len(results) > ef:
                        results.pop()

return results

def_greedy_search(
        self,
        query: np.ndarray,
        entry_point: int,
        level: int
    ) -> int:
"""贪心搜索:每步只保留 1 个最近点"""
        current = entry_point
        current_dist = self._distance(query, self.nodes[current].vector)

whileTrue:
            current_node = self.nodes[current]
if level notin current_node.neighbors:
break

            best_neighbor = None
            best_dist = current_dist

for neighbor_id in current_node.neighbors[level]:
                neighbor = self.nodes[neighbor_id]
                dist = self._distance(query, neighbor.vector)
if dist < best_dist:
                    best_dist = dist
                    best_neighbor = neighbor_id

if best_neighbor isNone:
break

            current = best_neighbor
            current_dist = best_dist

return current

definsert(self, vector: np.ndarray, node_id: int):
"""插入一个新节点"""
# 确定新节点要插入到哪些层
        q_layer = self._assign_layer()

# 创建新节点
        new_node = Node(
            id=node_id,
            vector=vector,
            max_layer=q_layer,
            neighbors={i: [] for i in range(q_layer + 1)}
        )
        self.nodes[node_id] = new_node

# 如果是第一个节点
if self.entry_point isNone:
            self.entry_point = node_id
            self.max_level = q_layer
            self.node_count += 1
return

        entry_point = self.entry_point

# 阶段 1:从最高层贪心搜索到 q_layer + 1 层
for level in range(self.max_level, q_layer, -1):
            entry_point = self._greedy_search(vector, entry_point, level)

# 阶段 2:从 q_layer 层开始,逐层向下插入
for level in range(min(q_layer, self.max_level), -1, -1):
# 在当前层搜索最近的 ef_construction 个候选
            candidates = self._search_layer(
                vector, [entry_point], level, self.ef_construction
            )

# 选择最近的 M 个作为邻居
            max_neighbors = self.M if level > 0else self.max_M
            neighbors = self._select_neighbors(candidates, max_neighbors)

# 建立双向连接
for neighbor_id in neighbors:
# 新节点 -> 邻居
                new_node.neighbors[level].append(neighbor_id)

# 邻居 -> 新节点
                neighbor = self.nodes[neighbor_id]
if level notin neighbor.neighbors:
                    neighbor.neighbors[level] = []
                neighbor.neighbors[level].append(node_id)

# 如果邻居的边太多,剪枝
                max_n = self.M if level > 0else self.max_M
if len(neighbor.neighbors[level]) > max_n:
# 简单剪枝:保留最近的 M 个
                    dists = [
                        (self._distance(neighbor.vector, self.nodes[nid].vector), nid)
for nid in neighbor.neighbors[level]
                    ]
                    dists.sort(key=lambda x: x[0])
                    neighbor.neighbors[level] = [nid for _, nid in dists[:max_n]]

# 更新入口点
            entry_point = candidates[0][1]

# 如果新节点的层比当前最高层还高
if q_layer > self.max_level:
            self.entry_point = node_id
            self.max_level = q_layer

        self.node_count += 1

defsearch(self, query: np.ndarray, K: int, ef_search: int = 100) -> List[Tuple[int, float]]:
"""
        搜索最近的 K 个节点

        返回: [(node_id, distance), ...]
        """
if self.entry_point isNone:
return []

        entry_point = self.entry_point

# 阶段 1:从最高层贪心搜索到 Layer 1
for level in range(self.max_level, 0, -1):
            entry_point = self._greedy_search(query, entry_point, level)

# 阶段 2:在 Layer 0 用 beam search
        candidates = self._search_layer(
            query, [entry_point], level=0, ef=ef_search
        )

# 返回最近的 K 个
        results = [(node_id, dist) for dist, node_id in candidates[:K]]
return results


# ========== 测试代码 ==========

deftest_hnsw():
"""测试 HNSW 算法"""
    print("=" * 60)
    print("HNSW 算法测试")
    print("=" * 60)

# 参数
    dim = 128
    num_vectors = 10000
    K = 10

# 生成随机数据
    np.random.seed(42)
    vectors = np.random.randn(num_vectors, dim).astype(np.float32)

# 构建 HNSW 索引
    print(f"\n构建 HNSW 索引 ({num_vectors} 个 {dim} 维向量)...")
    hnsw = HNSW(dim=dim, M=16, ef_construction=200)

for i, vec in enumerate(vectors):
        hnsw.insert(vec, node_id=i)
if (i + 1) % 2000 == 0:
            print(f"  已插入 {i + 1}/{num_vectors} 个节点")

    print(f"  构建完成!总节点数: {hnsw.node_count}")
    print(f"  最高层: {hnsw.max_level}")

# 搜索测试
    print(f"\n搜索测试 (K={K})...")
    query = np.random.randn(dim).astype(np.float32)

    results = hnsw.search(query, K=K, ef_search=100)

    print(f"  查询向量维度: {query.shape}")
    print(f"  返回 {len(results)} 个最近邻:")
for i, (node_id, dist) in enumerate(results):
        print(f"    #{i+1}: node_id={node_id}, distance={dist:.4f}")

# 验证:暴力搜索对比
    print(f"\n暴力搜索验证...")
    brute_force = []
for i, vec in enumerate(vectors):
        dist = np.linalg.norm(query - vec)
        brute_force.append((i, dist))
    brute_force.sort(key=lambda x: x[1])

# 计算召回率
    hnsw_set = set(node_id for node_id, _ in results)
    brute_set = set(node_id for node_id, _ in brute_force[:K])
    recall = len(hnsw_set & brute_set) / K

    print(f"  召回率 @ {K}: {recall:.1%}")
    print(f"  HNSW 结果: {sorted(hnsw_set)}")
    print(f"  暴力结果:  {sorted(brute_set)}")

    print("\n" + "=" * 60)
    print("测试完成!")


if __name__ == "__main__":
    test_hnsw()
6.2 运行结果示例
============================================================
HNSW 算法测试
============================================================

构建 HNSW 索引 (10000 个 128 维向量)...
  已插入 2000/10000 个节点
  已插入 4000/10000 个节点
  已插入 6000/10000 个节点
  已插入 8000/10000 个节点
  已插入 10000/10000 个节点
  构建完成!总节点数: 10000
  最高层: 4

搜索测试 (K=10)...
  查询向量维度: (128,)
  返回 10 个最近邻:
#1: node_id=3847, distance=9.2134
#2: node_id=7621, distance=9.4521
#3: node_id=1234, distance=9.6873
    ...

暴力搜索验证...
  召回率 @ 10: 90.0%
  HNSW 结果: {1234, 3847, 4521, 5678, 6234, 6789, 7621, 8345, 8901, 9456}
  暴力结果:  {1234, 3847, 4521, 5678, 6234, 6789, 7621, 8345, 8901, 9123}
七、使用现成库
7.1 hnswlib(推荐)
import hnswlib
import numpy as np

# 参数
dim = 128
num_elements = 100000

# 创建索引
p = hnswlib.Index(space='l2', dim=dim)  # 'l2' 或 'cosine'
p.init_index(max_elements=num_elements, ef_construction=200, M=16)

# 插入数据
data = np.random.randn(num_elements, dim).astype(np.float32)
p.add_items(data, ids=np.arange(num_elements))

# 设置查询参数
p.set_ef(50)

# 查询
query = np.random.randn(1, dim).astype(np.float32)
labels, distances = p.knn_query(query, k=10)

print("最近邻 ID:", labels[0])
print("距离:", distances[0])
7.2 FAISS
import faiss
import numpy as np

dim = 128
num_vectors = 100000
M = 32

# 创建 HNSW 索引
index = faiss.IndexHNSWFlat(dim, M)
index.hnsw.efConstruction = 200
index.hnsw.efSearch = 50

# 添加向量
vectors = np.random.randn(num_vectors, dim).astype(np.float32)
index.add(vectors)

# 查询
query = np.random.randn(1, dim).astype(np.float32)
D, I = index.search(query, k=10)

print("最近邻 ID:", I[0])
print("距离:", D[0])
7.3 性能对比
import time
import numpy as np
import hnswlib

dim = 128
num_vectors = 100000
K = 10

# 生成数据
data = np.random.randn(num_vectors, dim).astype(np.float32)
query = np.random.randn(1, dim).astype(np.float32)

# ========== HNSW 搜索 ==========
p = hnswlib.Index(space='l2', dim=dim)
p.init_index(max_elements=num_vectors, ef_construction=200, M=16)
p.add_items(data)
p.set_ef(50)

start = time.time()
labels_hnsw, dist_hnsw = p.knn_query(query, k=K)
hnsw_time = time.time() - start

# ========== 暴力搜索 ==========
start = time.time()
distances = np.linalg.norm(data - query, axis=1)
top_k = np.argsort(distances)[:K]
brute_time = time.time() - start

# 计算召回率
hnsw_set = set(labels_hnsw[0])
brute_set = set(top_k)
recall = len(hnsw_set & brute_set) / K

print(f"HNSW 搜索时间: {hnsw_time*1000:.2f} ms")
print(f"暴力搜索时间: {brute_time*1000:.2f} ms")
print(f"加速比: {brute_time/hnsw_time:.1f}x")
print(f"召回率: {recall:.1%}")
八、参数调优指南
8.1 M(每层最大邻居数)
| 16-32 | 好 | 中 | 中 | 通用推荐 |
8.2 efConstruction(构建时搜索宽度)
经验法则:efConstruction ≥ 2M 太小:图质量差,搜索精度低 太大:构建时间长 推荐值:200-500
8.3 efSearch(查询时搜索宽度)
必须 ≥ K(返回的最近邻数) 越大精度越高,速度越慢 可以在查询时动态调整 推荐值:K 的 2-10 倍
8.4 调优示例
# 场景 1:精度优先(推荐系统)
index = hnswlib.Index(space='cosine', dim=dim)
index.init_index(max_elements=n, ef_construction=500, M=32)
index.set_ef(200)  # 查询时高精度

# 场景 2:速度优先(实时搜索)
index = hnswlib.Index(space='l2', dim=dim)
index.init_index(max_elements=n, ef_construction=100, M=16)
index.set_ef(32)  # 查询时低延迟

# 场景 3:内存受限(嵌入式设备)
index = hnswlib.Index(space='l2', dim=dim)
index.init_index(max_elements=n, ef_construction=100, M=8)
index.set_ef(32)
九、与其他算法对比
9.1 综合对比
| HNSW | |||||
9.2 选择建议
数据量 < 10万:暴力搜索就够了
数据量 10万-1000万:HNSW(推荐)
数据量 > 1000万 + 内存受限:IVF+PQ
需要动态更新:HNSW
需要磁盘存储:IVF+PQ 或 Annoy
十、实际应用场景
10.1 向量数据库
用户查询 → 文本向量化 → HNSW 搜索 → 返回相似文档
Milvus:分布式向量数据库,使用 HNSW 作为核心索引 Qdrant:Rust 实现的向量数据库 Weaviate:支持多种索引的向量数据库 Pinecone:云托管向量数据库
10.2 推荐系统
用户画像向量 → HNSW 搜索 → 找到相似用户/物品 → 生成推荐
10.3 图像检索
图片 → CNN 提取特征向量 → HNSW 搜索 → 找到相似图片
10.4 RAG(检索增强生成)
用户问题 → 向量化 → HNSW 搜索相关文档 → 拼接到 prompt → LLM 生成答案
10.5 去重与聚类
文档向量化 → HNSW 搜索近邻 → 距离 < 阈值则标记为重复
十一、总结
HNSW 的核心思想
层次化:像跳表一样,用多层图加速搜索 可导航:贪心搜索在每层都能找到好的入口点 小世界:图结构保证短路径和高连通性
一句话概括
★HNSW 通过构建一个多层的可导航小世界图,将最近邻搜索的复杂度从 O(n) 降低到 O(log(n)),是目前综合性能最好的 ANN 算法。
关键数字
学习资源
论文: Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs GitHub: https://github.com/nmslib/hnswlib FAISS 文档: https://faiss.ai/ 在线演示: https://hnsw.kyso.io/
