今天给大家带来的是机器学习的课程
在进入机器学习之前我们先了解下推荐系统
推荐系统,顾名思义就是在海量的数据中推荐出符合用户需要的数据
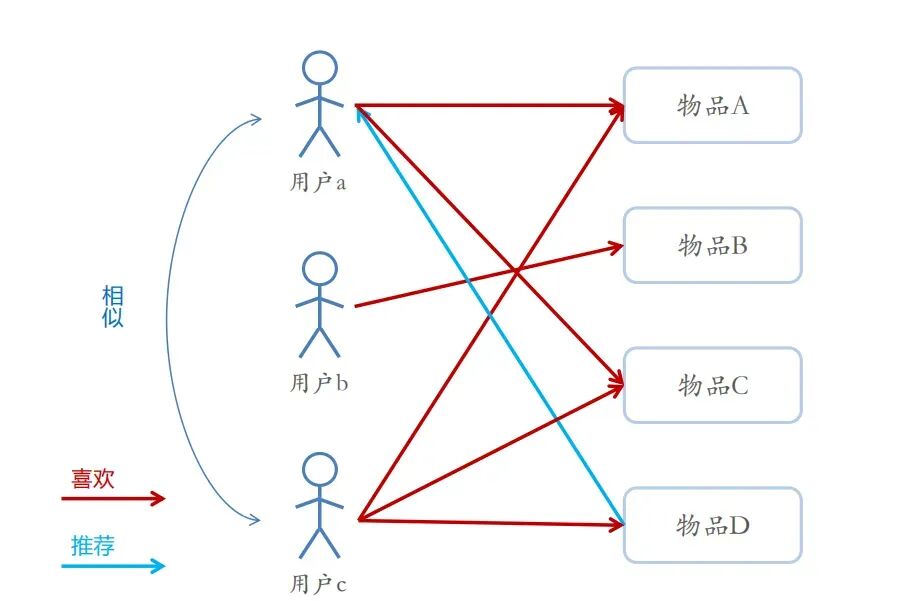
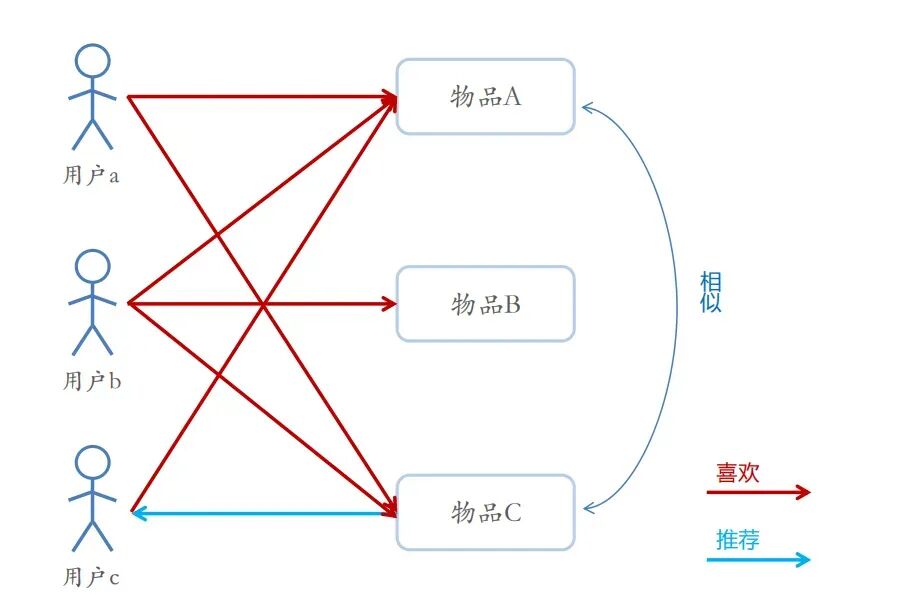
基本思想:利用用户喜欢过的东西或特征,给用户推荐符合的产品,利用和用户有相似喜欢风格的其他用户,推荐其他用户喜欢的产品
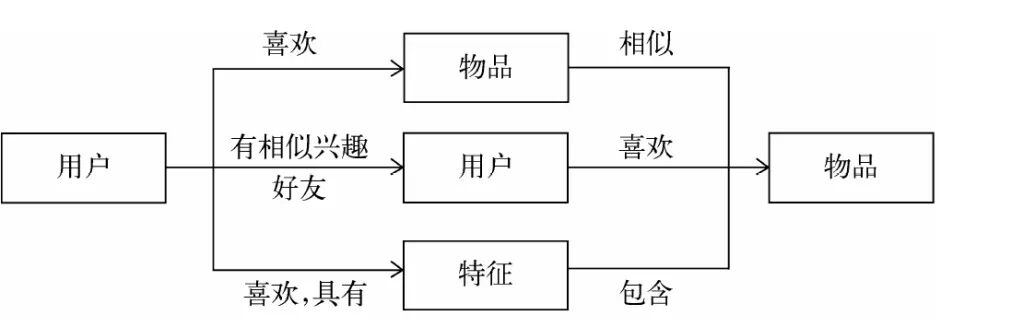
推荐系统的数据分析
1.需要关键字,分类标签,基因描述
2.用户的基本信息
3.用户的行为数据,可以转化为对物品或者信息的偏好
显式用户反馈:通过用户浏览的网站信息,对物品的评分
隐式用户反馈:通过用户购买了什么东西
推荐系统的分类:
1.离线推荐,实时推荐
2.基于统计的推荐,个性化推荐
3.基于相似度,知识,模型推荐
4.基于人口统计学,内容,协同过滤推荐
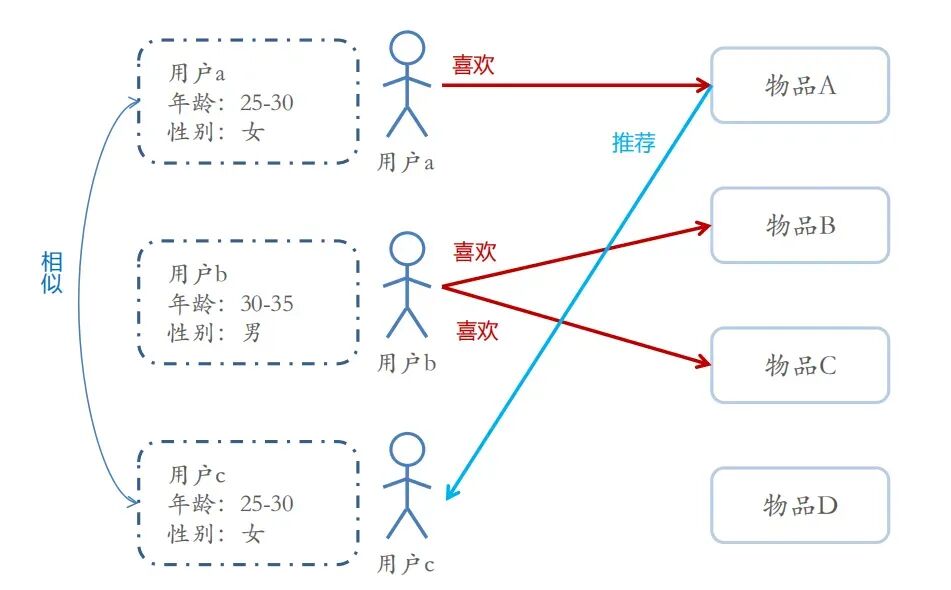
基于人口统计学推荐
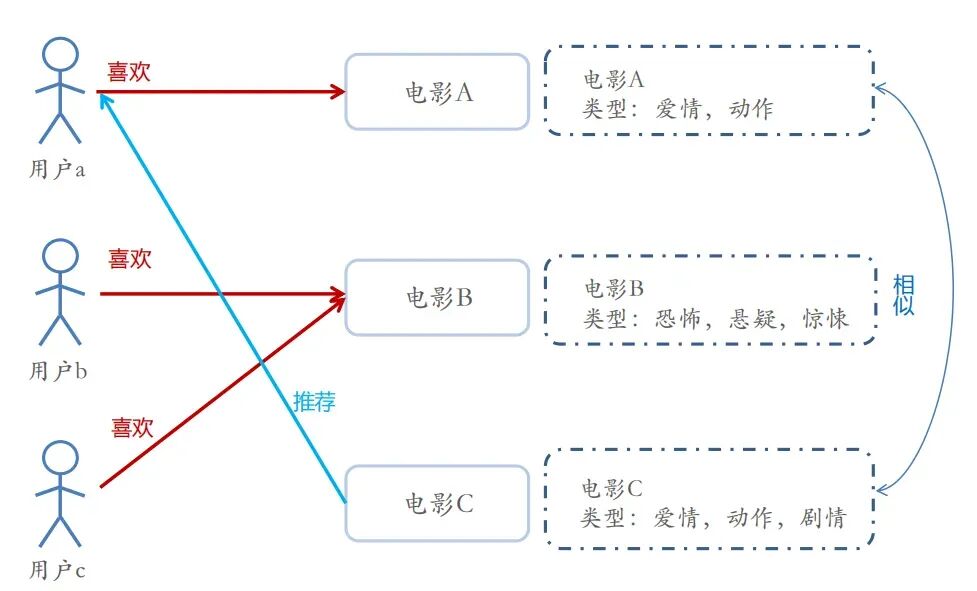
 基于内容推荐
 协同过滤算法推荐
 基于物品的过滤算法推荐
接下来讲机器学习
什么是机器学习?
让机器自己学习,不依赖编程
常见术语:
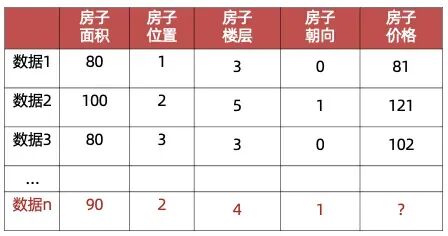
1.样本:一条数据就是一条样本,多个样本组成数据集
2.特征:一列数据一个特征,即属性
3.目标:模型要预测的数据,比如薪资,基于学历,年龄等预测
数据集划分
1.训练集:训练模型的数据集
2.测试集:测试模型的数据集
算法分类:
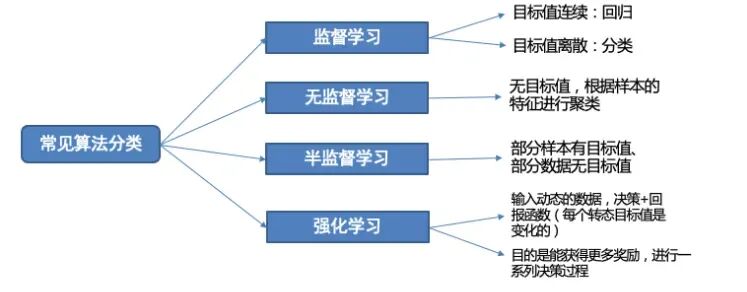
1.有监督学习
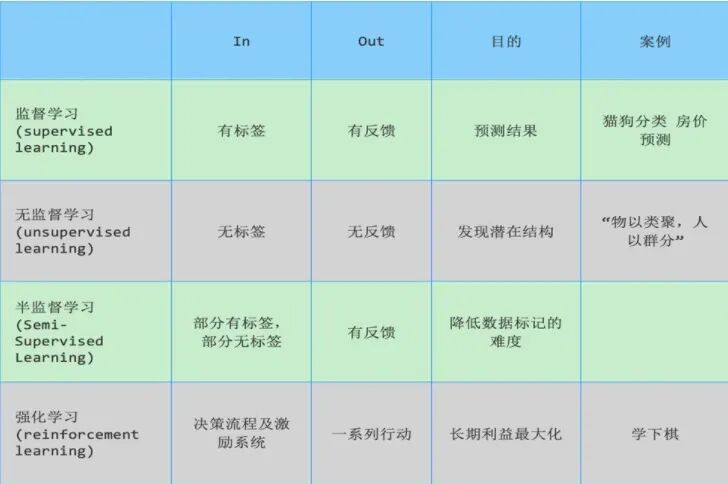
输入数据是由输入特征值和目标值所组成,即输入的训练数据有标签的
需要人工标注数据
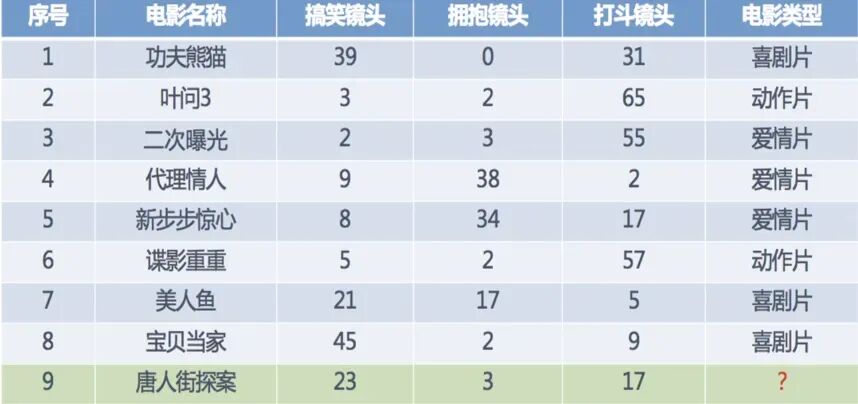
分类
目标值是不连续的
分类种类:二分类、多分类任务、
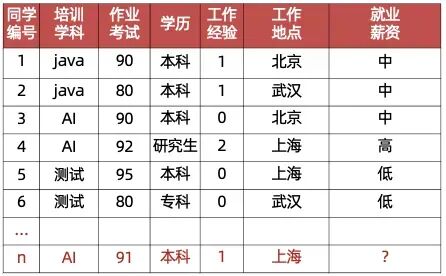
回归
目标值是连续的
无监督学习
输入数据没有被标记,即样本数据类别未知,没有标签,根据样本间的相似性,对样本集聚类,以发现事物内部 结构及相互关系。
不需要数据集
特点:1.训练数据无标签
2.根据样本间的相似性对样本集进行聚类,发现事物内部结构及相互关系
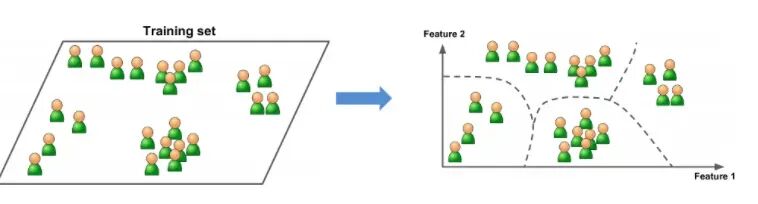
半监督学习:专家标注少量数据,利用已标记的数据训练模型,再利用该模型去套用未标记的数据,再利用该模型去套用未标记的数据
强化学习应用场景:里程碑AlphaGo围棋、各类游戏、对抗比赛、无人驾驶场景
强化学习通过构建四个要素:agent,环境状态,行动,奖励, agent根据环境状态进行行动获得最多的累计奖励。
总结
模型拟合的问题
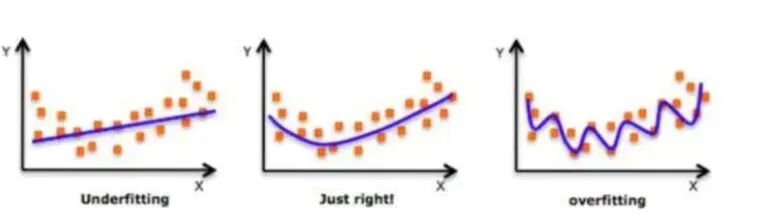
1.拟合:表示模型对样本点的拟合情况
2.欠拟合:模型在训练集上表现很差、在测试集表现也很差
原因:模型过于简单
3.过拟合:模型在训练集上表现很好、在测试集表现很差
原因:模型太过于复杂、数据不纯、训练数据太少
泛化:模型在新数据集(非训练数据)上的表现好坏的能力
奥卡姆剃刀原则:给定两个具有相同泛化误差的模型,较简单的模型比较复杂的模型更可取
开发环境
基于python的scikit-learn库
建立在NumPy,SciPy和matplotlib上
下载方式
pip install scikit-learn
本章完结
接下来会更新python算法,大家敬请期待
第一个群:只讨论java+vue的项目,学历提升和卖服务器的就别进了,进了也会被踢。第二个群:只讨论python项目,以后python的代码和教程会在群里开源,学历提升和卖服务器的就别进了,进了也会被踢。