第329讲:Python ORM流 vs VBA ADO原水流——从数据库(MySQL/PostgreSQL)导入数据到Excel
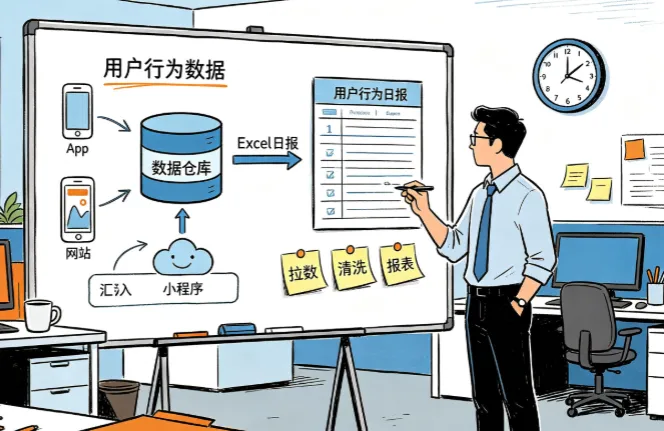
做数据分析的同学,每天早上打开电脑的第一件事,大概率不是泡咖啡,而是:把数据仓库里的用户行为数据拉到Excel里做日报。
这个动作看起来简单,但背后的技术选型,直接决定了你的工作效率、脚本稳定性,以及以后能不能睡个安稳觉。
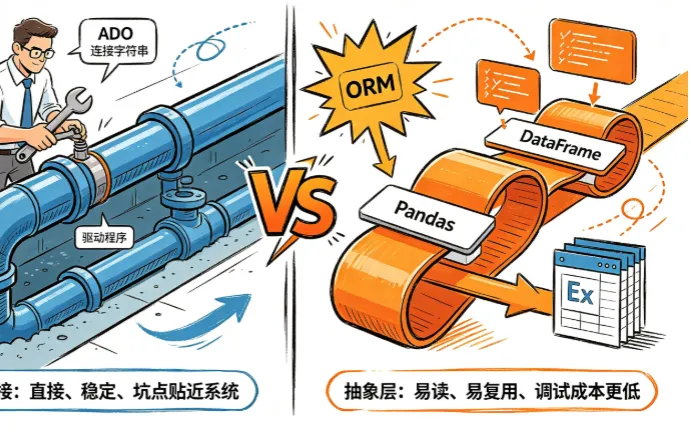
过去,大家习惯用VBA + ADO(ActiveX Data Objects)直连数据库;现在,越来越多的团队转向 Python + Pandas 的方案。这两种技术路线,本质上代表了两种完全不同的数据处理哲学:
VBA + ADO:贴近Windows系统底层的“原生连接”
Python + Pandas:面向数据的“ORM风格抽象”
今天这讲,我们就用一个真实场景——数据分析师每日从数仓导出用户行为数据到Excel报表,把这两套方案的底层逻辑、代码实现、坑点和适用边界,彻底讲透。
一、业务场景拆解:用户行为日报的真实需求
先别急着写代码,我们先把业务场景说清楚。这是一个典型的互联网公司用户行为分析需求:
1. 数据来源
数据库:MySQL 8.0 / PostgreSQL 14
数据表:user_behavior_log
数据量级:每日增量约50万~200万行
核心字段:
user_id:用户ID
event_time:行为发生时间
event_type:行为类型(click/view/purchase)
page_url:页面URL
device_type:设备类型
city:城市
2. 业务需求
数据分析师小李,每天需要:
拉取昨日的全量用户行为数据
按城市、设备类型做基础统计
输出到Excel,生成日报
邮件发送给运营团队
3. 技术约束
Excel文件不能太大(<50MB)
数据必须是最新、准确的
脚本需要稳定运行,不能天天报错
后续可能接入自动化调度(Airflow / Windows任务计划)
这个场景,非常适合用来对比 VBA ADO 与 Python Pandas 的差异。
二、VBA方案:ADODB.Connection 的原生连接之道
1. ADO是什么?(老司机才懂的历史)
ADO(ActiveX Data Objects)诞生于1996年,是微软为统一数据访问推出的核心技术。它的设计哲学是:
无论背后是SQL Server、Oracle、MySQL还是Excel本身,前端都用同一套对象模型去访问。
这套技术在Windows平台上极其成熟,至今仍是VBA连接数据库的标准方案。
2. VBA连接MySQL的完整实现
(1)准备工作:安装MySQL ODBC驱动
在使用VBA前,必须先安装 MySQL ODBC Connector:
MySQL 8.0 → 下载 MySQL ODBC 8.0 Driver
PostgreSQL → 下载 psqlODBC
安装完成后,可以在“ODBC数据源管理器”中看到驱动。
(2)VBA代码实现
Sub ImportUserBehaviorFromMySQL() Dim conn As Object Dim rs As Object Dim sql As String Dim ws As Worksheet Dim lastRow As Long Dim startTime As Double startTime = Timer ' 错误处理 On Error GoTo Cleanup ' 创建ADO连接对象 Set conn = CreateObject("ADODB.Connection") Set rs = CreateObject("ADODB.Recordset") Set ws = ThisWorkbook.Sheets("RawData") ' 清空旧数据 ws.Cells.Clear ' ===== 连接字符串(MySQL)===== conn.ConnectionString = _ "Driver={MySQL ODBC 8.0 Unicode Driver};" & _ "Server=192.168.1.100;" & _ "Database=user_analytics;" & _ "Uid=report_user;" & _ "Pwd=StrongPassword123;" & _ "charset=utf8mb4;" conn.Open ' ===== SQL查询(昨日数据)===== sql = _ "SELECT " & _ " user_id, " & _ " event_time, " & _ " event_type, " & _ " page_url, " & _ " device_type, " & _ " city " & _ "FROM user_behavior_log " & _ "WHERE event_time >= CURDATE() - INTERVAL 1 DAY " & _ " AND event_time < CURDATE() " & _ "ORDER BY event_time;" ' 执行查询 rs.Open sql, conn, 1, 1 ' 1=adOpenKeyset, 1=adLockReadOnly ' ===== 将数据写入Excel ===== If Not rs.EOF Then ' 写入表头 Dim i As Integer For i = 0 To rs.Fields.Count - 1 ws.Cells(1, i + 1).Value = rs.Fields(i).Name Next i ' 写入数据(批量复制,性能更好) ws.Range("A2").CopyFromRecordset rs ' 格式化表头 ws.Range("A1").CurrentRegion.Rows(1).Font.Bold = True ws.Range("A1").CurrentRegion.Columns.AutoFit Else MsgBox "未查询到昨日数据!", vbExclamation End If rs.Close conn.Close MsgBox "数据导入完成!耗时:" & Round(Timer - startTime, 2) & "秒", vbInformation Exit SubCleanup: If Not rs Is Nothing Then If rs.State = 1 Then rs.Close Set rs = Nothing End If If Not conn Is Nothing Then If conn.State = 1 Then conn.Close Set conn = Nothing End If MsgBox "发生错误:" & Err.Description, vbCriticalEnd Sub
(3)连接PostgreSQL的小改动
只需更换驱动和连接字符串:
conn.ConnectionString = _ "Driver={PostgreSQL Unicode};" & _ "Server=192.168.1.100;" & _ "Port=5432;" & _ "Database=user_analytics;" & _ "Uid=report_user;" & _ "Pwd=StrongPassword123;"
3. VBA ADO方案的核心特点
✅ 优点
系统级集成:无需安装额外语言环境,Excel自带
性能稳定:CopyFromRecordset批量写入速度很快
离线可用:一次连接,数据拉到本地
权限可控:数据库账号权限可精细管理
❌ 缺点
驱动依赖强:ODBC驱动版本不匹配会直接报错
代码冗长:连接、查询、关闭都要手写
调试困难:SQL报错信息不够友好
跨平台几乎不可能:只能在Windows + Excel环境运行
数据类型映射隐式:日期、NULL值在Excel中容易变形
🔍 一个容易被忽略的细节
rs.Open sql, conn, 1, 1
这里的 1, 1是游标类型和锁类型的简写:
第一个 1= adOpenKeyset(键集游标)
第二个 1= adLockReadOnly(只读锁)
如果写成 rs.Open sql, conn,在某些环境下会导致记录集无法向前滚动,这是个经典坑。
三、Python方案:pymysql + pandas 的ORM风格体验
1. Python为什么被称为“ORM风格”?
虽然 pymysql本身不是ORM(对象关系映射),但 pandas.read_sql() 的存在,让整个体验非常接近ORM:
你不需要关心Recordset、Cursor这些底层概念,只需要告诉Pandas“我要什么数据”,它帮你搞定一切。
这就是典型的“高级抽象”。
2. Python环境准备
pip install pymysql pandas sqlalchemy openpyxl
pymysql:MySQL驱动
pandas:数据处理核心
sqlalchemy:数据库连接池与ORM基础
openpyxl:Excel写入引擎
3. Python实现方案一:pymysql + pandas.read_sql()
这是最推荐的方案,简洁、稳定、可维护性强。
import pymysqlimport pandas as pdfrom datetime import datetime, timedeltaimport timedef import_user_behavior_mysql(): """ 从MySQL导入用户行为数据到Excel """ start_time = time.time() # ===== 1. 数据库连接配置 ===== conn = pymysql.connect( host='192.168.1.100', port=3306, user='report_user', password='StrongPassword123', database='user_analytics', charset='utf8mb4', cursorclass=pymysql.cursors.DictCursor # 返回字典格式,便于调试 ) try: # ===== 2. SQL查询 ===== yesterday = datetime.now().date() - timedelta(days=1) sql = """ SELECT user_id, event_time, event_type, page_url, device_type, city FROM user_behavior_log WHERE event_time >= %s AND event_time < %s ORDER BY event_time """ # ===== 3. pandas读取SQL ===== df = pd.read_sql( sql, conn, params=[yesterday, yesterday + timedelta(days=1)] ) print(f"成功读取 {len(df)} 条数据") # ===== 4. 基础数据处理(Pandas优势体现)===== # 转换时间格式 df['event_time'] = pd.to_datetime(df['event_time']) # 添加衍生字段 df['hour'] = df['event_time'].dt.hour df['is_weekend'] = df['event_time'].dt.weekday >= 5 # ===== 5. 写入Excel ===== output_file = f"用户行为日报_{yesterday}.xlsx" with pd.ExcelWriter(output_file, engine='openpyxl') as writer: # 原始数据sheet df.to_excel(writer, sheet_name='原始数据', index=False) # 统计汇总sheet summary = df.groupby(['city', 'device_type'])['user_id'].count().reset_index() summary.columns = ['城市', '设备类型', '行为次数'] summary.to_excel(writer, sheet_name='城市设备统计', index=False) # 小时趋势sheet hourly = df.groupby('hour')['user_id'].count().reset_index() hourly.columns = ['小时', '行为次数'] hourly.to_excel(writer, sheet_name='小时趋势', index=False) elapsed = time.time() - start_time print(f"数据导入完成!文件:{output_file}") print(f"耗时:{elapsed:.2f}秒") except Exception as e: print(f"发生错误:{e}") finally: conn.close()if __name__ == "__main__": import_user_behavior_mysql()
4. Python实现方案二:SQLAlchemy(更接近ORM)
如果你追求更工程化的写法,可以使用 SQLAlchemy:
from sqlalchemy import create_engineimport pandas as pddef import_with_sqlalchemy(): """使用SQLAlchemy连接数据库""" # 创建连接引擎 engine = create_engine( 'mysql+pymysql://report_user:StrongPassword123@192.168.1.100:3306/user_analytics?charset=utf8mb4', pool_size=5, # 连接池大小 pool_recycle=3600, # 连接回收时间 echo=False # 是否打印SQL(调试用) ) yesterday = pd.Timestamp.now().normalize() - pd.Timedelta(days=1) sql = """ SELECT * FROM user_behavior_log WHERE event_time >= %(start)s AND event_time < %(end)s """ df = pd.read_sql( sql, engine, params={ 'start': yesterday, 'end': yesterday + pd.Timedelta(days=1) } ) df.to_excel(f"日报_{yesterday.date()}.xlsx", index=False) print("SQLAlchemy方式导入完成!")
5. Python方案的核心优势解析
(1)参数化查询,防SQL注入
pd.read_sql(sql, conn, params=[yesterday])
这是非常重要的安全特性。VBA中拼接SQL字符串:
sql = "WHERE event_time >= '" & startDate & "'"
一旦 startDate被恶意构造,就可能发生SQL注入。
(2)数据类型自动推断
Pandas会自动将数据库字段映射为合适的DataFrame dtype:
DATE → datetime64
INT → int64
VARCHAR → object
DECIMAL → float64
而VBA中,日期可能被转为字符串,数字可能被转为文本。
(3)链式操作与数据加工一体化
df['hour'] = df['event_time'].dt.hourdf['is_weekend'] = df['event_time'].dt.weekday >= 5
在VBA中,这需要循环遍历每一行,性能和可读性都差很多。
(4)多Sheet输出天然支持
一个Excel文件,多个Sheet,Pandas一行代码搞定。VBA需要逐个Sheet操作。
四、VBA ADO vs Python Pandas:深度对照
这是本文的核心价值,我们从多个维度进行对比:
对比维度 | VBA + ADO | Python + Pandas |
|---|
抽象层级 | 底层(Connection / Recordset) | 高层(DataFrame / read_sql) |
代码复杂度 | 高(需手动管理连接、游标) | 低(一行读取,自动管理) |
SQL注入防护 | 弱(字符串拼接为主) | 强(参数化查询内置) |
数据类型安全 | 一般(隐式转换多) | 优秀(显式dtype管理) |
数据处理能力 | 弱(需循环处理) | 极强(向量化操作) |
多Sheet输出 | 繁琐 | 原生支持 |
跨数据库兼容 | 需改连接字符串+驱动 | SQLAlchemy统一接口 |
运行环境 | Windows + Excel | 全平台(Win/Mac/Linux) |
调度友好性 | 需Windows任务计划 | Airflow / Cron / 任务计划 |
学习曲线 | 中等(需懂COM对象) | 中等(需懂Python/Pandas) |
调试体验 | 一般(错误信息模糊) | 优秀(异常栈清晰) |
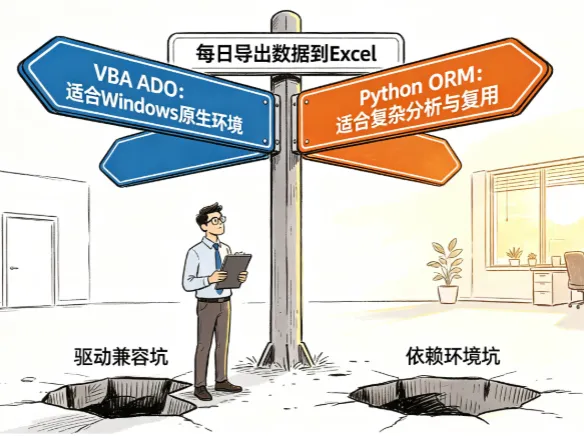
生产稳定性 | 依赖ODBC驱动 | 依赖Python环境 |
适用人群 | Excel深度用户、老系统维护 | 数据分析师、数据工程师 |
五、实战中的关键技术决策
1. 什么时候选VBA?
✅ 以下场景优先考虑VBA:
报表使用者只会用Excel,不懂命令行
公司禁止安装Python环境
数据量不大(<10万行)
报表需要频繁手动调整
历史遗留系统,大量VBA代码已存在
2. 什么时候选Python?
✅ 以下场景优先考虑Python:
数据量较大(>10万行)
需要复杂的数据清洗和聚合
需要接入自动化调度系统
需要复用代码到多个项目
团队已经有一定Python基础
需要对接多种数据源(API + DB + Excel)
3. 折中方案:VBA调用Python
如果你处于过渡期,可以采用混合架构:
VBA负责Excel交互界面
VBA通过 Shell命令调用Python脚本
Python负责数据拉取和处理
Python输出Excel,VBA刷新展示
Sub RunPythonScript() Dim pythonExe As String Dim scriptPath As String Dim cmd As String pythonExe = """C:\Python39\python.exe""" scriptPath = """C:\scripts\import_data.py""" cmd = pythonExe & " " & scriptPath Shell cmd, vbNormalFocusEnd Sub
六、常见坑点与避坑指南
坑点1:VBA中文乱码
原因:ODBC驱动字符集不匹配
解决:
conn.ConnectionString = _ "Driver={MySQL ODBC 8.0 Unicode Driver};" & _ "charset=utf8mb4;" ' 一定要用Unicode驱动
坑点2:Python连接超时
原因:网络不稳定或查询太慢
解决:
conn = pymysql.connect( connect_timeout=60, # 连接超时 read_timeout=300, # 读取超时 write_timeout=300)
坑点3:VBA内存溢出(大数据量)
原因:Recordset一次性加载全部数据
解决:分页查询
sql = sql & " LIMIT 10000 OFFSET " & offset
坑点4:Pandas写入Excel太慢
原因:逐行写入
解决:使用 openpyxl引擎 + 关闭索引
df.to_excel(writer, index=False) # 一定要关index
坑点5:时区问题
现象:数据库时间是UTC,Excel显示是本地时间
解决(Python):
df['event_time'] = pd.to_datetime(df['event_time']).dt.tz_convert('Asia/Shanghai')
七、性能优化实战
VBA性能优化
Application.ScreenUpdating = FalseApplication.Calculation = xlCalculationManualApplication.EnableEvents = False' ... 数据导入代码 ...Application.ScreenUpdating = TrueApplication.Calculation = xlCalculationAutomaticApplication.EnableEvents = True
Python性能优化
# 1. 只查需要的列sql = "SELECT user_id, event_time FROM table"# 2. 使用迭代器(大数据量)for chunk in pd.read_sql(sql, conn, chunksize=10000): process_chunk(chunk)# 3. 指定数据类型,减少推断开销dtypes = {'user_id': 'int32', 'event_type': 'category'}df = pd.read_sql(sql, conn, dtype=dtypes)
八、安全规范(非常重要)
无论用哪种方案,生产环境务必遵守以下规范:
禁止硬编码密码
VBA:使用Windows凭据管理器或配置文件
Python:使用环境变量或config文件
import ospassword = os.getenv('DB_PASSWORD')
最小权限原则
报表账号只给SELECT权限
禁止GRANT ALL PRIVILEGES
日志审计
九、总结与思考
回到我们的主题:从数据库导入数据到Excel。
通过这一讲的深入对比,我们可以清晰地看到:
VBA + ADO 是贴近系统的原生方案,稳定、直接,但抽象层次低,开发效率低
Python + Pandas 是面向数据的现代方案,抽象程度高,开发效率高,生态完善
两者并不是简单的“谁替代谁”,而是各司其职:
VBA适合“人在Excel里干活”的场景;Python适合“数据自动流转”的场景。
对于数据分析师来说,我的建议是:
短期:掌握VBA ADO,应对紧急需求
中期:系统学习Python + Pandas
长期:建立数据自动化思维,让工具为人服务
当你能熟练在这两套技术之间切换时,你就真正拥有了数据自动化的自由。
十、课后练习(选择题)
1. 关于VBA中 CopyFromRecordset方法,下列说法正确的是?
A. 它会自动将数据库NULL值转换为0
B. 它比循环逐个单元格写入效率更高
C. 它只能用于MySQL数据库
D. 它不支持写入超过65536行数据
2. Python的 pandas.read_sql()相比VBA ADO的最大优势是?
A. 不需要安装任何驱动
B. 自动进行参数化查询,有效防止SQL注入
C. 只能在Windows系统运行
D. 可以直接修改数据库中的数据
3. 在VBA ADO连接字符串中,使用 {MySQL ODBC 8.0 Unicode Driver}的主要目的是?
A. 提高查询速度
B. 支持UTF-8等多字节字符集,防止中文乱码
C. 允许写入数据到数据库
D. 减少内存占用
4. 以下关于两种方案数据类型处理的表述,正确的是?
A. VBA会自动将数据库日期字段转换为Python的datetime对象
B. Pandas会根据数据库字段类型自动推断DataFrame的dtype
C. VBA和Python在处理NULL值时行为完全一致
D. Pandas无法处理DECIMAL类型的字段
5. 在一个需要每天自动运行、数据量为200万行的生产环境中,最合适的方案是?
A. VBA + ADO + Windows任务计划
B. Python + Pandas + Airflow/Cron调度
C. 手动打开Excel运行VBA宏
D. Excel Power Query(不写代码)
参考答案
B —— CopyFromRecordset是批量写入方法,性能远优于循环写入;NULL值会被转为空单元格而非0。
B —— read_sql原生支持 params参数化查询,从根本上防范SQL注入;其他选项均有明显错误。
B —— Unicode驱动的核心价值是正确处理多字节字符(如中文),避免乱码问题。
B —— Pandas具备强大的类型推断能力;VBA没有datetime对象概念;两者NULL处理机制不同。
B —— 200万行属于大数据量,Python + Pandas在性能、稳定性和调度友好性上全面优于VBA方案。