《Python深度学习基于PyTorch(第2版)》—习题集第3集
【提要】回顾神经网络的发展历程,同时介绍一些最新技术如HC,mHC等。
习题:神经网络的发展历程可谓好事多磨。自1958年感知机首次提出以来,神经网络迎来了第一次热潮;但随后因无法解决“异或”等非线性问题,陷入了第一次寒冬。
直到1986年,反向传播(BP)算法的普及成功突破了多层网络的训练瓶颈,掀起了第二次高潮;然而,受限于算力不足、数据匮乏以及严重的“梯度消失”问题,深层网络难以训练,导致神经网络在效率和性能上被支持向量机(SVM)等统计学习方法碾压,进入了漫长的第二次寒冬。
直到2012年,随着海量数据集、GPU算力爆发及各类优化技术的成熟,以AlexNet为代表的深度学习终于迎来了真正的春天!
请结合上述背景,从模型结构、训练算法、工程实践三个维度,详细论述在第一次、第二次AI寒冬中,神经网络各自遭遇了哪些核心瓶颈?人们又是通过哪些关键的技术突破来解决这些瓶颈的?
【参考答案】:
先从模型结构、训练算法、工程实践三个维度分别进行简要说明,然后根据指定内容展开详细说明。
1、从模型结构来看
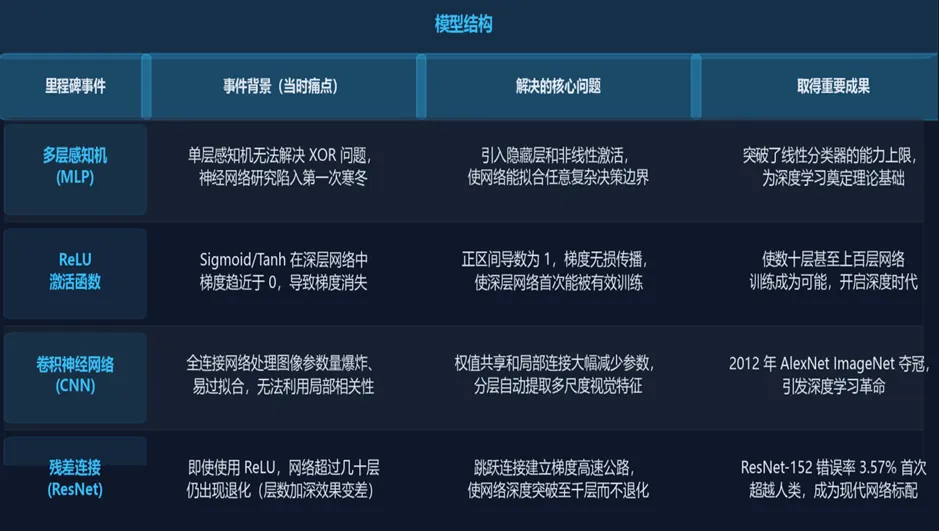
2、从训练算法来看
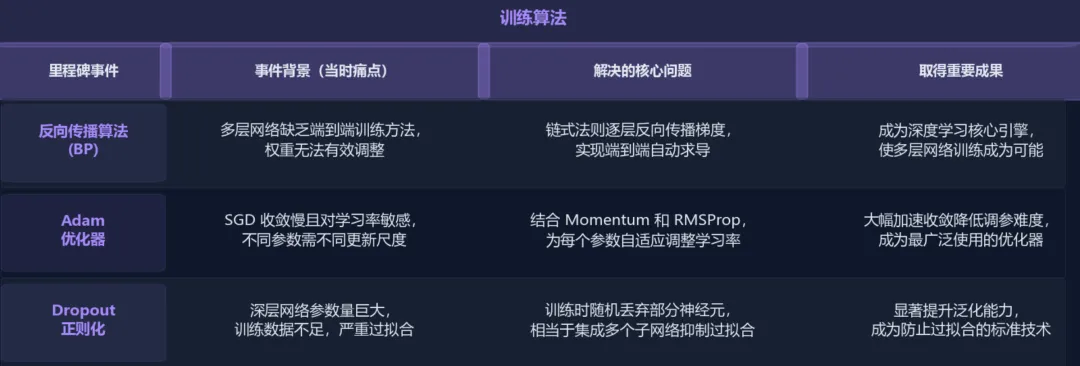
3、从工程实践来看
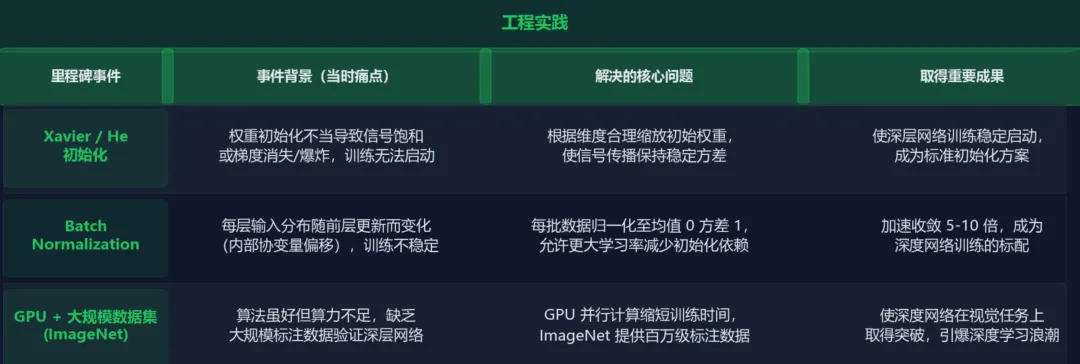
一、 ReLU激活函数的广泛采用
在深层网络中用ReLU激活函数取代Sigmoid/Tanh激活函数的原因:
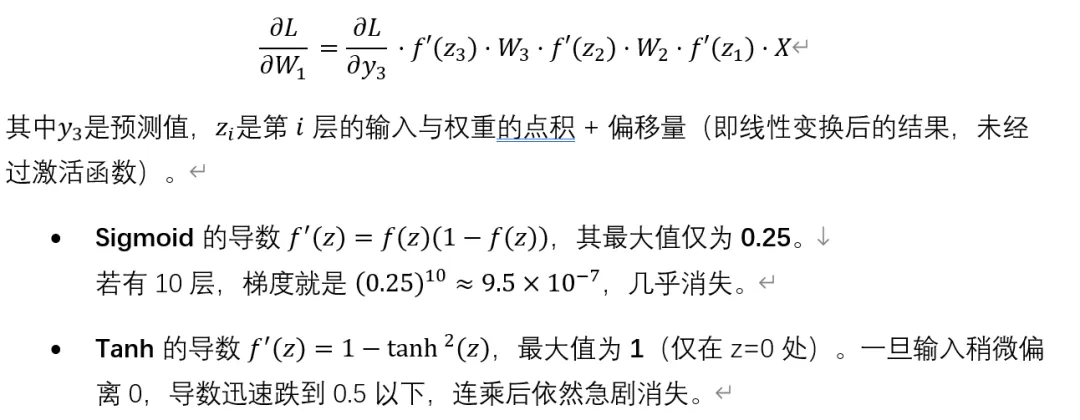
1.使用sigmoid激活函数,在深层网络中导数趋近于0,导致梯度消失,网络难以加深;而ReLU激活函数可以有效避免这个问题。
梯度消失的根本原因(链式法则乘积)
·ReLU 的导数在正区间恒为 1(负区间为0)。 连乘时,正区的梯度“乘法因子”是1,不会放大也不会衰减,彻底消除了由激活函数引起的梯度消失问题。
·ReLU 负数区间梯度恒为 0,若神经元长期接收负输入,会永久失活(神经元死亡);因此后续衍生出带微小负斜率的激活函数【如LeakyReLU/GELU等】,但不影响 ReLU 作为深度学习基础激活函数的主流地位。
2.计算开销的天壤之别
·Sigmoid/Tanh:涉及指数运算  ,以及除法,计算成本高。在百万、亿级参数的网络中,这个开销会被放大成千上万倍。
·ReLU:只需一个简单的判断 if x > 0 then x else 0。没有任何乘幂、除法或三角函数。这个差异在GPU上意味着更快的训练迭代速度。
【激活函数的优化,使神经网络可以扩展到几十上百、成千。但随着层数的增加,新的问题也随之来了,即出现退化问题(层数加深反而不收敛),这个问题如何解决?】
二、残差连接(ResNet)
1.提出的背景:退化问题(Degradation Problem)
在 ResNet 出现之前,深度学习社区普遍认为:网络越深,表达能力越强。VGGNet(19层)和 GoogLeNet(22层)的成功似乎印证了这一点。然而,当研究者尝试将网络堆叠到 30 层、50 层甚至更深时,一个反直觉的现象出现了:
训练误差不降反升——56 层的普通网络(Plain Network)在训练集上的表现反而比 20 层的更差。
这不是过拟合(overfitting),因为过拟合的表现是训练误差低、验证误差高;而退化问题是训练误差本身就更高。
关键观察:即使使用了 ReLU 激活函数、Batch Normalization、精心初始化等技术,当深度超过约 20-30 层后,网络优化变得极其困难,出现退化。
何恺明等人通过实验证明——问题不在梯度信号丢失,而在优化本身。深层网络中的非线性层堆叠,无法通过随机梯度下降有效逼近“什么都不做”的恒等映射(即 )。这个反常识的发现,催生了残差连接。
2.如何解决退化问题?
直观理解:让一个学生直接抄写整本书(拟合 )很难;但让他只修改书上的错别字(拟合残差
 )就简单得多。
ResNet将目标从“直接拟合”到“差分拟合”的范式转移,即拟合目标从 改为
 ,最终输出为
 。若最优解就是
 本身,网络只需让
 的权重趋近0即可——权重稀疏化远比强行构造单位矩阵容易。
3. 正常块到残差块
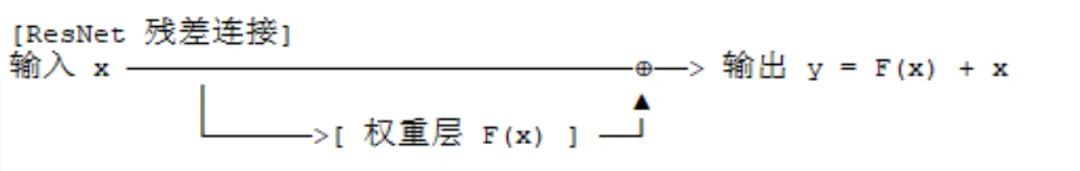 ResNet相当于给每个人发了一张写着原始信息的纸条。轮到某个人时,他不仅听上一个人的悄悄话(经过处理的特征),还可以直接把纸条上的原话加进去。这样哪怕中间有人没听清,原始信息依然能准确传下去。
4.ResNet取得了哪些好的效果?
·打破深度瓶颈:
ResNet使得训练数百甚至上千层的网络成为现实(如ResNet-152),彻底解决了深度网络的退化问题57。
·统治级性能:
在2015年ImageNet竞赛中,ResNet以压倒性优势夺冠。
·奠定大模型基石:
ResNet的残差连接思想被后来的Transformer架构(GPT、LLaMA等)、Diffusion模型(U-Net残差块)等原封不动地继承,成为支撑当今万亿参数大语言模型训练的“地基”。
5. ResNet存在的不足
传统残差:视觉 CNN 常规极限 100–200 层;大模型 Transformer 通常 32–128 层,继续加深易出现表征坍塌、收敛变慢。主要原因如下:
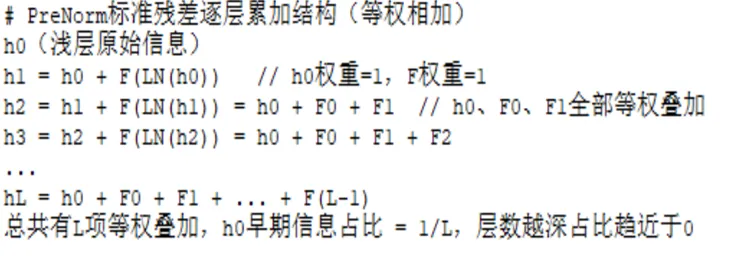
·信息稀释(PreNorm稀释):
标准残差连接中的加法是“等权”的。随着层数增加,早期层的信息在深层隐藏状态中逐渐被稀释,模型无法根据当前输入动态判断哪一层的信息更重要。
·有效感受野受限:
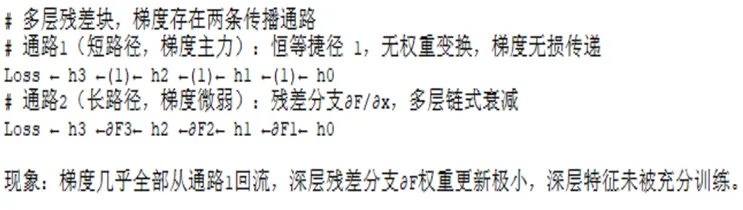
虽然网络堆叠了很多层,但实质上大部分梯度是沿着较短的路径传播的(梯度偏好短路径,名义深度≠有效深度),导致深层网络的有效深度并不够,有效感受野并没有理论上那么大。
·通道宽度瓶颈:
传统的残差流是单一的,通道宽度固定,限制了层与层之间更复杂的特征交互。
6. HC 与 mHC 技术的背景、突破与局限
为了突破ResNet的瓶颈,字节跳动团队于2024年提出了超连接(Hyper-Connections, HC),HC 原生小模型实验:视觉网络可稳定堆叠至300 层以上;LLM 可轻松扩展至 200 层以上基础块,同等层数下困惑度、准确率显著优于标准残差。
·HC 突破:
将残差流从1路扩展到 n 路,引入可学习的 Read(A)/Mix(B)/Write(C) 矩阵,实现动态融合。
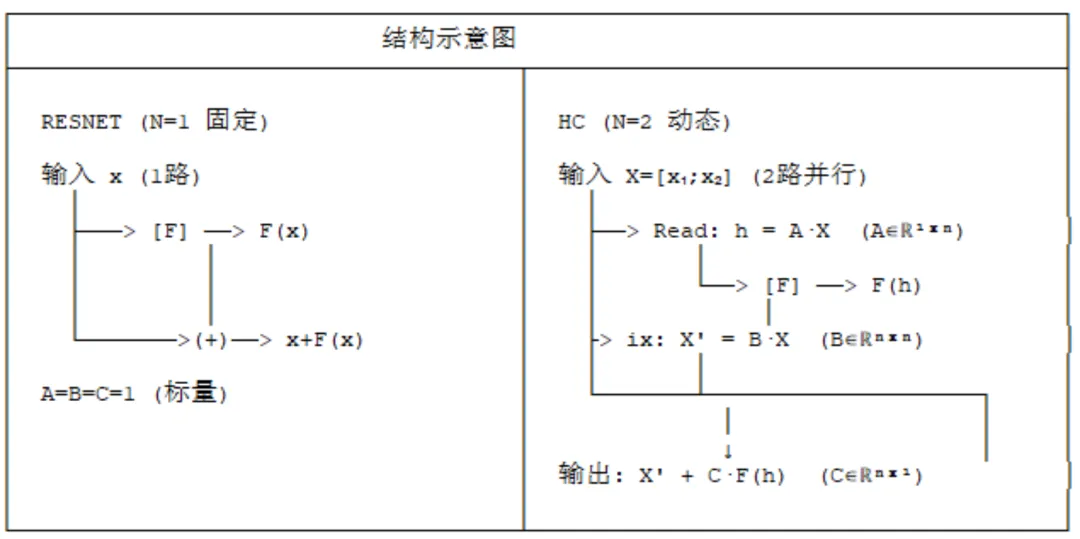
Xₗ₊₁ = Bₗ·Xₗ + Cₗ·F(Aₗ·Xₗ)
Read 矩阵 A:聚合 n 路残差流为单路,决定"看哪些路"
Mix 矩阵 B:残差流间交互,B∈ℝⁿˣⁿ 无约束,实现跨路信息混合
Write 矩阵 C:将变换结果广播回 n 路,C∈ℝⁿˣ¹
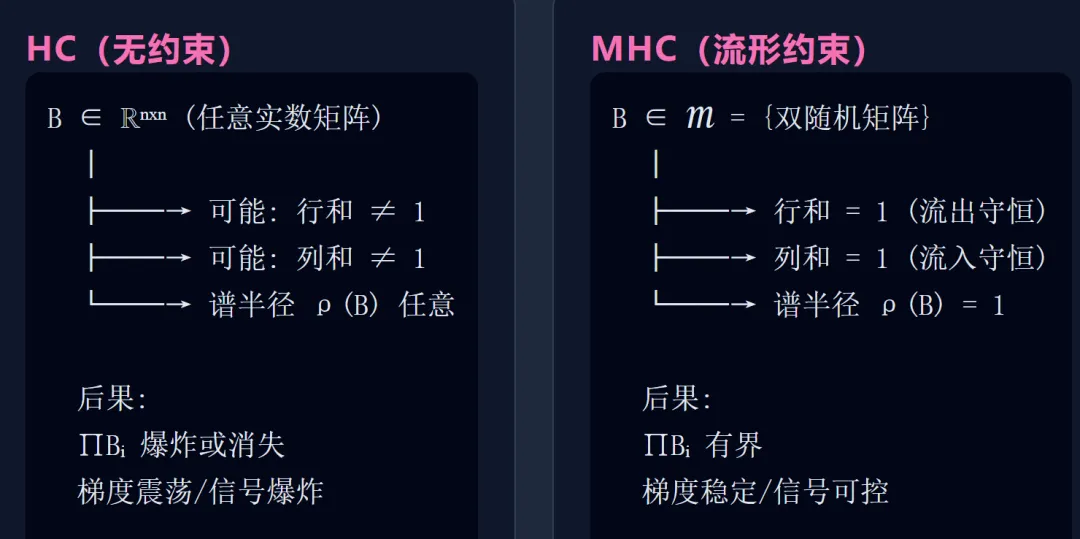
递归展开:X_L = (∏Bᵢ)Xₗ + ...,但 ∏Bᵢ 无约束 → 谱半径失控!
·HC 的不足:
27B 模型训练中出现梯度范数震荡 3000 倍、Loss Spike,根本原因是 Mix 矩阵 B 破坏了恒等映射性质。犹如马路更宽了,但缺少信号灯,为改变这种情况,DeepSeek团队于2026年初提出了改进版流形约束超连接(mHC),通过双随机矩阵流形约束修复 HC 缺陷,mHC犹如给"信息高速路"装上"红绿灯"。修改后的模型稳定性、网络规模有了明显改善。
·mHC 方案:
如何给"多车道高速"装上"智能导航+限速",咋么来实现呢?具体来说:
将 B 约束在双随机矩阵流形上(行和=1, 列和=1),通过 Sinkhorn 迭代投影,恢复恒等映射的稳定性。
三、初始化与正则化
1. 初始化方法提出的核心动机
深度神经网络训练的核心痛点是信号与梯度的方差失稳:若权重初始化不当,前向传播中激活值的方差会逐层放大或衰减,反向传播中梯度也会出现爆炸或消失,导致深层网络参数无法有效更新,训练难以收敛。早期的随机高斯 / 均匀初始化完全忽略网络深度与激活函数特性,深层网络极易出现梯度消失,往往需要依赖逐层预训练才能勉强训练。
·Xavier 初始化(Glorot & Bengio, 2010)
首次提出方差一致性原则:让前向传播中每层激活值的方差保持恒定,反向传播中每层梯度的方差也保持恒定,保证信号在深层网络中有效传递。它针对 Tanh、Sigmoid 等对称饱和型激活函数设计,解决了当时深层全连接网络无需预训练即可端到端训练的难题。
·He 初始化(何恺明等,2015)
ReLU 成为主流激活函数后,Xavier 初始化完全失效:ReLU 将负半轴输出置 0,破坏了零均值假设,导致激活值方差逐层衰减,最终梯度消失。He 初始化针对 ReLU 及其变体修正了方差推导,让深层卷积网络(如 VGG、ResNet)可以稳定训练,是现代深度学习最常用的初始化方案。
·Batch Normalization(Ioffe & Szegedy, 2015)的关联
与初始化目标同源:解决内部协变量偏移,即每层输入分布随参数更新而偏移的问题。区别在于:初始化从参数初始值入手,保证训练初始阶段的方差稳定;BN 则在训练全程主动归一化每层输入,大幅降低网络对初始化的敏感度,二者常配合使用。
2.通过实例进行验证
网络结构:4层卷积(1→32→64→128→256)+ 2层全连接,使用BatchNorm和MaxPool。
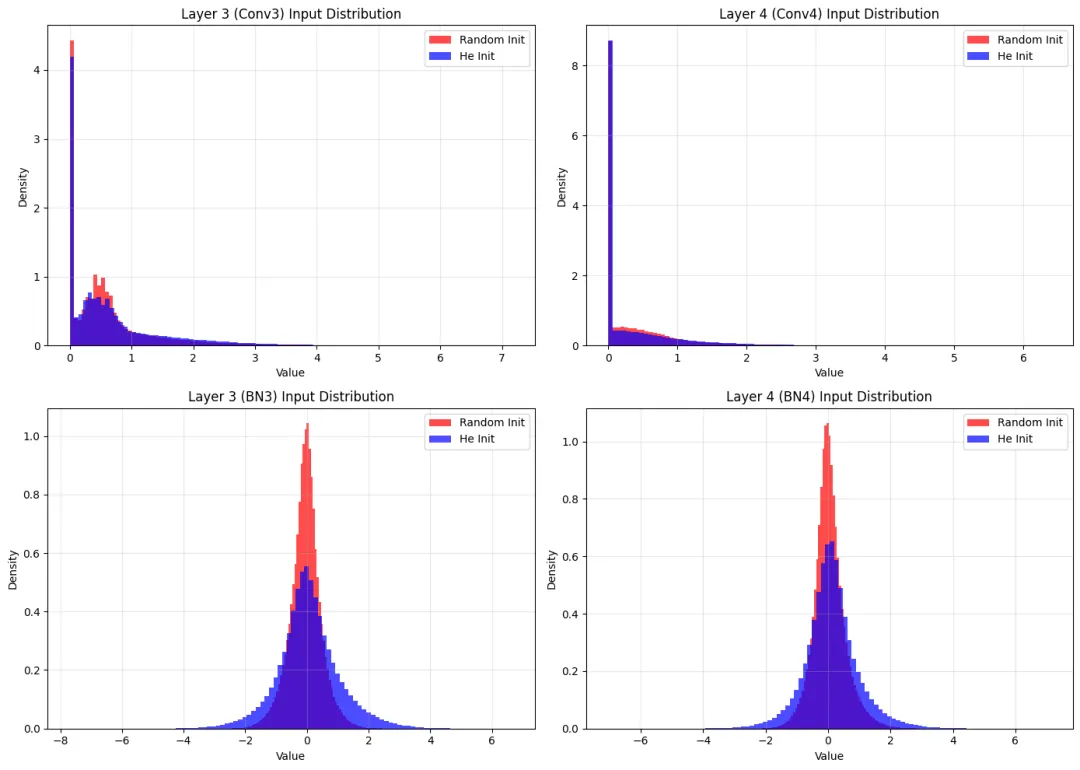
·随机初始化:由于初始权重过小,深层(第3、4层)输入分布会集中在0附近,方差较小,导致梯度消失
·He初始化:保持各层输入方差大致恒定,第3、4层输入分布更分散,有利于梯度传播和训练稳定。
3. 数学表达式与推导逻辑
特性 | Xavier 初始化 | He 初始化 |
年份/作者 | 2010, Glorot & Bengio | 2015, 何恺明等 |
目标激活函数 | Tanh / Sigmoid(线性区) | ReLU / PReLU / Leaky ReLU |
正态分布方差 | 
| 
|
均匀分布范围 | 
| 
|
核心假设 | 激活函数近似线性 | 激活函数为 ReLU(半激活) |
约束方向 | 前向 + 反向折中 | 主要约束前向(fan_in) |
【说明】
其中  为该层输入维度(fan_in),
 为该层输出维度(fan_out)。

 10个月宝宝每天需要喝多少奶粉?