一、先把 multiprocessing 当成进程版 threading
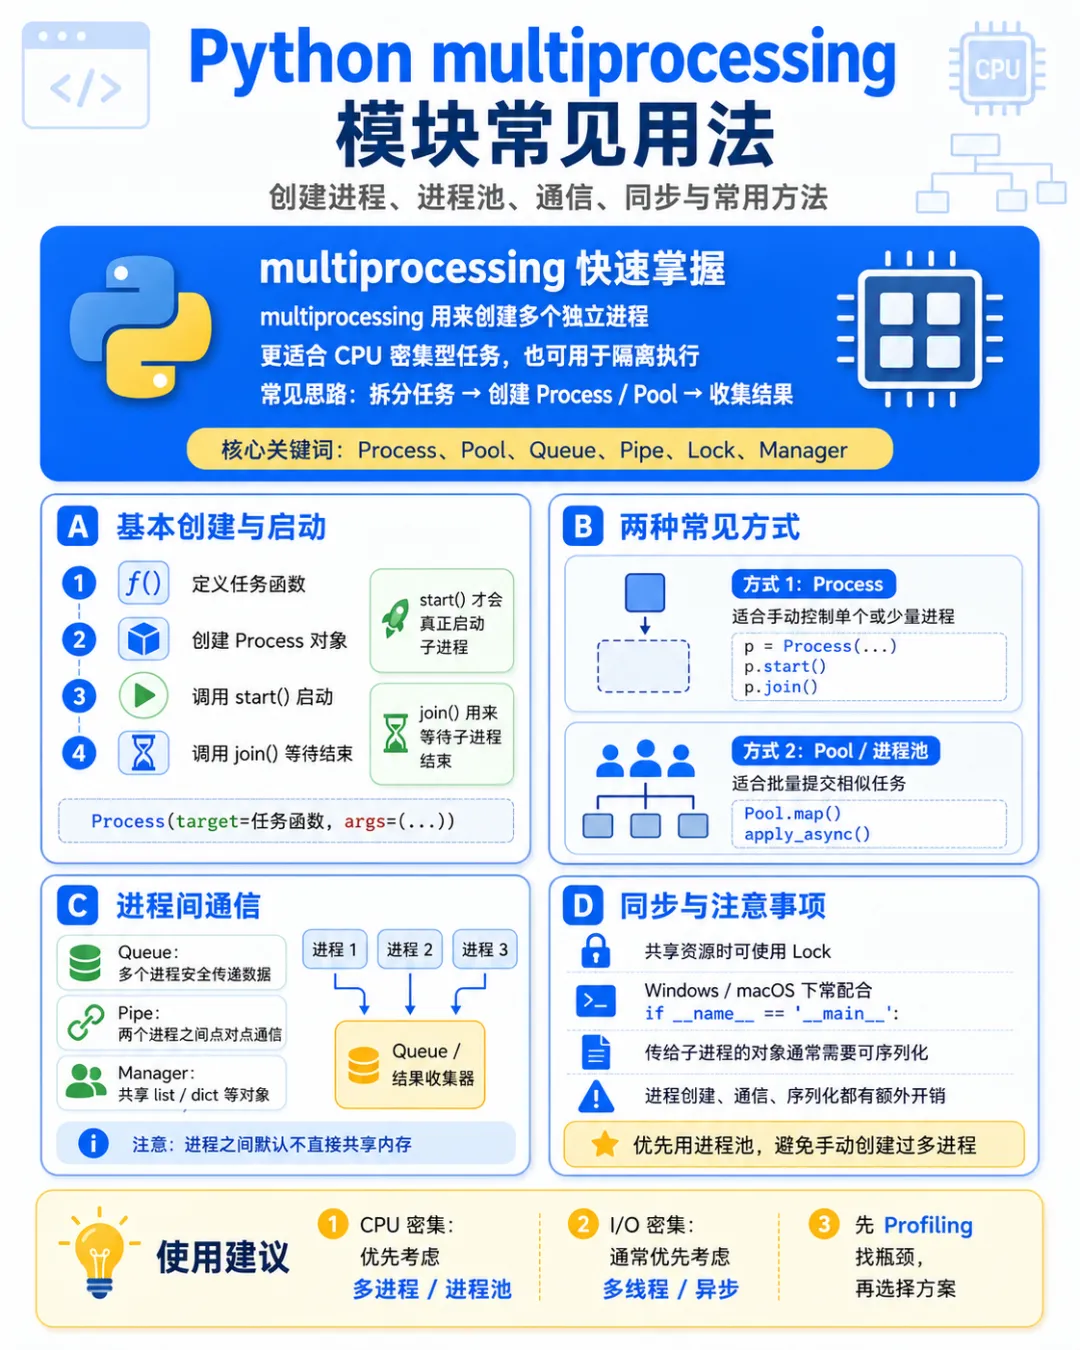
multiprocessing 是 Python 标准库里专门做多进程开发的模块。它最大的特点是,很多使用方式和 threading 很像,学起来不至于完全陌生。
如果你已经会用线程,那么可以先这样理解:
threading.Thread 对应线程multiprocessing.Process 对应进程
线程适合等待型任务 进程适合计算型任务
所以这章的重点,不再是解释什么叫进程,而是把这个模块里最常见、最实用的操作方式真正掌握。
二、最基础的 Process 用法
最常见的入口就是 Process 类。
import multiprocessingimport timedeftask(): print("子进程开始执行") time.sleep(2) print("子进程执行结束")if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() p.join() print("主进程结束")
这段代码里最核心的四个点:
Process() 创建进程对象target 指定子进程要执行的函数start() 启动进程join() 等待进程结束
你可以把它看成多进程开发的最小骨架。 后面无论你是做批量计算、批量处理文件,还是做结果收集,这个骨架都绕不过去。
三、为什么 if name == "main" 几乎不能省
这是 multiprocessing 里最容易被忽略,但又最关键的规范之一。
正确写法:
if __name__ == "__main__":# 创建并启动进程
原因是子进程启动时,某些系统会重新导入当前模块。如果你把创建进程的代码直接写在最外层,子进程导入时就可能再次执行这些代码,造成重复创建、递归启动,程序很容易乱掉。
所以你现在不用死抠底层细节,但一定要养成习惯:
只要写 multiprocessing,几乎默认就把进程启动逻辑放进 if __name__ == "__main__": 下面。
四、给进程传参
和线程一样,进程执行的函数往往要带参数。
import multiprocessingimport timedeftask(name, seconds): print(f"{name} 开始执行") time.sleep(seconds) print(f"{name} 执行结束")if __name__ == "__main__": p = multiprocessing.Process(target=task, args=("任务A", 2)) p.start() p.join()
这里的 args 依然是元组。
只有一个参数时,要写成这样:
args=("任务A",)
如果你忘了逗号,就不是元组了。
也可以传关键字参数:
import multiprocessingdeftask(name, age): print(name, age)if __name__ == "__main__": p = multiprocessing.Process( target=task, kwargs={"name": "小王", "age": 20} ) p.start() p.join()
实际开发里,参数稍多时,kwargs 可读性会更好一些。
五、一次启动多个进程
多进程真正的价值,当然不是只开一个进程,而是把任务拆分给多个进程去处理。
import multiprocessingimport timedeftask(name): print(f"{name} 开始") time.sleep(2) print(f"{name} 结束")if __name__ == "__main__": p1 = multiprocessing.Process(target=task, args=("进程1",)) p2 = multiprocessing.Process(target=task, args=("进程2",)) p3 = multiprocessing.Process(target=task, args=("进程3",)) p1.start() p2.start() p3.start() p1.join() p2.join() p3.join() print("全部完成")
这种写法适合你先理解结构。 但如果任务很多,手动写 p1、p2、p3 很快就会变得很笨。更常见的写法是循环创建。
import multiprocessingimport timedeftask(name): print(f"{name} 开始") time.sleep(2) print(f"{name} 结束")if __name__ == "__main__": processes = []for i in range(5): p = multiprocessing.Process(target=task, args=(f"进程{i+1}",)) processes.append(p) p.start()for p in processes: p.join() print("所有进程执行完毕")
这才是更接近实战的常规写法。
六、name 参数:给进程起名字,调试更清楚
进程多了之后,打印日志很容易看花眼。 这时候可以给进程命名。
import multiprocessingimport timedeftask(): print("当前进程开始工作") time.sleep(1)if __name__ == "__main__": p1 = multiprocessing.Process(target=task, name="计算进程") p2 = multiprocessing.Process(target=task, name="统计进程") p1.start() p2.start() p1.join() p2.join()
命名以后,在日志、排错、查看进程信息时都会更直观。
七、current_process:查看当前进程是谁
这个方法非常实用,尤其适合调试。
import multiprocessingdeftask(): print("子进程对象:", multiprocessing.current_process())if __name__ == "__main__": print("主进程对象:", multiprocessing.current_process()) p = multiprocessing.Process(target=task, name="工作进程") p.start() p.join()
如果你只想看名字,也可以这样写:
print(multiprocessing.current_process().name)
你以后写多进程日志时,完全可以把进程名打出来,排查问题会轻松很多。
八、pid:查看进程编号
每个进程在操作系统里都有自己的进程号,也就是 PID。
import multiprocessingimport osdeftask(): print("子进程 PID:", os.getpid())if __name__ == "__main__": print("主进程 PID:", os.getpid()) p = multiprocessing.Process(target=task) p.start() p.join()
你会看到主进程和子进程的 PID 不同。 这能帮助你更直观地理解:多进程不是在同一个执行单元里切来切去,而是真正启动了新的进程实例。
另外,Process 对象本身也有 pid 属性:
import multiprocessingimport timedeftask(): time.sleep(1)if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() print("子进程 PID:", p.pid) p.join()
九、join 的常见用法不只是等待,还能设置超时
基础用法你已经见过了:
p.join()
这表示一直等到子进程结束。
但有时候你不想无限等,比如最多等 3 秒,超过还没结束,就继续做别的事。这时可以传超时时间:
import multiprocessingimport timedeftask(): time.sleep(5) print("任务完成")if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() p.join(timeout=2) print("主进程继续往下执行")
这里的意思是:
主进程最多等 2 秒 如果子进程还没结束,主进程就先继续
这在某些需要超时控制的场景里很实用,比如:
只允许某个计算任务最多跑几秒 等待外部子任务,但不想主流程被一直拖住 做任务监控时限制等待时间
十、is_alive:判断进程是否还活着
和线程类似,进程对象也能判断自己是否仍在运行。
import multiprocessingimport timedeftask(): time.sleep(3)if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() print(p.is_alive()) # 一般是 True time.sleep(4) print(p.is_alive()) # 一般是 False
这个方法的价值在于:
你不一定立刻 join(),但你可以先观察任务状态。 比如有些监控程序、任务调度程序,就需要轮询子进程是否还活着。
十一、exitcode:查看子进程是否正常结束
进程执行完之后,可以通过 exitcode 看结束状态。
import multiprocessingdeftask(): print("任务执行中")if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() p.join() print("退出码:", p.exitcode)
一般来说:
0 表示正常结束 非 0 往往表示异常退出或被强制终止
这个属性在批处理任务里很有用。 你一次启动多个子进程,最后可以统一检查哪些进程正常完成,哪些进程出了问题。
十二、terminate:强制结束进程
有时候某个子进程卡住了,或者你根本不想再让它继续执行,就可以用 terminate()。
import multiprocessingimport timedeftask():for i in range(10): print(f"运行中 {i}") time.sleep(1)if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() time.sleep(3) p.terminate() p.join() print("子进程已被终止")
这相当于直接把子进程结束掉。
但你一定要知道,terminate() 很“硬”。 它不是温柔地让任务收尾,而是强行停止。
所以如果子进程正在写文件、写数据库、处理关键数据,贸然 terminate() 可能导致数据不完整、状态异常。
适合使用它的情况通常是:
测试环境里中断一个死循环 某个计算任务已经没必要继续 子进程明显失控,需要强制关闭
十三、daemon:守护进程
进程也可以设置成守护进程。
import multiprocessingimport timedeftask():whileTrue: print("守护进程运行中") time.sleep(1)if __name__ == "__main__": p = multiprocessing.Process(target=task, daemon=True) p.start() time.sleep(3) print("主进程结束")
守护进程的特点是:
主进程一结束,它通常也会跟着结束。 不会像普通子进程那样继续单独跑下去。
这种机制适合做辅助型后台工作,比如:
状态上报 临时日志监听 非关键监控任务
但凡涉及核心业务处理,守护进程都要谨慎。 因为主进程一结束,它可能直接被带走,来不及善后。
十四、cpu_count:查看机器 CPU 核心数
既然多进程常常和 CPU 密集型任务有关,那你就应该知道当前机器大概有多少核。
import multiprocessingif __name__ == "__main__": print("CPU 核心数:", multiprocessing.cpu_count())
这个函数很常用,尤其是在你要决定开多少个进程时。
比如你有 8 核 CPU,就不太可能无限制地开 100 个计算进程还能持续高效。 很多情况下,进程数会参考核心数来设置。
当然也不是绝对必须一比一。 有的任务适合开和核心数接近的进程数,有的任务则要结合内存、数据量、任务耗时来综合判断。
但至少你得先知道机器资源大概是什么水平。
十五、Queue:进程之间传数据的常见方式
线程能共享变量,进程默认不能。 所以多进程程序里,数据怎么传,是个绕不开的问题。
最常见的方法之一就是 Queue,也就是队列。
你可以把它理解成一个安全的传递箱。 一个进程往里面放数据,另一个进程从里面取数据。
import multiprocessingdefworker(q): result = 1 + 2 + 3 q.put(result)if __name__ == "__main__": q = multiprocessing.Queue() p = multiprocessing.Process(target=worker, args=(q,)) p.start() p.join() print("子进程返回的结果:", q.get())
这里的流程很清楚:
主进程创建一个队列 把队列传给子进程 子进程把结果放进去 主进程再把结果取出来
这就是进程之间非常基础、非常高频的通信方式。
十六、多个子进程如何把结果交回主进程
看一个稍微更实战一点的例子。 假设我们把大任务拆成多个小任务,每个子进程算一部分结果,再交回主进程汇总。
import multiprocessingdefcompute(start, end, q): total = 0for i in range(start, end): total += i q.put(total)if __name__ == "__main__": q = multiprocessing.Queue() processes = [] ranges = [ (0, 250000), (250000, 500000), (500000, 750000), (750000, 1000000) ]for start, end in ranges: p = multiprocessing.Process(target=compute, args=(start, end, q)) processes.append(p) p.start()for p in processes: p.join() final_result = 0for _ in ranges: final_result += q.get() print("最终结果:", final_result)
这个结构非常重要。
因为真正的多进程项目,通常不只是把任务拆开,还要把拆开的结果再合回来。 而 Queue 正是最常见的结果回传手段之一。
十七、Pool:批量处理任务时最常用的工具之一
如果你每次都手动创建很多 Process 对象,其实会有点麻烦。 这时就轮到 Pool 上场了。
Pool 叫进程池。 你可以把它理解成:先准备好几个固定工位,再把一批任务按顺序分配进去处理。
它特别适合这种场景:
任务很多 每个任务结构差不多 你不想手动管理一堆 Process
十八、Pool 的最基本用法
from multiprocessing import Poolimport osimport timedeftask(name): print(f"{name} 在进程 {os.getpid()} 中执行") time.sleep(1)returnf"{name} 完成"if __name__ == "__main__":with Pool(3) as pool: results = pool.map(task, ["任务1", "任务2", "任务3", "任务4", "任务5"]) print(results)
这里的意思是:
创建一个大小为 3 的进程池 总共有 5 个任务 池里一次最多同时运行 3 个 前面的做完,后面的再补进去
map() 很像内置函数 map,会把列表里的每个元素依次传给目标函数,并返回结果列表。
这在批量计算、批量转换、批量处理数据时非常方便。
十九、Pool.apply 和 Pool.map 的区别
这是很多人刚学进程池时会混的地方。
apply() 更像一次只提交一个任务,阻塞等待结果:
from multiprocessing import Poolimport timedeftask(x): time.sleep(1)return x * xif __name__ == "__main__":with Pool(2) as pool: result = pool.apply(task, args=(5,)) print(result)
它会等这个任务执行完再返回。
而 map() 更适合批量提交一组同类型任务:
from multiprocessing import Pooldeftask(x):return x * xif __name__ == "__main__":with Pool(2) as pool: results = pool.map(task, [1, 2, 3, 4, 5]) print(results)
简单记:
处理一个任务,看 apply()处理一批同结构任务,看 map()
二十、apply_async:异步提交任务
如果你不想提交一个任务后傻等着,也可以用 apply_async()。
from multiprocessing import Poolimport timedeftask(x): time.sleep(2)return x * xif __name__ == "__main__":with Pool(2) as pool: result = pool.apply_async(task, args=(10,)) print("主进程可以先做别的事") value = result.get() print(value)
这里的关键点是:
apply_async() 提交后不会立刻堵住主进程 它会返回一个结果对象 真正要拿结果时,再调用 get()
这个用法非常实用。 因为实际项目里,主进程往往不只是等结果,它还要干别的。
二十一、map 适合单参数,starmap 适合多参数
如果你的任务函数接收多个参数,map() 就不够方便了。 这时候可以用 starmap()。
from multiprocessing import Pooldefadd(a, b):return a + bif __name__ == "__main__":with Pool(2) as pool: results = pool.starmap(add, [(1, 2), (3, 4), (5, 6)]) print(results)
它会自动把元组拆开传进去。
所以你可以记:
一个参数批量处理,用 map()多个参数批量处理,用 starmap()
二十二、close 和 join:进程池收尾时常见的组合
如果你不是用 with Pool(...) as pool: 这种写法,而是手动创建池,就经常要写这两个方法。
from multiprocessing import Pooldeftask(x):return x * 2if __name__ == "__main__": pool = Pool(3) results = pool.map(task, [1, 2, 3, 4, 5]) print(results) pool.close() pool.join()
它们的含义是:
close() 不再接受新任务join() 等待池中的任务全部执行完成
不过现在更推荐直接用 with,因为它更省心,收尾也更规范。
二十三、一个完整小案例:多进程批量计算平方和
下面把 Pool 和结果处理串起来看一个更完整的例子。
from multiprocessing import Poolimport timedefsquare_sum(numbers): total = 0for n in numbers: total += n * nreturn totalif __name__ == "__main__": numbers = list(range(1, 1000001)) chunk_size = len(numbers) // 4 chunks = [ numbers[0:chunk_size], numbers[chunk_size:chunk_size * 2], numbers[chunk_size * 2:chunk_size * 3], numbers[chunk_size * 3:] ] start = time.time()with Pool(4) as pool: results = pool.map(square_sum, chunks) final_result = sum(results) print("最终结果:", final_result) print("耗时:", time.time() - start)
这个案例很有代表性,因为它把多进程常见思路全串起来了:
先拆数据 再交给进程池并行处理 最后收集结果并汇总
很多数据分析、图像处理、文本统计场景,本质上都是这个套路。
二十四、什么时候该直接用 Process,什么时候该用 Pool
这是实战里很重要的判断。
适合直接用 Process 的情况:
任务控制逻辑比较复杂 你需要手动管理某个独立子进程 不同进程做的事差异很大 你要单独控制某个进程的生命周期
适合用 Pool 的情况:
有一大批类似任务 每个任务逻辑差不多 你更关心批量处理效率 你不想手动维护一堆进程对象
简单理解就是:
进程少、控制细,用 Process任务多、模式统一,用 Pool
二十五、multiprocessing 最容易踩的坑
1. 忘记写 if name == "main"
这是第一大坑,尤其是新手最容易中招。
2. 以为进程和线程一样能共享全局变量
线程共享资源,进程默认隔离。这个认知必须牢。
3. 任务太轻还硬上多进程
开进程本身也有成本。轻量任务不一定值。
4. 把进程数开得过多
不是越多越快。核心数、内存、任务类型都要考虑。
5. 该收集结果时却没有设计通信方式
只会把任务拆开,不会把结果收回来,这样程序往往做不完整。
6. 一看到耗时就上多进程
先定位瓶颈。 如果慢在网络、磁盘、数据库,多进程未必是最优答案。
二十六、本章常用模板,最好记住
普通进程模板:
import multiprocessingdefworker(arg): print(f"处理 {arg}")if __name__ == "__main__": processes = []for item in [1, 2, 3]: p = multiprocessing.Process(target=worker, args=(item,)) processes.append(p) p.start()for p in processes: p.join()
进程池模板:
from multiprocessing import Pooldefworker(x):return x * xif __name__ == "__main__":with Pool(4) as pool: results = pool.map(worker, [1, 2, 3, 4, 5]) print(results)
这两个模板,几乎就是入门阶段最常用的骨架。
二十七、练习题
写一个程序,创建 3 个进程,分别打印自己的进程名和 PID。
写一个使用 Queue 的例子,让子进程计算一段数字之和,并把结果传回主进程。
写一个 Pool.map() 例子,对一组数字求平方。
写一个 Pool.starmap() 例子,批量计算多个加法任务。
写一个任务执行很慢的子进程,主进程等待 2 秒后判断它是否还活着,再尝试终止它。
二十八、本章要点整理
multiprocessing.Process 是最基础的进程创建方式。start() 启动进程,join() 等待结束。join(timeout) 可以做超时等待。is_alive() 判断进程是否仍在运行。exitcode 可以查看进程退出状态。terminate() 可以强制结束进程,但要谨慎。Queue 是进程间传递数据的常用工具。Pool 适合批量处理同类型任务。map()、starmap()、apply()、apply_async() 都是进程池高频方法。 进程多不一定快,前提是任务足够重、足够独立、值得拆分。
 10个月宝宝每天需要喝多少奶粉?