新人公众号制作实属不易😭
希望有所收获的宝子们多多支持
↓ ↓ ↓ ↓ 后续会更新更多干货内容
Python 基础知识:集合——去重只是它最简单的能力
一份名单里重复姓名越来越多,你会继续手动删,还是换一种数据结构?
假设你把报名名单、文件扩展名或用户标签保存在列表中。数据少时,重复一两项似乎不难处理;可一旦名单不断追加,手动判断“这个值是否已经出现过”就会变得麻烦,还容易漏掉。
Python 的 集合 set 正适合解决这类问题。它不仅会自动去除重复元素,还擅长进行成员判断,以及比较两组数据的共同项和不同项。
这篇文章会从集合的创建、增删和遍历讲起,再逐步掌握并集、交集、差集、子集、集合推导式、frozenset 与保序去重。读完后,你会知道集合什么时候特别好用,也会知道什么时候不该使用它。
一、集合是什么?
集合是一种保存唯一元素的容器。它最重要的三个特点是:无序、不重复、可变。
1tags ={"Python", "Excel", "Python", "AI"}
2
3print(tags)
4print(len(tags))
集合里虽然写了两次 "Python",最终只会保留一个。由于集合无序,第一行的显示顺序可能因运行环境而不同,但元素内容不变;第二行一定输出 3。
特点 | 含义 | 直接影响 |
无序 | 不按固定位置保存元素 | 不支持索引和切片 |
不重复 | 相等元素只保留一个 | 很适合去重 |
可变 | 可以增删元素 | 普通 set 不能作为字典键 |
元素必须可哈希 | 元素应具有稳定哈希值 | 列表、字典和普通集合不能放入集合 |
先判断是否适合 如果你只关心“有哪些唯一元素”和“某个元素是否存在”,集合通常非常合适;如果你还需要固定顺序、索引位置或保存重复次数,就应考虑列表或字典。 |
二、创建集合:花括号还是 set()?
1. 创建非空集合
最直观的写法是把多个元素放在花括号中:
1numbers ={1, 2, 3}
2colors ={"red", "green", "blue"}
3
4print(type(numbers))
1
2. 空集合必须写 set()
这里有一个非常容易混淆的细节:{} 创建的是空字典,不是空集合。
1empty_set =set()
2empty_dict ={}
3
4print(type(empty_set))
5print(type(empty_dict))
1
2
记忆方法 非空集合可以使用花括号,空集合只能使用 set()。看到单独的 {},应把它理解为空字典。 |
3. 将其他可迭代对象转换成集合
set() 可以接收列表、元组、字符串等可迭代对象,并把其中的元素逐个加入集合。
1print(sorted(set([3, 1, 3, 2, 1])))
2print(sorted(set("banana")))
3print(sorted(set(("red", "blue", "red"))))
1[1, 2, 3]
2['a', 'b', 'n']
3['blue', 'red']
这里使用 sorted() 只是为了让演示结果稳定。它返回的是排序后的列表,并不会让集合本身变成有序容器。
三、集合的增、删、查
1. add() 与 update()
add() 添加一个完整元素;update() 接收可迭代对象,把其中的元素逐个加入集合。
1skills ={"Python", "Excel"}
2
3skills.add("SQL")
4skills.update(["Git", "Python"])
5
6print(sorted(skills))
1['Excel', 'Git', 'Python', 'SQL']
重复加入 "Python" 不会报错,也不会产生第二份。要注意,skills.add(["Git", "SQL"]) 会报 TypeError,因为列表不可哈希;如果想加入多个值,应使用 update()。
2. 四种删除方式怎么选?
方法 | 作用 | 元素不存在时 |
remove(x) | 删除指定元素 | 抛出 KeyError |
discard(x) | 删除指定元素 | 什么也不做 |
pop() | 删除并返回任意元素 | 空集合抛出 KeyError |
clear() | 清空整个集合 | 不会报错 |
1numbers ={1, 2, 3}
2
3numbers.remove(1)
4numbers.discard(99)
5removed = numbers.pop()
6
7print(removed)
8print(numbers)
当元素必须存在时,可以使用 remove(),让异常及时暴露问题;当元素可能不存在时,discard() 更稳妥。
不要误解 pop() 集合没有“第一个”或“最后一个”元素,因此 set.pop() 删除的是任意元素。不要依赖它删除某个固定位置的值。 |
3. 使用 in 做成员判断
集合很适合需要频繁判断“某个值是否允许、是否出现过”的场景,例如扩展名白名单:
1allowed ={"jpg", "png", "gif"}
2
3print("png"in allowed)
4print("exe"notin allowed)
1True
2True
集合通常基于哈希进行成员查找。在数据量较大、需要重复执行 in 判断时,它一般比从头扫描列表更合适。不过,集合的优势是平均情形下的查找效率,不应把它理解为任何情况下都一定更快。
4. 遍历集合时不要依赖顺序
1colors ={"red", "green", "blue"}
2
3for color insorted(colors):
4print(color)
1blue
2green
3red
如果只是逐个处理元素,可以直接遍历集合;如果输出需要稳定、可预测,就先使用 sorted()。
四、四种核心集合运算
集合真正有趣的地方,是它能用非常短的表达式比较两组数据。假设 a 和 b 分别代表两门课程的报名学生编号,那么“所有学生、共同学生、只报一门课的学生”都可以直接计算。
关系 | 运算符 | 方法 | 含义 |
并集 | a | b | a.union(b) | 两边出现过的全部元素 |
交集 | a & b | a.intersection(b) | 两边共同拥有的元素 |
差集 | a - b | a.difference(b) | 左边有、右边没有的元素 |
对称差集 | a ^ b | a.symmetric_difference(b) | 只在其中一边出现的元素 |
1a ={1, 2, 3}
2b ={3, 4, 5}
3
4print(sorted(a | b))
5print(sorted(a & b))
6print(sorted(a - b))
7print(sorted(a ^ b))
1[1, 2, 3, 4, 5]
2[3]
3[1, 2]
4[1, 2, 4, 5]
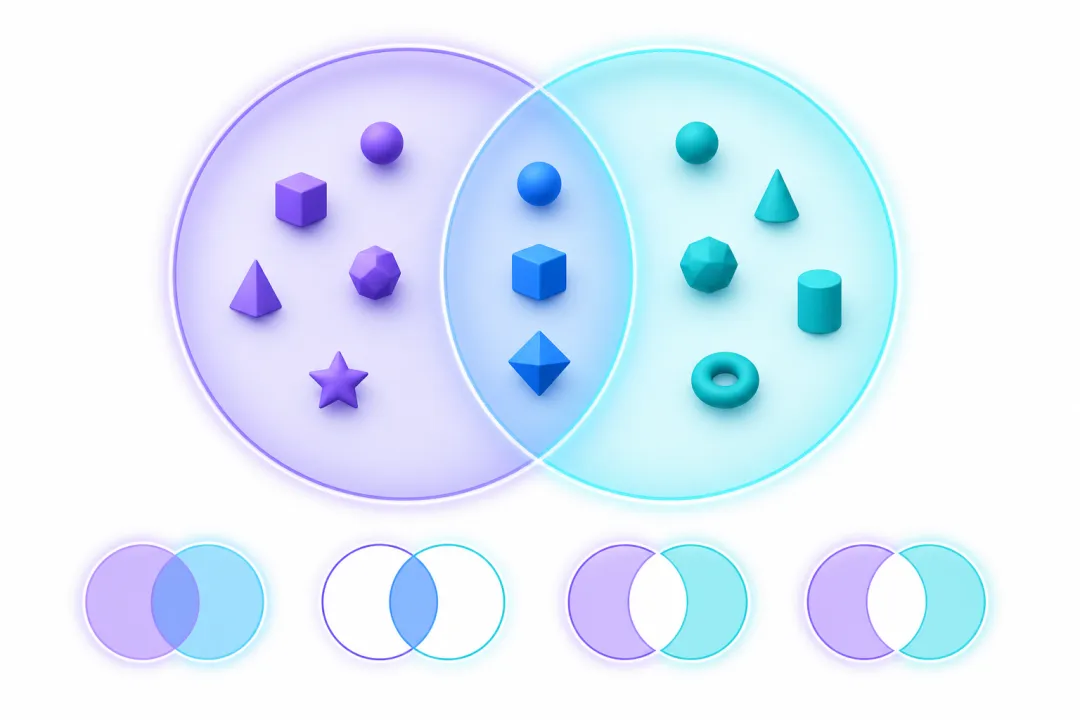
其中最容易出错的是差集具有方向:a - b 表示只在 a 中的元素,b - a 表示只在 b 中的元素,两者通常不同。
1a ={1, 2, 3}
2b ={3, 4, 5}
3
4print(sorted(a - b))
5print(sorted(b - a))
1[1, 2]
2[4, 5]
运算符形式要求两边都是集合;union()、intersection()、difference() 等方法可以接受其他可迭代对象。这是阅读不同代码写法时值得留意的区别。
五、更新原集合与判断集合关系
|、&、-、^ 会返回一个新集合,不修改原集合;对应的 |=、&=、-=、^= 会更新左侧集合。
1current ={1, 2, 3}
2
3current |={3, 4}
4print(sorted(current))
5
6current &={2, 4, 6}
7print(sorted(current))
1[1, 2, 3, 4]
2[2, 4]
判断“某组是否完全包含在另一组中”,可以使用子集和超集运算:
1required ={"read", "write"}
2permissions ={"read", "write", "comment"}
3
4print(required <= permissions)
5print(required < permissions)
6print(permissions >= required)
1True
2True
3True
<= 判断子集,< 判断真子集;>= 判断超集,> 判断真超集。所谓“真”,就是两组不能完全相等。
如果只想判断两组是否完全没有共同元素,可使用 isdisjoint():
1weekend ={"Saturday", "Sunday"}
2workdays ={"Monday", "Tuesday", "Wednesday"}
3
4print(weekend.isdisjoint(workdays))
1True
关系判断的实用场景 权限检查、课程选课、标签匹配、黑白名单冲突检测,都可以先把数据转换成集合,再用子集、交集或差集表达业务规则。 |
六、集合推导式与 frozenset
1. 集合推导式
集合推导式与列表推导式相似,但使用单层花括号,而且结果会自动去重。
1even_squares ={
2number **2
3for number inrange(1, 11)
4if number %2==0
5}
6
7print(sorted(even_squares))
1[4, 16, 36, 64, 100]
它也适合统一文本大小写后去重:
1words =["Apple", "apple", "BANANA", "banana"]
2normalized ={word.casefold()for word in words}
3
4print(sorted(normalized))
1['apple', 'banana']
2. 不可变集合 frozenset
普通 set 可以增删元素,因此它本身不可哈希;frozenset 创建后不能再修改,在其元素都可哈希时,可以作为字典键或另一个集合的元素。
1group_a =frozenset({"Alice", "Bob"})
2group_b =frozenset({"Carol", "David"})
3
4groups ={group_a, group_b}
5print(len(groups))
12
可以把 frozenset 理解为“冻结后的集合”。它仍支持并集、交集和成员判断,但不支持 add()、remove() 等修改方法。
七、去重之后还要保留顺序怎么办?
set(values) 可以快速得到唯一元素,但不能保证保留原列表中第一次出现的顺序。
1values =[3, 1, 3, 2, 1]
2unique =set(values)
3
4print(unique)
如果需要得到 [3, 1, 2],可以同时使用一个集合记录“是否见过”,再用列表保存结果顺序:
1values =[3, 1, 3, 2, 1]
2seen =set()
3result =[]
4
5for value in values:
6if value notin seen:
7seen.add(value)
8result.append(value)
9
10print(result)
1[3, 1, 2]
这里集合负责快速成员判断,列表负责维持顺序。不同容器各做自己擅长的事情,通常比强行让一种数据结构承担全部需求更清晰。
八、两个综合案例
案例一:比较两个人的兴趣
1alice ={"Python", "music", "reading"}
2bob ={"Python", "sports", "reading"}
3
4print("共同兴趣:", sorted(alice & bob))
5print("全部兴趣:", sorted(alice | bob))
6print("Alice 独有:", sorted(alice - bob))
7print("只属于一人:", sorted(alice ^ bob))
交集回答“共同拥有”,并集回答“合起来有哪些”,差集回答“谁独有”,对称差集回答“只出现在一边的有哪些”。只要先明确问题中的集合关系,代码就会非常直观。
案例二:检查用户权限
1required ={"read", "write", "share"}
2actual ={"read", "write"}
3
4if required <= actual:
5print("权限满足")
6else:
7missing = required - actual
8print("缺少权限:", sorted(missing))
1缺少权限: ['share']
子集判断负责确认“必需权限是否全部具备”,差集负责指出“具体缺少什么”。这种写法比多层条件判断更接近问题本身,也更容易维护。
九、常见错误速查
问题 | 错误认识或写法 | 正确处理 |
空集合写成 {} | 以为得到空集合 | 使用 set() |
依赖打印顺序 | 认为某次显示顺序固定 | 需要稳定输出时使用 sorted() |
对集合使用索引 | values[0] | 集合不支持索引;需要位置就使用列表 |
添加列表 | items.add([1, 2]) | 元素必须可哈希,可改用元组或 update() |
删除缺失元素 | 不确定存在却用 remove() | 使用 discard() 或先判断成员 |
误解 pop() | 以为删除最后一项 | 它删除任意元素 |
混淆差集方向 | 把 a - b 当成 b - a | 先明确哪一组是基准 |
去重后期待保序 | list(set(values)) | 使用 seen + result 等保序逻辑 |
遇到集合问题时,可以先问自己三个问题:我是否只关心唯一元素?是否不依赖顺序?我要比较的是共同项、左侧独有项,还是只出现于一侧的项?这三个问题通常能迅速帮助你选对写法。
本期总结
这一期,我们掌握了集合的创建、增删、成员判断和遍历,理解了它无序、不重复、元素必须可哈希的特点,也学会了使用并集、交集、差集、对称差集、子集和 isdisjoint() 描述两组数据之间的关系。
真正需要记住的主线是:集合不只是“去重工具”,它还是表达成员关系与集合关系的工具。只要问题关心的是“有没有、共同有哪些、不同有哪些”,就值得考虑集合。
END
今天的分享就到这里,感谢你耐心读到最后。希望这篇文章能帮助你真正理解集合的使用边界:需要唯一性和关系判断时大胆使用,需要顺序和位置时及时换回合适的数据结构。我们下一期再见!
最后也想听听你的意见:下一期你希望看到哪个 Python 基础知识点? 欢迎在推文下方投票,或者在评论区留言告诉我。
 10个月宝宝每天需要喝多少奶粉?