1. 调通一个 API,为什么比想象难
第一周的任务清单很短:用 Python 写一个能调通大模型 API 的程序,做到密钥走环境变量、能切换模型、超时和认证失败有清楚提示、每次调用都记录耗时和用量。
实际写起来,时间几乎都耗在四件"不像功能"的事上:API Key 怎么安全地走环境变量而不写进代码;怎么在 DeepSeek、GLM 之间切换却不改业务代码;超时、认证失败这些异常怎么分类成清楚提示;流式输出和每次调用的耗时、Token 用量怎么处理。
2. 我的核心做法
从零写一个大模型调用程序,不能再把 API 调用当成"一段 HTTP 请求",它涉及配置管理、错误分类、流式协议、用量记账四件事。
我的做法:用"抽象基类 + 工厂函数"让换模型不改核心逻辑;用 .env 文件管密钥;按 HTTP 异常类型分类提示;每次调用记录模型、耗时和 Token 用量。
3. 动手前,先搞懂 6 个基础概念
在写代码前,先搞清楚几个绕不开的概念(这部分来自我第一周的学习笔记)。
什么是 LLM、Token、上下文窗口?
LLM(大语言模型)本质是一个基于 Transformer 的"续写机器"——你给它一段话,它一个字一个字地猜下一个字应该是什么。猜得足够准,看起来就像"理解"了你。
模型不认字,只认数字。所以文本要先被分词器切成一个个 Token(最小语义单元)。1 个 Token 大约等于 1.5~2 个常用汉字。Token 是计费单位,也是上下文窗口的计量单位。
上下文窗口可以理解为模型的"工作记忆"——它决定模型一次能"看到"多少内容。窗口大小 = 系统提示 + 用户输入 + 对话历史 + 模型输出,总和不能超。超出会被截断("遗忘"最早的信息)。
类比:上下文窗口就是 AI 助手面前的桌子大小。桌子就这么大,资料堆不下就得拿走最旧的那份。
三种消息:System / User / Assistant
一句话:System 把框划死,User 只管提需求,Assistant 在框里干活,Assistant 的回答又会变成下一轮的上下文。
API Key / Base URL / Model
- Base URL:服务地址,错了 → 404 / 连接失败
- Model:用哪个"大脑",如
deepseek-chat、glm-4,错了 → 模型不存在
同步 vs 流式
- 同步:等模型把整段话生成完,一次性返回。首字延迟高,但实现简单。
- 流式:模型边生成边分块推送(SSE 协议,
data: {...} 一行行来)。首字延迟极低,体验好,但代码要处理增量拼接。
注意:流式响应(交付阶段分块)和流式推理(计算阶段实时)不是一回事,但流式响应是流式推理的最佳载体。现在主流产品都用流式。
推理请求的完整流程:分词 → 预填充(GPU 并行处理输入)→ 解码(逐个生成 Token)→ 反分词(拼回文字)。我们调 API 时,这几步都在服务端发生,我们只管发请求、收结果。
4. 能跑的最小版本:5 段核心代码
下面是这一周我沉淀下来的核心代码。业务代码不绑定任何一家模型。
① 定义统一的返回结构和抽象基类
所有 Provider(DeepSeek、GLM…)都遵守同一个接口:
from abc import ABC, abstractmethodfrom dataclasses import dataclass@dataclassclassLMResponse: content: str latency_ms: float success: bool usage: dict | None = None# Token 用量(prompt/completion/total),拿不到时保持 NoneclassLLMProvider(ABC):# 所有模型厂商(DeepSeek、GLM…)都必须实现这两个方法# 业务代码只认这个抽象基类,不认具体厂商 —— 这就是"换模型不改核心"的根基 @abstractmethoddefchat(self, system_prompt: str, user_prompt: str) -> LMResponse: ... @abstractmethoddefchat_stream(self, system_prompt: str, user_prompt: str): ...
② 密钥只从环境变量读,读不到立即报错
密钥存在项目根目录的 .env 文件里(务必加进 .gitignore,绝不提交):
# .env (密钥存这里,绝不提交 git,务必加进 .gitignore)DEEPSEEK_API_KEY=sk-你的keyGLM_API_KEY=你的keyLLM_PROVIDER=deepseek # 指定当前用哪家模型
程序入口调一次 load_dotenv(),把 .env 读进环境变量,之后代码里用 os.environ.get(...) 就能拿到相关配置:
import osfrom dotenv import load_dotenvload_dotenv() # 把 .env 读进环境变量,整个程序入口调一次就够classDeepSeekProvider(LLMProvider):def__init__(self, timeout: float | None = None):# 只从环境变量读 Key,代码里永远不出现明文密钥 self.api_key = os.environ.get("DEEPSEEK_API_KEY")ifnot self.api_key:# Fail Fast:读不到立刻报错,别等请求发出去拿 401 才发现raise RuntimeError("环境变量 DEEPSEEK_API_KEY 未设置") self.base_url = "https://api.deepseek.com" self.model = "deepseek-chat"# 超时可配置,方便后面用 LLM_TIMEOUT=0.5 测"短超时"分支 self.timeout = float(timeout or os.environ.get("LLM_TIMEOUT", 60))
关键设计:Fail Fast——别等请求发出去拿到 401 才发现 Key 是 None,初始化时就检查。timeout 也做成可配置,方便后面测超时分支。
③ 异常分类:认证失败、超时、网络,分开提示
defchat(self, system_prompt, user_prompt): start = time.time()try: r = httpx.post(f"{self.base_url}/chat/completions", headers={"Authorization": f"Bearer {self.api_key}"}, # 标准鉴权头 json={"model": self.model, "messages": [ {"role": "system", "content": system_prompt}, # System:定规则 {"role": "user", "content": user_prompt}, # User:提需求 ]}, timeout=self.timeout, ) r.raise_for_status() # 4xx/5xx 转 HTTPStatusError,交给下面的 except 分类 data = r.json()return LMResponse( content=data["choices"][0]["message"]["content"], # 取出模型回复正文 usage=data.get("usage"), # 记录 Token 用量,用于算成本 latency_ms=(time.time() - start) * 1000, success=True, )except httpx.HTTPStatusError as e:# 服务端返回了错误状态码,按码区分原因 code = e.response.status_code msg = "认证失败:API Key 错误或无权限"if code in (401, 403) elsef"HTTP {code}"except httpx.TimeoutException:# 请求超过 self.timeout 秒还没完成 msg = f"请求超时({self.timeout}s)"except httpx.ConnectError:# 根本连不上服务器:断网、域名错、被防火墙挡 msg = "网络连接失败"except Exception as e:# 兜底:没预料到的错误,至少别让程序裸崩 msg = f"未知错误:{type(e).__name__}: {e}"# 走到这说明出错了:返回一个 success=False 的响应,而不是抛异常给调用方return LMResponse(content=msg, usage=None, latency_ms=(time.time() - start) * 1000, success=False)
④ 工厂函数:换模型 = 改一个环境变量
defmake_provider(name: str | None = None) -> LLMProvider:# 不传 name 就读环境变量 LLM_PROVIDER,默认 deepseek name = name or os.environ.get("LLM_PROVIDER", "deepseek")if name == "deepseek":return DeepSeekProvider()if name == "glm":return GlmProvider()raise ValueError(f"未知 provider: {name}")# 换模型 = 改环境变量,业务代码一行都不用动
业务代码里永远是 agent = AgentCore(make_provider()),换模型不改一行核心逻辑。
⑤ 流式输出:解析 SSE 的 data: 行
defchat_stream(self, system_prompt, user_prompt):try:# with 块:建立连接 → 收 SSE 流 → 自动关闭,异常也会在这段抛with httpx.stream("POST", f"{self.base_url}/chat/completions", headers={"Authorization": f"Bearer {self.api_key}"}, json={"model": self.model, "stream": True, "messages": [...]}, timeout=self.timeout) as r: r.raise_for_status()# SSE 协议:每行一条 data: {...},逐行解析for line in r.iter_lines(): line = line.strip()ifnot line.startswith("data: "):continue# 不是数据行(空行、心跳),跳过 chunk = line[6:] # 去掉 "data: " 前缀if chunk.strip() == "[DONE]":break# 结束标记,停止读取 delta = json.loads(chunk)["choices"][0]["delta"] content = delta.get("content")# 第一个 chunk 的 content 常为 None(只带 role),必须过滤# 否则下游 full += None 会崩if content isnotNone:yield contentexcept httpx.HTTPStatusError as e:# 流式下的认证失败:yield 一句提示给调用方显示,而不是抛异常yieldf"\n[错误] 认证失败"if e.response.status_code in (401, 403) elsef"\n[错误] HTTP {e.response.status_code}"except httpx.TimeoutException:yieldf"\n[错误] 请求超时"
说明:
- 数据怎样进入程序:
system_prompt + user_prompt 拼成 messages,POST 给 /chat/completions。 - 模型在何处参与判断:模型在服务端,我们只发请求、收结果;本地不做推理。
- 结果怎样返回:同步返回完整
content;流式逐块 yield,由调用方拼接打印。 - 程序怎样处理失败:按异常类型分流,每种错误给出一句明确中文提示,绝不把堆栈甩给用户。
5. 跑起来长什么样
输入示例:
System: 你是一个乐于助人的 AI 助手。User: 请介绍一下你自己。
输出示例:
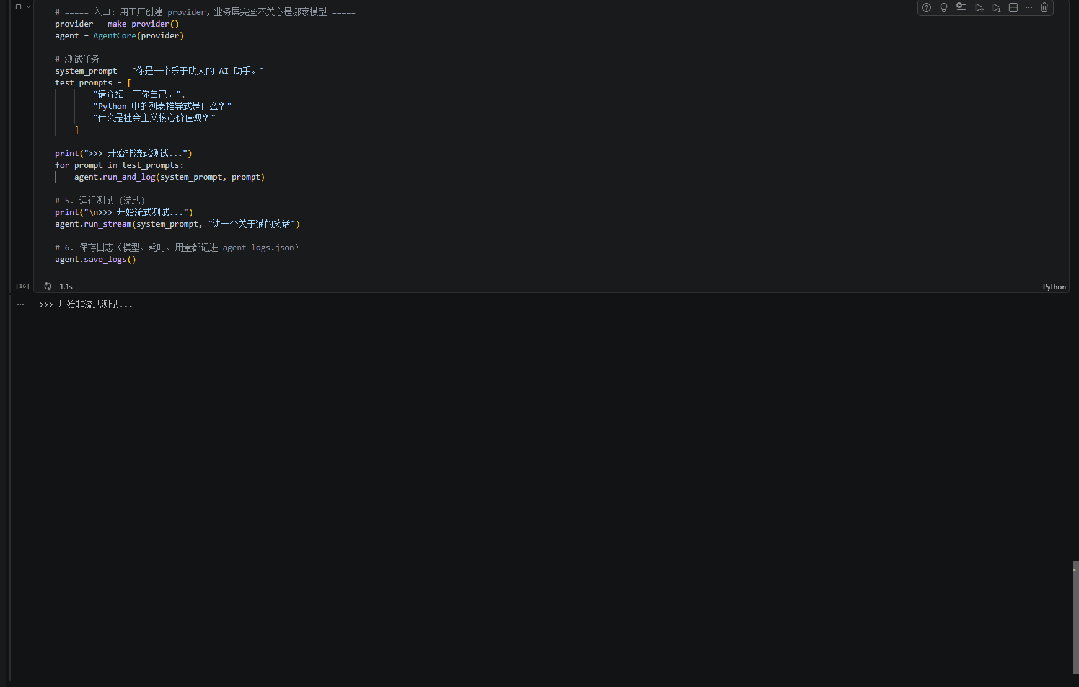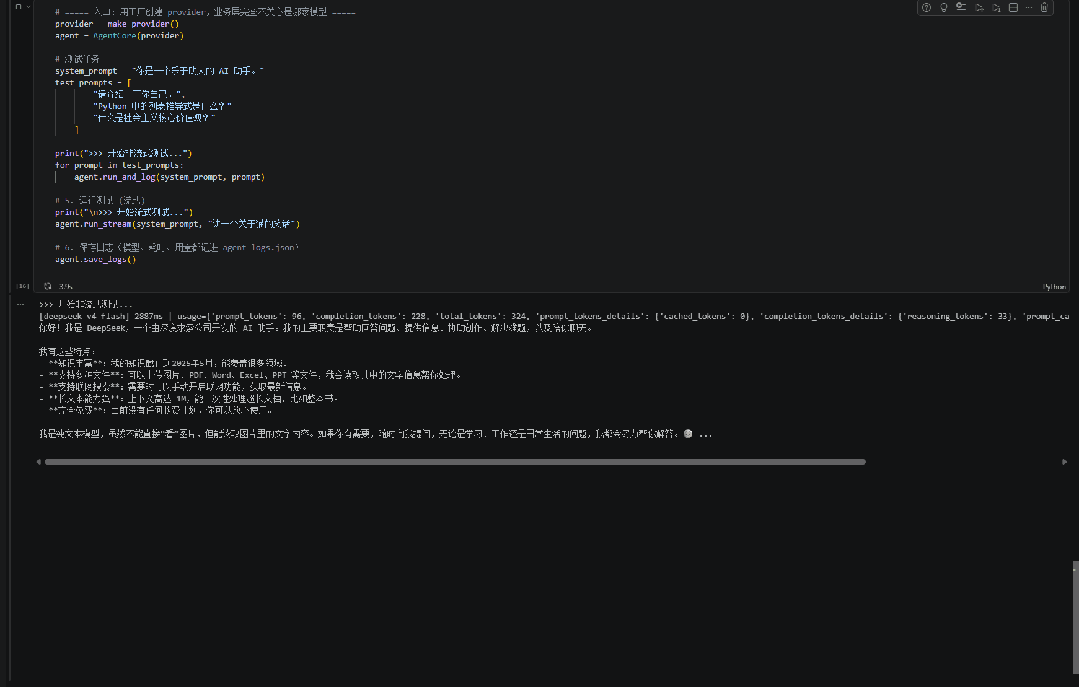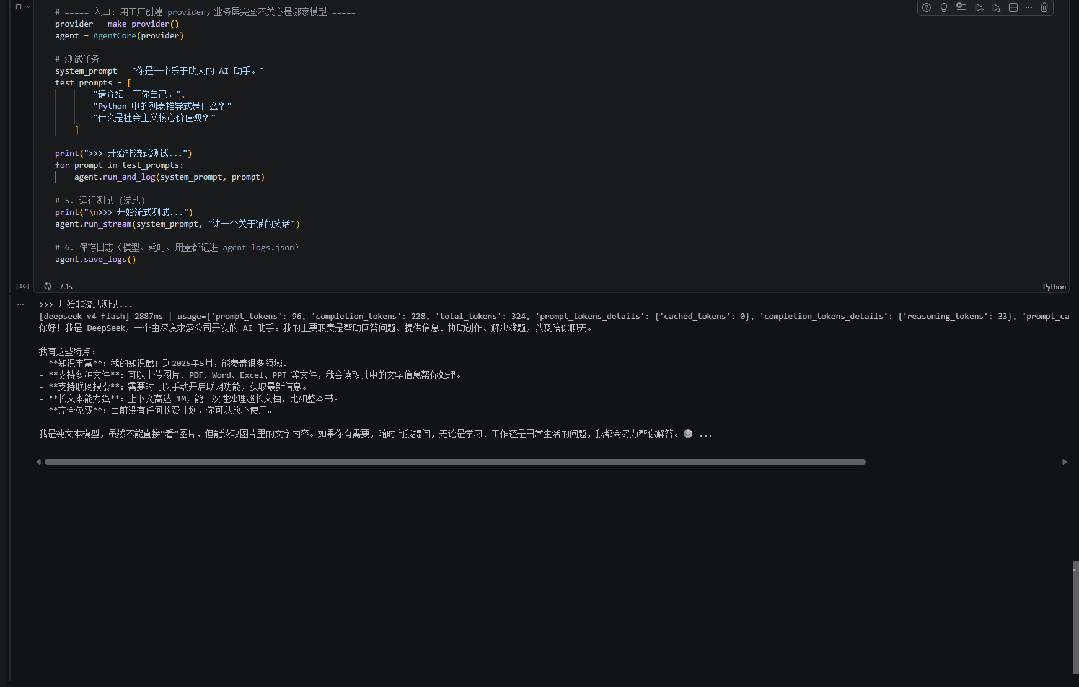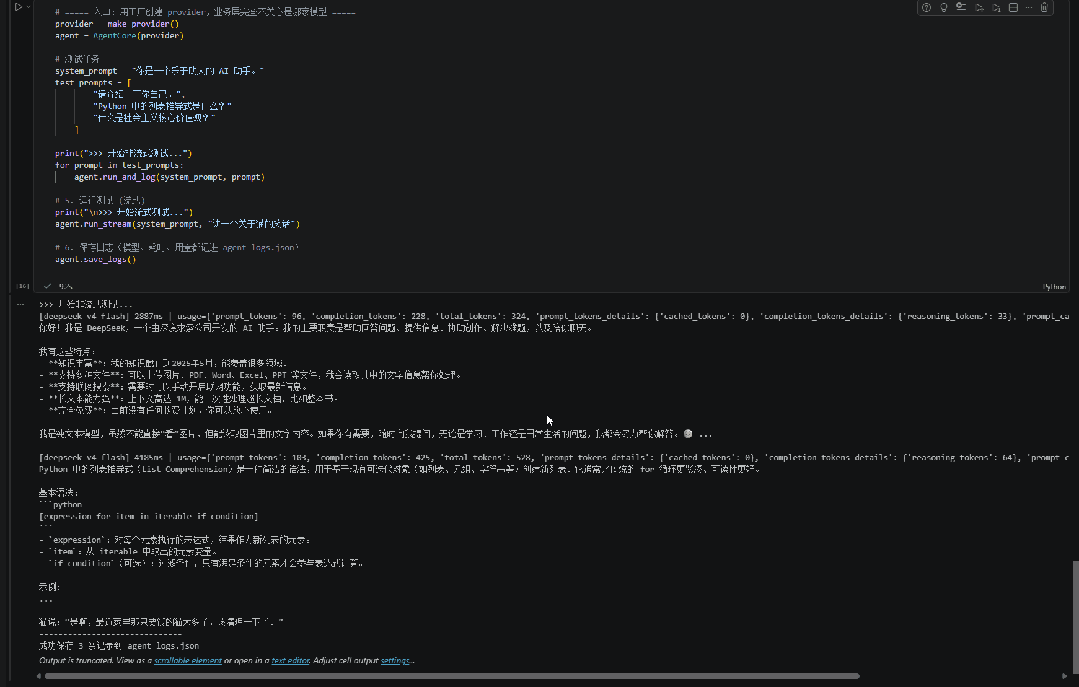
[deepseek-chat] 5338ms | usage={'prompt_tokens': 96, 'completion_tokens': 342,'total_tokens': 438, ...}你好!我是 DeepSeek,一个由深度求索公司开发的 AI 助手。很高兴认识你!...
流式输出:
>>> 开始流式测试...流式调用模型: deepseek-chat ...好的,我用流式方式讲一个关于猫的笑话:一只猫走进图书馆……------------------------------
本次模型和关键配置:
- 模型:
deepseek-chat(DeepSeek)/ glm-4(智谱,OpenAI 兼容接口) - 配置:
.env 文件存 DEEPSEEK_API_KEY / GLM_API_KEY / LLM_PROVIDER
调用日志(agent_logs.json 节选):
{"model": "deepseek-chat","input": "请介绍一下你自己。","latency_ms": 5338.0,"usage": {"prompt_tokens": 96, "completion_tokens": 342, "total_tokens": 438},"success": true}
流式调用拿不到 usage(SSE 默认不回用量),日志里标 "unknown",明确标记未知。