当前位置:首页>python>Python Spark Django:运动卡路里消耗数据分析系统选题推荐 源码 毕业设计 毕设选题 数据分析 机器学习 深度学习

Python Spark Django:运动卡路里消耗数据分析系统选题推荐 源码 毕业设计 毕设选题 数据分析 机器学习 深度学习

  • 2026-09-02 17:09:49
Python Spark Django:运动卡路里消耗数据分析系统选题推荐 源码 毕业设计 毕设选题 数据分析 机器学习 深度学习

01
运动卡路里消耗数据分析系统-简介

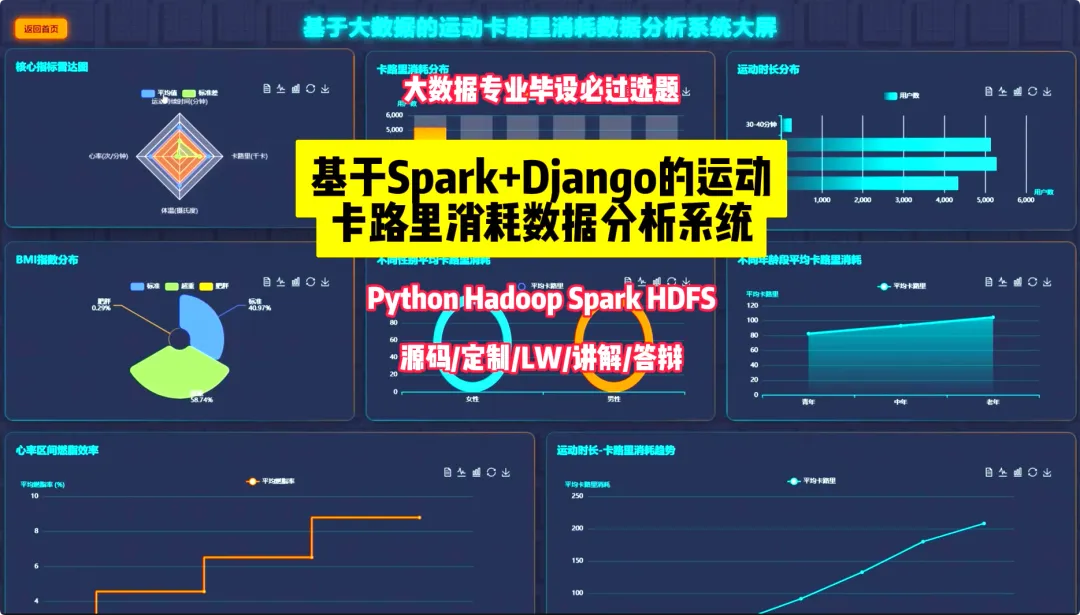
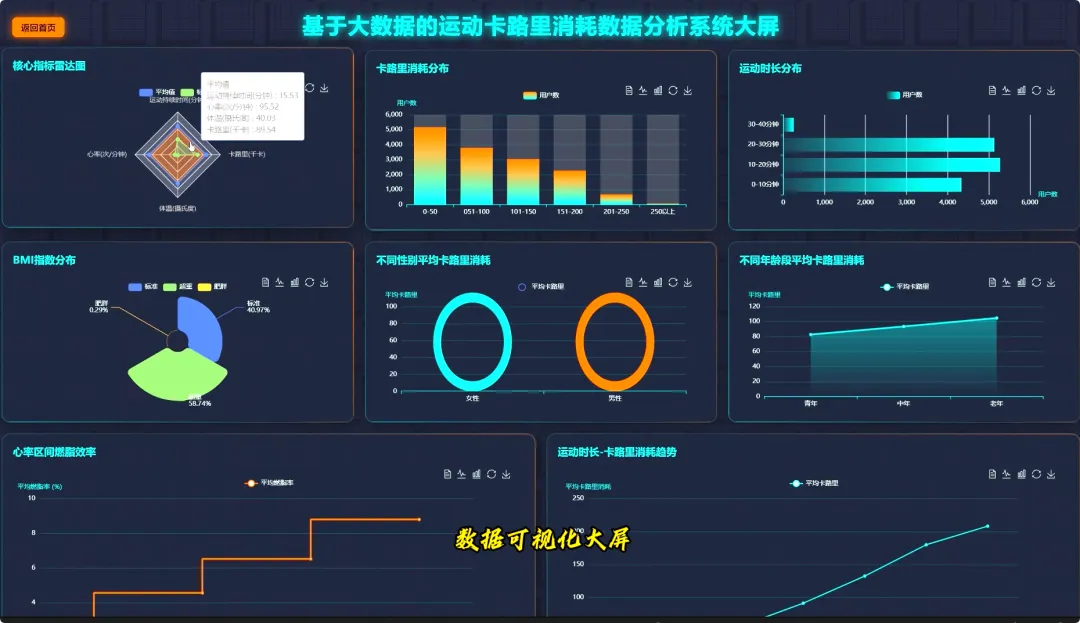
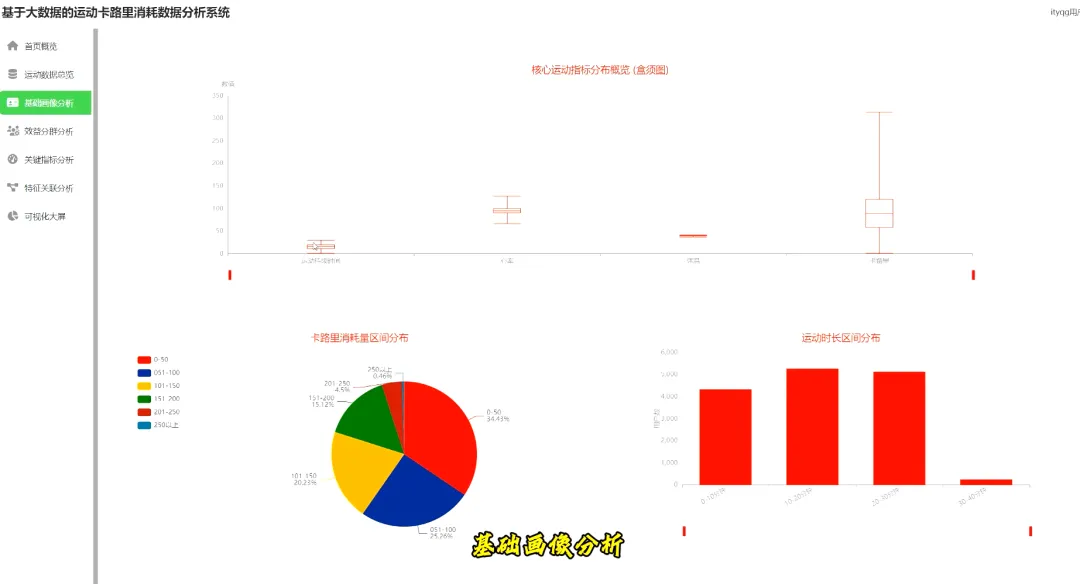
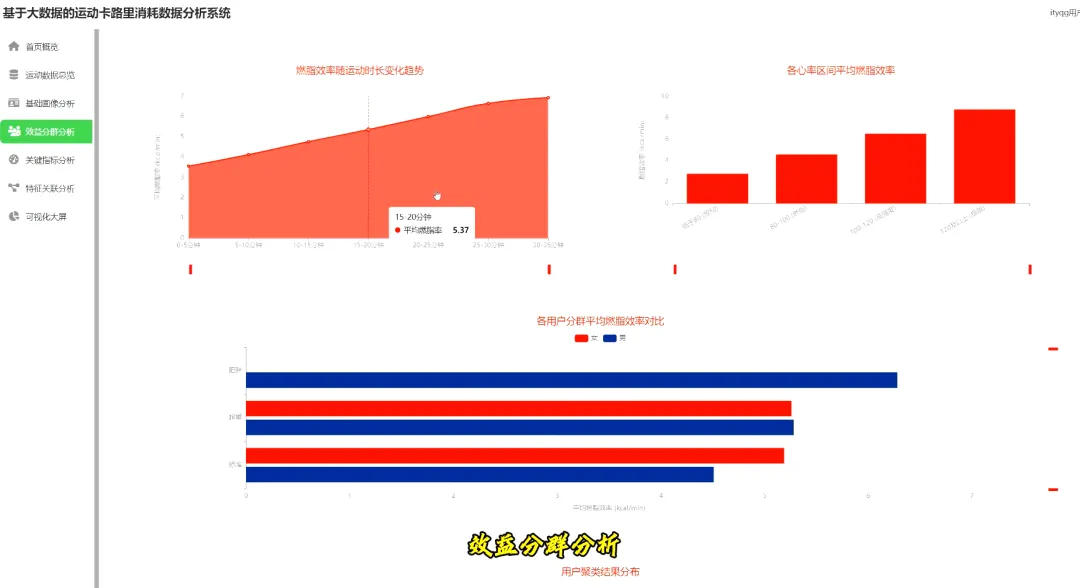
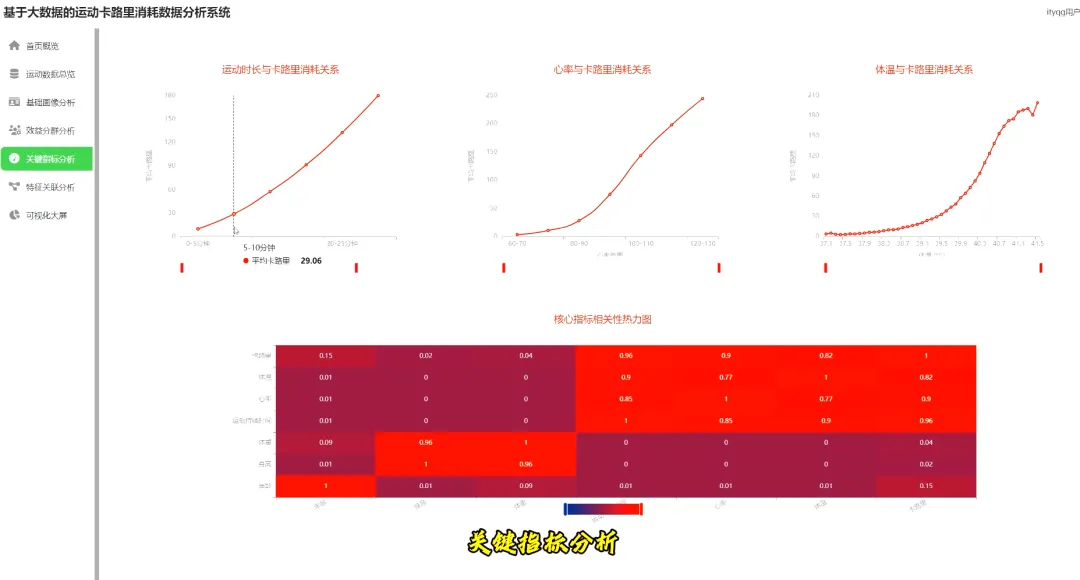
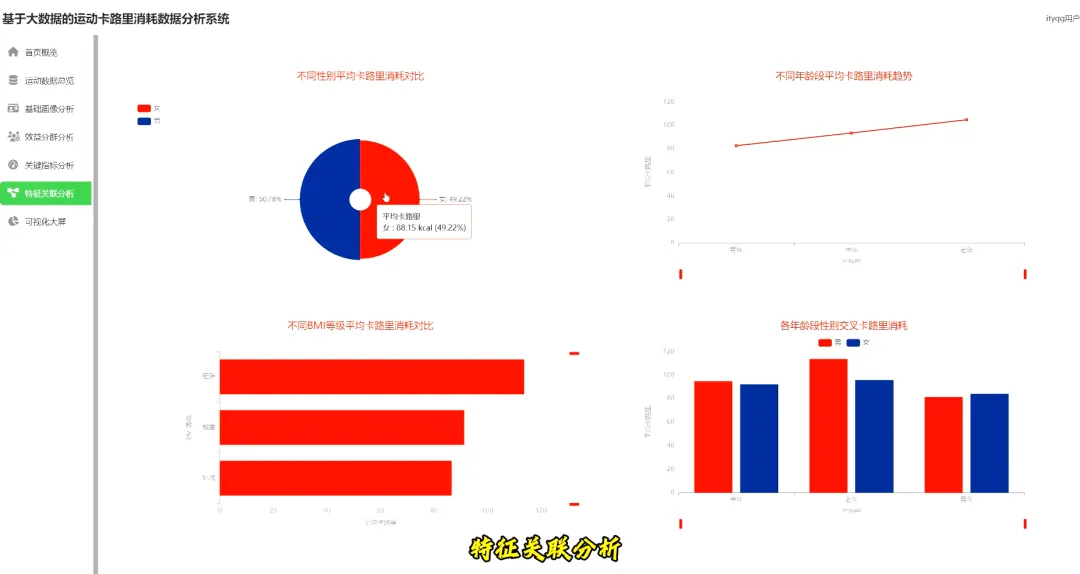
本系统采用Python语言开发,构建了一个基于Hadoop与Spark大数据架构的运动卡路里消耗分析平台。后端选用Django框架负责业务逻辑处理与接口服务,前端则利用Vue与Echarts实现数据的可视化呈现。系统核心处理逻辑依托Spark分布式计算引擎,能够高效读取并清洗大规模运动数据集。在功能实现上,系统首先对运动时长、心率、体温及卡路里消耗等核心指标进行描述性统计与区间分布分析,帮助用户建立基础运动认知。随后,系统深入探究用户特征与消耗的关联,通过计算BMI指数,对比不同性别、年龄及体型群体的运动差异。在深度分析层面,系统利用Pandas与NumPy库辅助Spark SQL,计算各指标间的相关性系数矩阵,生成热力图以识别影响卡路里消耗的关键因子。此外,系统还引入了K-Means聚类算法,根据用户的运动行为特征将其划分为不同群体,并分析单位时间内的燃脂效率,从而为用户提供个性化的运动建议与科学的健身指导方案。

02
运动卡路里消耗数据分析系统-背景

选题背景

随着全民健身意识的不断提升,智能穿戴设备在日常生活中得到了普及,海量的运动生理数据随之产生。然而,面对这些庞大且杂乱的数据,普通用户往往只能看到表面的数字变化,难以理解其背后隐藏的健康规律。很多人虽然坚持运动,但并不清楚自己的运动强度是否合理,也不知道何种类型的运动最适合自身体质。在计算机技术飞速发展的今天,如何利用大数据手段从这些繁杂的信息中提取有价值的内容,解决“数据丰富但认知贫乏”的矛盾,成为了一个现实问题。本课题正是基于这一实际需求,希望通过搭建数据分析系统,将冰冷的数据转化为通俗易懂的运动指导,帮助人们更科学地管理健康。

选题意义

这个系统的价值在于它把大数据技术真正用到了实际生活场景中,让大家能更科学地认识运动。通过Spark对大量运动记录进行计算,我们可以很直观地看到性别、年龄或者心率这些因素是怎么具体影响卡路里消耗的。这能帮用户避开一些运动误区,别光顾着傻练,而是找到最高效的燃脂方式,花更少的时间达到更好的锻炼效果。从技术学习角度看,把Spark的计算能力和Django的Web开发结合起来,是对大学所学知识的一次很好检验,也展示了处理实际数据问题的能力。虽然这只是一个毕业设计,功能可能没那么完美,但它确实连接了数据和用户需求,提供了一套可行的分析思路,为以后开发更复杂的健康管理应用打下了基础。

03
运动卡路里消耗数据分析系统-技术框架

大数据框架:Hadoop+Spark(本次没用Hive,支持定制)开发语言:Python+Java(两个版本都支持)后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy数据库:MySQL

04
运动卡路里消耗数据分析系统-视频
已关注
关注
重播 分享 赞

解决数据处理痛点:基于Spark+Django的运动卡路里消耗分析

05
运动卡路里消耗数据分析系统-图片展示
06
运动卡路里消耗数据分析系统-代码展示
spark = SparkSession.builder.appName("CaloriesAnalysis").getOrCreate()def data_cleaning_and_stats_analysis(df):    df = df.na.drop(subset=["Calories", "Duration", "Heart_Rate", "Body_Temp"])    df = df.filter((col("Duration") > 0) & (col("Calories") > 0))    stats = df.select(        mean("Calories").alias("avg_calories"),        stddev("Calories").alias("stddev_calories"),        mean("Duration").alias("avg_duration"),        mean("Heart_Rate").alias("avg_heart_rate")    ).collect()[0]    duration_bins = [0, 10, 30, 60, float('inf')]    bucketizer = Bucketizer(splits=duration_bins, inputCol="Duration", outputCol="duration_group")    df_binned = bucketizer.transform(df)    distribution = df_binned.groupBy("duration_group").count().orderBy("duration_group").collect()    return {"stats": stats, "distribution": distribution}def correlation_analysis(df):    assembler = VectorAssembler(        inputCols=["Age", "Weight", "Duration", "Heart_Rate", "Body_Temp"],        outputCol="features"    )    vec_df = assembler.transform(df).select("features")    correlation_matrix = Correlation.corr(vec_df, "features").head()[0].toArray()    corr_list = []    col_names = ["Age", "Weight", "Duration", "Heart_Rate", "Body_Temp"]    for i in range(len(col_names)):        for j in range(len(col_names)):            corr_list.append({                "col1": col_names[i],                "col2": col_names[j],                "corr": float(correlation_matrix[i, j])            })    return corr_listdef kmeans_clustering_analysis(df):    assembler = VectorAssembler(        inputCols=["Duration", "Heart_Rate", "Calories"],        outputCol="features"    )    data = assembler.transform(df).select("features")    kmeans = KMeans(k=3, seed=1, maxIter=20)    model = kmeans.fit(data)    predictions = model.transform(data)    centers = model.clusterCenters()    cluster_stats = predictions.groupBy("prediction").agg(        mean("Calories").alias("avg_cal"),        mean("Duration").alias("avg_dur"),        count("*").alias("count")    ).collect()    result = []    for row in cluster_stats:        result.append({            "cluster_id": row["prediction"],            "avg_calories": row["avg_cal"],            "avg_duration": row["avg_dur"],            "user_count": row["count"]        })    return result
07
运动卡路里消耗数据分析系统-结束语

💬 计算机毕业设计过程中遇到任何疑难或有其它需求,欢迎随时与我沟通探讨。联系方式:请扫描文章上方或下方的【二维码图片】,或点击公众号底部菜单栏获取。日常均在岗,收到消息会及时为您解答。预祝您毕设圆满完成,答辩顺利高分通过!

联系我们

商务合作

微信号:JSJBSZDS

关注公众号:计算机毕设指导师

~~感谢您抽空来阅读此文~~

最新文章

随机文章