主成分分析(PCA)是提高机器学习算法处理大量数据和特征性能的最常用方法之一。然而,PCA 有时可能太复杂、太技术化,甚至太乏味,难以正确理解基本原理。
这篇文章将以实际的方式阐明每一步,易于初学者理解。
为什么需要在机器学习中使用 PCA
去除噪声数据:数据集中有太多数据需要分析时,PCA 会过滤掉噪声数据,只留下突出的数据
提高性能:通过去除大量不相关的特征,大幅减少机器学习的训练时间
简化可视化:去掉没有影响的特征后,数据可视化更清晰,更易于理解
减少过拟合:许多过拟合仅仅是因为特征太多,PCA 有助于缓解这一问题
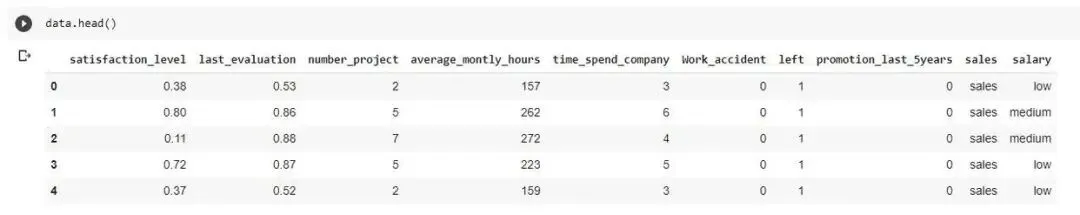
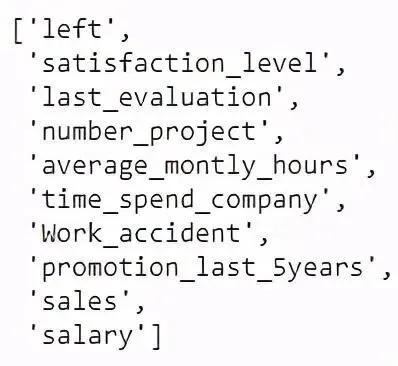
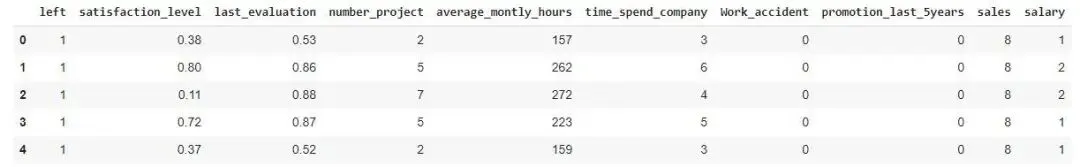
本文通过 Kaggle 数据集实现 PCA(数据集来源:hr-dataset)。通过 pandas 的 head 函数,我们可以看到数据集的特征和数据如下:
如我们所见,原始数据集由 10 个特征组成,还有一些离散数据。机器学习算法不能消化离散数据,我们需要将它们转换为有序数据。
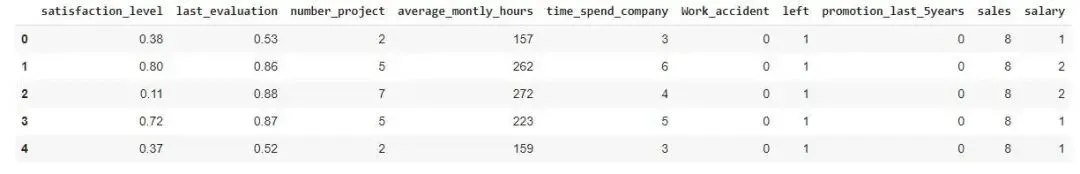
对于 PCA,需要将销售(sales)和薪资(salary)特征转换为有序数据,如下所示:
# 将离散数据映射为有序数据data['salary'] = data['salary'].map({ 'low': 1, 'medium': 2, 'high': 3}).astype(int) data['sales'] = data['sales'].map({ 'accounting': 1, 'hr': 2, 'IT': 3, 'management': 4, 'marketing': 5, 'product_mng': 6, 'RandD': 7, 'sales': 8, 'support': 9, 'technical': 10}).astype(int)这将为我们提供一个没有任何离散数据的新数据集:
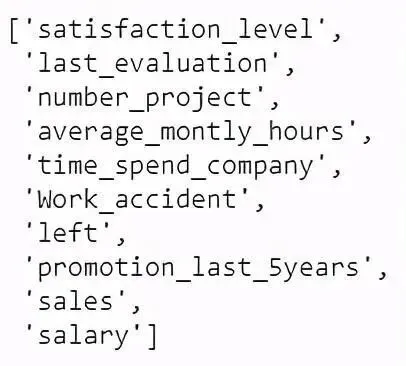
如我们所见,left 特征是一个标签,因此可以更方便地将其设置在数据列的最左侧,以便进行数据拆分。首先将特征转换为列表以重新排列列:
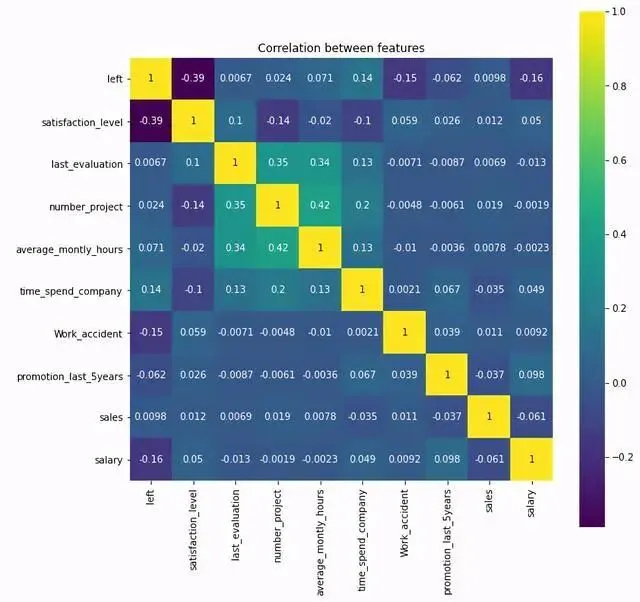
# 获取列名列表columns = data.columns.tolist()# 将 left 特征移到第一列columns.insert(0, columns.pop(columns.index('left')))# 重新排列列顺序data = data.reindex(columns=columns)随后,我们可以通过相关性矩阵分析每个特征之间的相关性,相关矩阵可以通过 seaborn 库构建:
correlation = data.corr() plt.figure(figsize=(10, 10)) sns.heatmap(correlation, vmax=1, square=True, annot=True, cmap='viridis') plt.title('Correlation between features')由于 left 特征是一个标签,我们可以对数据集随机化,然后将数据拆分为 X 和 Y,X 为训练数据,y 为标签数据:
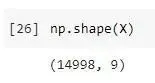
# X 为训练数据(第2~10列),y 为标签数据(第1列)X = data.iloc[:, 1:10].values y = data.iloc[:, 0].values
现在进入了 PCA 的第一步——数据标准化,这是执行 PCA 之前的必要步骤。数据标准化的目的是通过使用平均值和标准差来均衡所有数据。
通俗类比1-A 班的安迪在数学考试中得了 80 分(满分 100,标准差 6 分),1-B 班的海伦得了 320 分(满分 450,标准差 68 分)。为了比较谁的分数更高,我们用百分比来标准化:安迪得到 80%,海伦得到 71%,因此安迪的分数比海伦高。
在 Python 中,我们可以使用 sklearn 的 StandardScaler 函数对数据进行标准化:
from sklearn.preprocessing import StandardScaler X_std = StandardScaler().fit_transform(X)
Sklearn 的 StandardScaler 的原理是用平均值减去值,再除以标准差:
其中 z 为标准化数据,x 为原始数据,μ 为平均值,σ 为标准差。
平均值公式:
标准差公式:
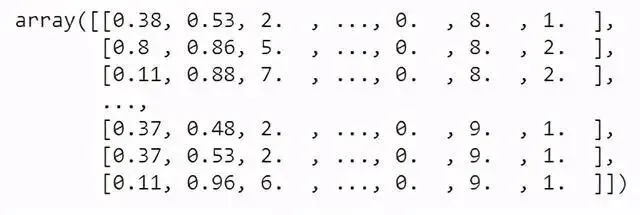
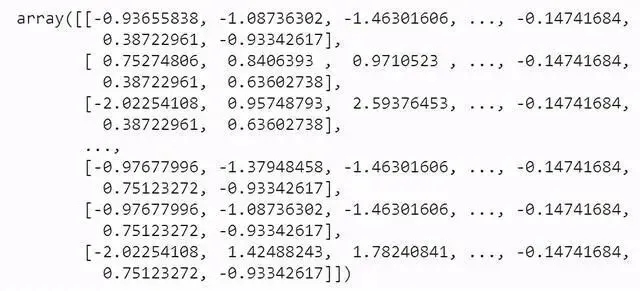
现在数据集已经通过使用 sklearn 函数实现了标准化,输出如下:
在标准化之后,我们想再次找出每个特征之间的相关性。这可以通过使用以下公式来实现:
或者用如下 Python 代码:
mean_vec = np.mean(X_std) cov_mat = (X_std - mean_vec).T.dot((X_std - mean_vec)) / (X_std.shape[0] - 1)print('Covariance matrix', cov_mat)或者简单地使用 Numpy 的协方差函数:
print('NumPy covariance matrix:', np.cov(X_std.T))两个代码将提供相同的输出:
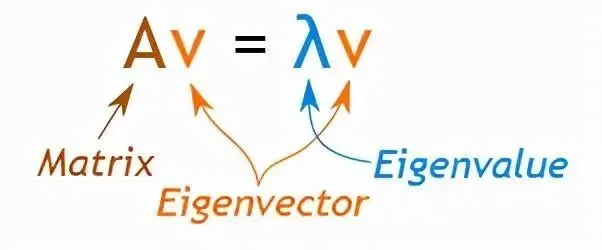
既然我们通过协方差矩阵了解了每个特征之间的关系,就可以通过计算特征向量和特征值来确定主成分。
协方差矩阵被视为 A,可以使用 Numpy 函数来确定特征向量和特征值:
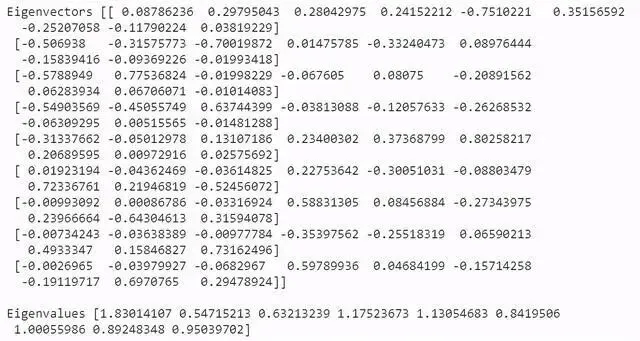
eig_vals, eig_vecs = np.linalg.eig(cov_mat)print('Eigenvectors', eig_vecs)print('\nEigenvalues', eig_vals)既然已经找到了特征值和特征向量,我们需要对特征值进行排序,以确定哪个特征向量在数据集中最相关。
首先,将每个特征值和特征向量组合成特征对:
# 组合特征值和特征向量为特征对eig_pairs = [(np.abs(eig_vals[i]), eig_vecs[:, i]) for i inrange(len(eig_vals))]# 从高到低排序eig_pairs.sort(key=lambda x: x[0], reverse=True)
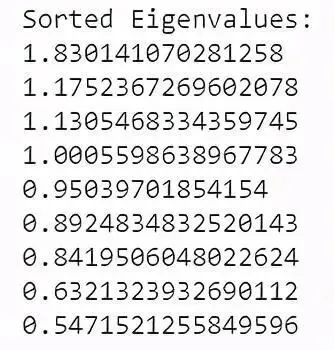
我们可以得到如下所示的有序特征值:
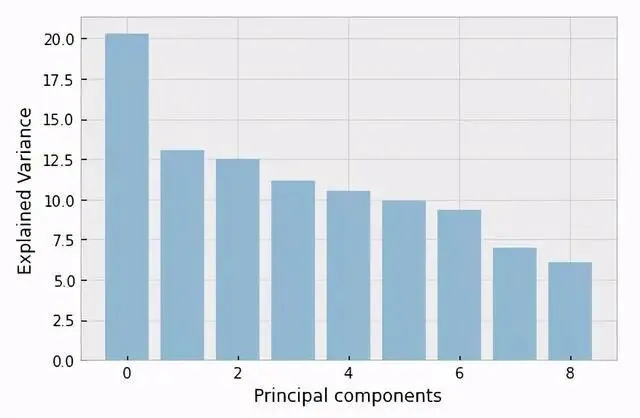
print('Sorted Eigenvalues:')for i in eig_pairs: print(i[0])现在我们可以从排序后的特征值中得到主成分。主成分的值即所谓的解释方差,表明一个特征的突出程度。我们目前有 9 个不同的主成分,因此将产生 9 个不同的百分比方差。
# 计算解释方差百分比tot = sum(eig_vals) var_exp = [(i / tot) * 100for i insorted(eig_vals, reverse=True)]
然后使用 Matplotlib 绘制每个主成分的值:
with plt.style.context('bmh'): plt.figure(figsize=(6, 4)) plt.bar(range(9), var_exp, alpha=0.5, align='center') plt.ylabel('Explained Variance') plt.xlabel('Principal components') plt.tight_layout()最大方差在 20.5% 左右。最后两个特征与其他特征相比影响比较小,因为它们的方差小于 7.5%。因此,我们可以放弃这两个特征。
既然决定去掉最后两个特征,我们就可以构造只包含前 7 个特征的新矩阵:
# 用前7个特征向量构造PCA矩阵PCA_matrix = np.hstack(( eig_pairs[0][1].reshape(9, 1), eig_pairs[1][1].reshape(9, 1), eig_pairs[2][1].reshape(9, 1), eig_pairs[3][1].reshape(9, 1), eig_pairs[4][1].reshape(9, 1), eig_pairs[5][1].reshape(9, 1), eig_pairs[6][1].reshape(9, 1), ))
然后利用点积法,利用 Y = XW 建立新的特征空间:
Y = X_std.dot(PCA_matrix)
然后创建一个新的数据集,包含每个主成分的数据和标签:
principalDf = pd.DataFrame( data=Y, columns=['principal component 1', 'principal component 2', 'principal component 3', 'principal component 4', 'principal component 5', 'principal component 6', 'principal component 7'] ) finalDf = pd.concat([principalDf, pd.DataFrame(y, columns=['left'])], axis=1)
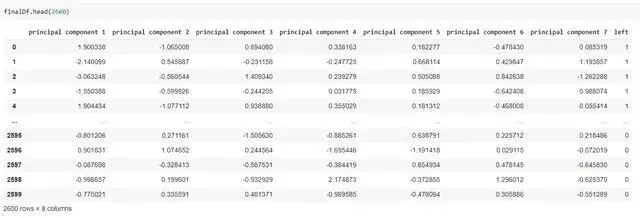
这将为我们提供一个新的数据集,该数据集已通过 PCA 处理:
 PCA 处理后的新数据集(7 个主成分 + 标签)
结论
总结关于放弃多少特征,我们有很多选择——放弃 2 个、3 个,甚至只留下 2 个特征。至少第一个特征是最突出的一个。
通过机器学习算法(如线性回归、随机森林等),处理这类降维后数据的速度要比处理整个数据集快得多。
PCA 全流程回顾:
① 数据标准化 → ② 计算协方差矩阵 → ③ 求特征值与特征向量 → ④ 排序选取主成分 → ⑤ 构造新特征空间
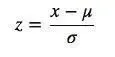
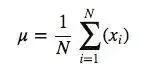
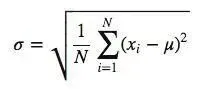
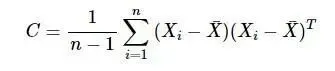

 10个月宝宝每天需要喝多少奶粉?