Python的class允许定义许多定制方法,可以让我们非常方便地生成特定的类。
最常用的几个定制方法,还有很多可定制的方法,请参考Python的官方文档。
1.__str__
如果要把一个类的实例变成 str,就需要实现特殊方法__str__()。
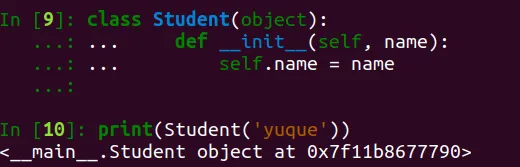
我们先定义一个Student类,打印一个实例:
打印的是Student类在内存中的地址,看不懂。
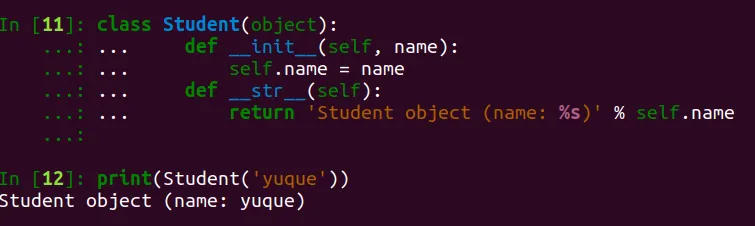
需要返回字符串的话,只要定义__str__方法。
这样容易看出实例内部重要的数据,
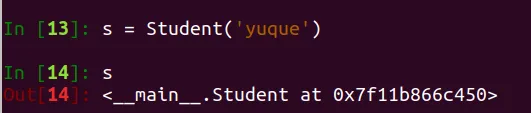
而且 如果是使用变量而不用print,打印出来的还是实例的内存地址。
这是因为直接显示变量调用的不是__str__(),而是__repr__(),
两者的区别是__str__()返回用户看到的字符串,而__repr__()返回程序开发者看到的字符串,
也就是说,__repr__()是为调试服务的。
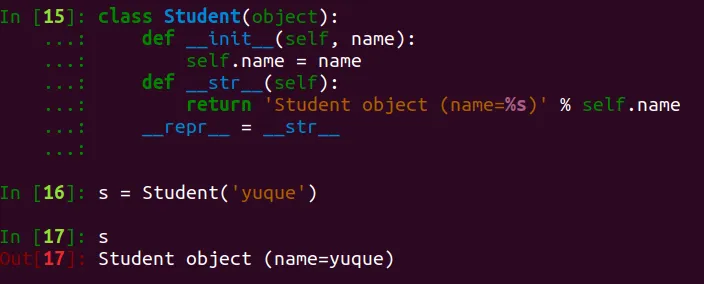
解决办法是再定义一个__repr__()。但是通常__str__()和__repr__()代码都是一样的,
所以,有个偷懒的写法:
2.__iter__
使用__iter__()方法,该方法返回一个迭代对象。使得一个类也可被for....in循环。
以斐波那契数列为例,写一个Fib类,可以作用于for循环:
class Fib(object): def __init__(self): self.a, self.b = 0, 1 # 初始化两个计数器a,b def __iter__(self): return self # 实例本身就是迭代对象,故返回自己 def __next__(self): self.a, self.b = self.b, self.a + self.b # 计算下一个值 if self.a > 100000: # 退出循环的条件 raise StopIteration() return self.a # 返回下一个值
试试把Fib实例作用于for循环:
>>> for n in Fib():... print(n)...11235...4636875025
3.__getitem__
使用__getitem__()方法,可按照下标取出元素。
上面Fib实例虽然能作用于for循环,看起来和list有点像,但是,
把它当成list来使用还是不行,比如,取第5个元素:
>>> Fib()[5]Traceback (most recent call last): File "<stdin>", line 1, in <module>TypeError: 'Fib' object does not support indexing
要表现得像list那样按照下标取出元素,需要实现__getitem__()方法:
classFib(object): def __getitem__(self, n): a, b = 1, 1 for x in range(n): a, b = b, a + b return a
现在,就可以按下标访问数列的任意一项了:
>>> f = Fib()>>> f[0]1>>> f[1]1>>> f[2]2>>> f[3]3>>> f[10]89>>> f[100]573147844013817084101
但是list有个神奇的切片方法:
>>> list(range(100))[5:10][5, 6, 7, 8, 9]
对于Fib却报错。原因是__getitem__()传入的参数可能是一个int,
也可能是一个切片对象slice,所以要做判断:
class Fib(object): def __getitem__(self, n): if isinstance(n, int): # n是索引 a, b = 1, 1 for x in range(n): a, b = b, a + b return a if isinstance(n, slice): # n是切片 start = n.start stop = n.stop if start is None: start = 0 a, b = 1, 1 L = [] for x in range(stop): if x >= start: L.append(a) a, b = b, a + b return L
现在试试Fib的切片:
>>> f = Fib()>>> f[0:5][1, 1, 2, 3, 5]>>> f[:10][1, 1, 2, 3, 5, 8, 13, 21, 34, 55]
但是没有对step参数作处理:
>>> f[:10:2][1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89]
也没有对负数作处理,所以,要正确实现一个__getitem__()还是有很多工作要做的。
此外,如果把对象看成dict,__getitem__()的参数也可能是一个可以作key的object,例如str。
与之对应的是__setitem__()方法,把对象视作list或dict来对集合赋值。最后,还有一个__delitem__()方法,用于删除某个元素。
总之,通过上面的方法,我们自己定义的类表现得和Python自带的list、tuple、dict没什么区别,这完全归功于动态语言的“鸭子类型”,不需要强制继承某个接口。
4.__getattr__
正常情况下,当调用类的方法或属性时,如果不存在,就会报错。
但,如果定义了__getattr__方法,找不到时,则会去执行__getattr__中的代码
class ClassA: x = 'a' def __init__(self): self.y = 'b' def __getattr__(self, item): if item == "z": return '__getattr__'if __name__ == '__main__': a = ClassA() print(a.x) # 输出结果 a print(a.y) # 输出结果 b ,使用实例直接访问实例存在的实例属性时,不会调用__getattr__方法 print(a.z) # 输出结果 __getattr__, 使用实例直接访问实例不存在的实例属性时, # 会调用__getattr__方法
5.__getattribute__
如果某个类定义了 __getattribute__() 方法,在 每次引用属性或方法名称时 Python 都会调用它
(特殊方法名称除外,因为那样将会导致讨厌的无限循环)。
class ClassA: x = 'a' def __init__(self): self.y = 'b' def __getattribute__(self, item): return '__getattribute__'if __name__ == '__main__': a = ClassA() print(a.x) # 输出结果 __getattribute__, 使用实例直接访问存在的类属性时,会调用__getattribute__方法 print(a.y) # 输出结果 __getattribute__, 使用实例直接访问实例存在的实例属性时,会调用__getattribute__方法 print(a.z) # 输出结果 __getattribute__, 使用实例直接访问实例不存在的实例属性时,也会调用__getattribute__方法
另外,当同时定义__getattribute__和__getattr__时,__getattr__方法不会再被调用,
除非显示调用__getattr__方法或引发AttributeError异常。
class ClassA: def __getattr__(self, item): print('__getattr__') def __getattribute__(self, item): print('__getatttribute__')if __name__ == '__main__': a = ClassA() a.x # 输出结果 __getattribute__
__getattribute__应用示例
访问属性时,打上log日志
class Itcast(object): def __init__(self,subject1): self.subject1 = subject1 self.subject2 = 'cpp' #属性访问时拦截器,打log def __getattribute__(self,obj): if obj == 'subject1': print('log subject1') return 'redirect python' else: #测试时注释掉这2行,将找不到subject2 return object.__getattribute__(self,obj) def show(self): print('this is Itcast')s = Itcast("python")print(s.subject1) # 输出结果 log subject1,redirect pythonprint(s.subject2) # 输出结果 cpp
__getattribute__的坑
条件不满足的代码中,不允许写 self.xx,self会递归调用且永远不满足条件
class Person(object): def __getattribute__(self,obj): print("---test---") if obj.startswith("a"): return "hahha" else: return self.test def test(self): print("heihei") t.Person() t.a #返回hahha t.b #会让程序死掉```原因是:当t.b执行时,会调用Person类中定义的__getattribute__方法,但是在这个方法的执行过程中if条件不满足,所以 程序执行else里面的代码,即return self.test 问题就在这,因为return 需要把self.test的值返回,那么首先要获取self.test的值,因为self此时就是t这个对象,所以self.test就是t.test 此时要获取t这个对象的test属性,那么就会跳转到__getattribute__方法去执行,即此时产生了递归调用,由于这个递归过程中 没有判断什么时候推出,所以这个程序会永无休止的运行下去,又因为每次调用函数,就需要保存一些数据,那么随着调用的次数越来越多,最终内存吃光,所以程序 崩溃```
6.__call__
__call__()的作用是使实例能够像函数一样被调用,
同时不影响实例本身的生命周期,不影响一个实例的构造和析构
def __call__(self, *args)。这个方法接受一定数量的变量作为输入。 假设x是X类的一个实例。那么调用x.__call__(1,2)等同于调用x(1,2)。
这个实例本身在这里相当于一个函数。
class Student(object): def __init__(self, name): self.name = name def __call__(self): print('My name is %s.' % self.name)
调用方式如下:
>>> s = Student('Michael')>>> s() # self参数不要传入My name is Michael.