在 Linux 服务器运维中,磁盘空间告急是一个常见且影响严重的故障。它直接导致应用程序崩溃、数据库写入中断、日志轮转失效,进而引发服务不可用,往往需要紧急介入处理。
为了避免这种被动的局面,建立主动的磁盘监控与预警机制至关重要。利用 Linux 内置命令和简单的 Shell 脚本,我们可以快速构建一个自动化监控方案,在磁盘使用率达到预设阈值(如80%)时,通过邮件等方式及时发送告警,从而为运维人员争取宝贵的处理时间。
本文将详细介绍如何编写并部署这样一个监控脚本,实现从检测到告警的完整流程。
1.在Linux中如何检查磁盘使用率
编写监控脚本的第一步,是掌握手动查看磁盘状态的方法。df(disk filesystem)命令是 Linux 系统中最直接、最常用的磁盘空间查询工具。
执行以下命令可查看所有文件系统的使用情况:
df -h
下面是一个典型的生产服务器输出:
[root@yyzcdb81 ~]# df -h
文件系统                         容量  已用  可用 已用% 挂载点
devtmpfs                         3.8G     0  3.8G    0% /dev
tmpfs                            2.0G     0  2.0G    0% /dev/shm
tmpfs                            3.9G  373M  3.5G   10% /run
tmpfs                            3.9G     0  3.9G    0% /sys/fs/cgroup
/dev/sda2                         93G  5.1G   88G    6% /
/dev/mapper/backupvg-backuplv    3.0T  4.6G  3.0T    1% /backup
/dev/mapper/oradatavg-oradatalv 1000G  6.3G  994G    1% /oradata
/dev/mapper/centos-oracle        200G   14G  187G    7% /oracle
/dev/mapper/archivevg-archivelv  489G   33M  489G    1% /archive
/dev/sr0                         4.4G  4.4G     0  100% /mnt
tmpfs                            781M     0  781M    0% /run/user/0
[root@yyzcdb81 ~]#
-h 参数:代表"human-readable"(人类可读格式),它根据数据大小将数据块自动转换为更直观的MB、GB或者TB单位显示。
以上输出中,根分区/dev/sda2的使用率为 6%,处于绝对健康状态。在运维实践中,我们通常会设定一个明确的 警戒阈值(例如80%)。当任一关键分区的 已用情况达到或超过此阈值时,就意味着必须立即介入处理,以避免因磁盘写满导致的服务中断。这正是我们接下来要编写的监控脚本所需要自动化完成的核心判断。
2.构建基础监控脚本
掌握了手动查看的方法后,我们可以着手将这个过程自动化。
Shell脚本是完成此类任务的理想工具,它能够将系统命令、文本处理和条件判断无缝结合,形成一个完整的解决方案。
以下脚本实现了对根分区(/) 使用率的自动检查与告警:
#!/bin/bash

# 设置告警阈值(百分比)
THRESHOLD=80

# 提取根分区当前使用率数值
#    df -h / :获取根分区磁盘信息(使用人类可读格式)
#    awk 'NR==2 {print $5}' :取第二行(数据行)的第五列(“已用%”)
#    sed 's/%//' :移除百分比符号,得到纯数字
USAGE=$(df -h / | awk 'NR==2 {print $5}' | sed 's/%//')

# 判断逻辑:如果使用率大于等于阈值,则触发告警
if [ "$USAGE" -ge "$THRESHOLD" ]; then
# 构造告警邮件内容并发送
echo"警告:主机 $(hostname) 的根分区磁盘使用率已到达 ${USAGE}%" | mail -s "磁盘空间告警:$(hostname)" netskyman@163.com
fi
注意:
此脚本的告警功能依赖于系统已正确配置邮件发送服务(如 mailutils 或 postfix)。如果尚未配置,脚本执行到 mail 命令时可能报错或无效。您也可以暂时将 mail 命令替换为 echo 语句输出到屏幕或日志文件进行测试。更详细的告警方式配置将在下文介绍。
3. 扩展监控范围:覆盖所有关键分区
基础脚本虽能监控根分区,但生产环境中的风险往往潜伏在其他专用分区。服务器通常会根据用途划分多个分区:
/opt 或 /data:业务应用数据,容量波动性大- 备份分区:如
/backup,定时任务可能产生大量数据
仅监控根分区就像只检查主油箱而忽略备用油箱——当 /var/log 被日志塞满时,即使 / 分区空间充足,关键服务仍可能因无法写入日志而崩溃。
为此,我们需要升级脚本,使其能够智能识别并监控所有物理磁盘和逻辑卷分区。
脚本如下:
#!/bin/bash

# 设置统一的告警阈值
THRESHOLD=80

# 核心改进:遍历所有物理设备和逻辑卷
# 'df -h' 列出所有文件系统
# 'grep '^/dev/'' 筛选出实际存储设备(排除tmpfs等内存文件系统)
# 'while read line' 逐行处理每个分区信息
df -h | grep '^/dev/' | whileread line; do
# 从每行输出中提取关键信息
# - 使用率(第五列):去除%符号转为纯数字
# - 挂载点(第六列):确定是哪个分区
    USAGE=$(echo"$line" | awk '{print $5}' | sed 's/%//')
    PARTITION=$(echo"$line" | awk '{print $6}')

# 针对每个分区独立进行阈值判断
if [ "$USAGE" -ge "$THRESHOLD" ]; then
# 构造精准告警信息,包含主机名、具体分区和使用率
        ALERT_MSG="警告:主机 [$(hostname)] 的分区 [$PARTITION] 使用率已触及 ${USAGE}%(阈值:${THRESHOLD}%)"
echo"$ALERT_MSG" | mail -s "磁盘空间告警:$(hostname) - $PARTITION" netskyman@163.com

# 同时输出到标准输出(便于手动执行时查看)
echo"$(date '+%Y-%m-%d %H:%M:%S') - $ALERT_MSG"
fi
done
通过这个进阶版脚本,我们建立了一个全覆盖的磁盘监控体系,能够主动发现任何一个存储分区的容量风险,将运维模式从"被动救火"转变为"主动预警"。这正是生产环境稳定性保障的重要一环。
接下来,我们将解决如何让这个监控脚本自动定期执行的问题。
4.自动化部署:使用Cron实现定时监控
Linux 内置的Cron任务调度服务是实现自动化周期性检查的理想方案,通过简单的配置,即可让监控脚本在后台静默运行,定期"巡检"磁盘状态。
(1)编辑当前用户的crontab:
crontab -e
(2)添加定时任务规则:
这里演示每天凌晨4点执行一次磁盘空间检查,shell脚本文件disk_monitor.sh放在统一规定的目录/usr/local/scripts/下:
0 4 * * * /usr/local/scripts/disk_monitor.sh
保存退出。
5.测试与验证
为了达到测试效果,将上面脚本阈值修改为5,新建一个disk_monitor.sh的Shell脚本,内容如下:
#!/bin/bash


THRESHOLD=5
USAGE=$(df -h / | awk 'NR==2 {print $5}' | sed 's/%//')

if [ "$USAGE" -ge "$THRESHOLD" ]; then
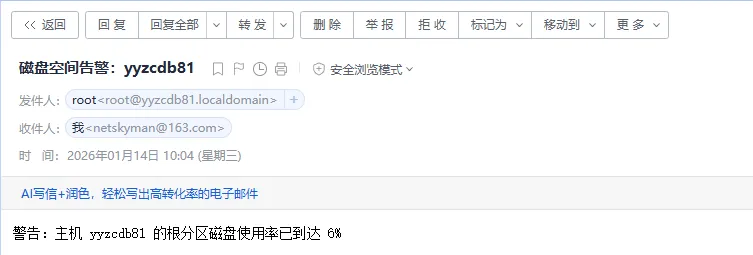
echo"警告:主机 $(hostname) 的根分区磁盘使用率已到达 ${USAGE}%" | mail -s "磁盘空间告警:$(hostname)" netskyman@163.com
fi
然后手动执行:
[root@yyzcdb81 ~]# sh disk_monitor.sh
[root@yyzcdb81 ~]#
打开邮箱,收到告警邮件:
如果暂时不想配置邮件,可将告警写入日志文件增加这部分:
echo"$(date):分区 $PART 使用率 ${USAGE}%" >> /var/log/disk_alert.log
完整的代码如下:
#!/bin/bash


THRESHOLD=5

df -h | grep '^/dev/' | whileread line; do
    USAGE=$(echo"$line" | awk '{print $5}' | sed 's/%//')
    PARTITION=$(echo"$line" | awk '{print $6}')

if [ "$USAGE" -ge "$THRESHOLD" ]; then
        ALERT_MSG="警告:主机 [$(hostname)] 的分区 [$PARTITION] 使用率已触及 ${USAGE}%(阈值:${THRESHOLD}%)"
# echo "$ALERT_MSG" | mail -s "磁盘空间告警:$(hostname) - $PARTITION" netskyman@163.com
echo"$(date):分区 $PART 使用率 ${USAGE}%" >> /var/log/disk_alert.log
echo"$(date '+%Y-%m-%d %H:%M:%S') - $ALERT_MSG"
fi
done
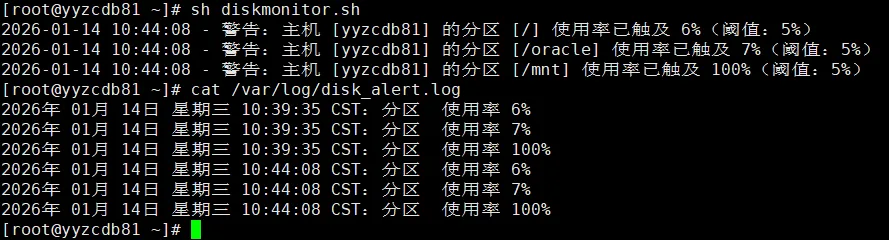
手动执行,告警信息如下:
[root@yyzcdb81 ~]# sh diskmonitor.sh
2026-01-14 10:44:08 - 警告:主机 [yyzcdb81] 的分区 [/] 使用率已触及 6%(阈值:5%)
2026-01-14 10:44:08 - 警告:主机 [yyzcdb81] 的分区 [/oracle] 使用率已触及 7%(阈值:5%)
2026-01-14 10:44:08 - 警告:主机 [yyzcdb81] 的分区 [/mnt] 使用率已触及 100%(阈值:5%)
[root@yyzcdb81 ~]# cat /var/log/disk_alert.log
2026年 01月 14日 星期三 10:39:35 CST:分区  使用率 6%
2026年 01月 14日 星期三 10:39:35 CST:分区  使用率 7%
2026年 01月 14日 星期三 10:39:35 CST:分区  使用率 100%
2026年 01月 14日 星期三 10:44:08 CST:分区  使用率 6%
2026年 01月 14日 星期三 10:44:08 CST:分区  使用率 7%
2026年 01月 14日 星期三 10:44:08 CST:分区  使用率 100%
[root@yyzcdb81 ~]#
至此,我们完成了一个从零构建的Linux磁盘监控系统。这套轻量级方案的核心价值在于,它将传统的被动响应转变为主动预警,通过自动化的脚本和定时任务,实现了对磁盘空间的7×24小时无人值守监控。掌握这种用简单工具解决实际问题的方法,不仅能有效预防因磁盘占满引发的服务中断,更能帮助您建立起主动运维的思维模式——在问题发生之前发现隐患,在风险积累之前采取行动。这便是运维工作从“救火”到“防火”的关键一步。