机器学习论文到代码--Paper2Code项目深度解析
- 2026-10-21 13:27:05
项目概述
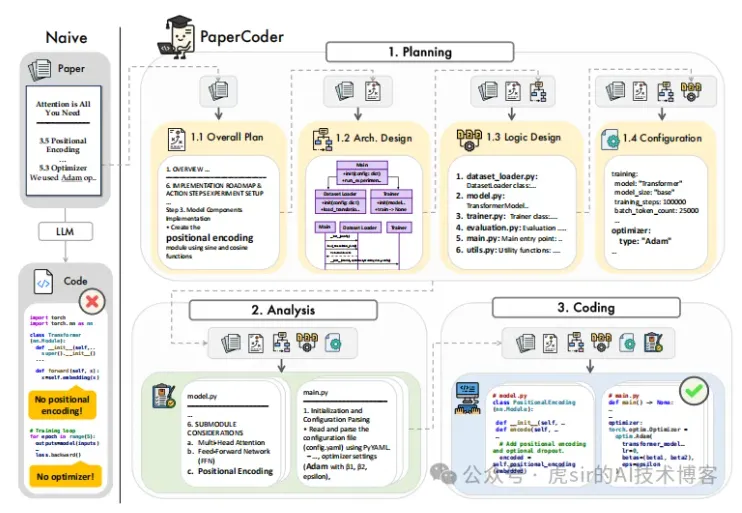
Paper2Code是一个多智能体LLM(大语言模型)系统,能够将科学论文转换为相应的代码仓库。该项目采用三阶段流水线:规划(planning)、分析(analyzing)和编码(coding),每个阶段由专门的智能体处理。该方法在Paper2Code和PaperBench数据集上超越了强基线模型,生成忠实且高质量的实现。
架构设计
整体架构
Paper2Code采用了经典的三阶段流水线架构:
规划阶段(Planning Stage):理解论文内容并制定实现策略
分析阶段(Analyzing Stage):对规划进行详细逻辑分析
编码阶段(Coding Stage):根据前两个阶段的结果生成实际代码
文件结构
Paper2Code/├── codes/ # 核心代码目录│ ├── 0_pdf_process.py # PDF预处理│ ├── 1_planning.py # 规划阶段主程序│ ├── 1.1_extract_config.py # 提取配置文件│ ├── 2_analyzing.py # 分析阶段主程序│ ├── 3_coding.py # 编码阶段主程序│ ├── utils.py # 工具函数│ └── eval.py
算法设计
1. 规划阶段算法(1_planning.py)
规划阶段是整个系统的入口,负责从论文中提取关键信息并制定实现计划。该阶段包括四个子任务:
整体计划(Overall Plan):理解论文的主要内容并制定总体实现策略
架构设计(Architecture Design):设计软件系统架构,包括文件列表、数据结构和接口
逻辑设计(Logic Design):分解任务并分析依赖关系
配置文件生成(Configuration Generation):提取训练参数等配置信息
算法流程:
加载论文内容(JSON或LaTeX格式)
通过一系列提示调用大语言模型生成规划结果
每次调用后保存响应和轨迹用于后续阶段
最终输出规划结果、轨迹和累计成本
2. 配置提取算法(1.1_extract_config.py)
该模块从规划阶段的输出中提取YAML格式的配置文件,确保后续阶段可以使用这些配置参数。
3. 分析阶段算法(2_analyzing.py)
分析阶段对规划阶段生成的任务列表中的每个文件进行详细逻辑分析。对于任务列表中的每个文件,系统会:
基于论文内容、规划结果和配置文件生成详细的逻辑分析提示
调用大语言模型生成针对特定文件的详细实现逻辑
将分析结果保存为中间产物供编码阶段使用
4. 编码阶段算法(3_coding.py)
编码阶段是最后一步,负责根据前面阶段的成果生成实际代码:
逐个处理任务列表中的文件
在生成新文件时考虑已生成的文件作为上下文
提取代码片段并保存到最终的代码仓库中
代码设计逻辑详解
核心设计理念
渐进式细化:系统采用分阶段方法,每阶段基于前一阶段的输出进行更详细的处理
上下文保持:每个阶段都保留完整的交互轨迹,以便后续阶段参考
成本跟踪:全程记录API调用成本,便于预算管理
错误处理:对JSON解析失败等情况提供多级容错机制
关键函数分析
utils.py中的工具函数
content_to_json系列函数:用于从大语言模型的输出中提取JSON格式的数据,提供了多级容错机制
extract_code_from_content:从包含代码块的文本中提取实际代码内容
cal_cost:根据模型名称和token数量计算API调用成本
extract_planning:从对话轨迹中提取规划阶段的关键信息
规划阶段的提示工程
规划阶段使用精心设计的系统提示,要求大语言模型扮演专家研究员和战略规划师的角色,确保生成的计划与论文的方法论、实验设置和评估指标完全一致。
分析和编码阶段的上下文构建
在分析和编码阶段,系统会构建丰富的上下文,包括:
论文内容
前期规划结果
设计文档
任务列表
配置文件
已生成的代码文件
这种设计确保了生成的代码与整体架构的一致性。
辅助代码与核心代码的关系
核心代码
1_planning.py:系统的核心,负责整体规划
2_analyzing.py:详细逻辑分析
3_coding.py:最终代码生成
辅助代码
utils.py:提供JSON解析、成本计算、代码提取等功能
1.1_extract_config.py:配置提取
0_pdf_process.py:PDF预处理
eval.py:评估功能
脚本文件
run.sh、run_llm.sh等:自动化执行脚本
总结
Paper2Code项目采用了一个巧妙的三阶段流水线架构,通过逐步细化的方式将复杂的科学论文转化为可执行的代码。系统的设计重点在于:
结构化思维:将复杂问题分解为可管理的阶段
上下文一致性:确保各阶段之间的信息流畅传递
容错能力:通过多重错误处理保证系统的稳定性
成本控制:实时跟踪API调用成本
可扩展性:模块化设计便于适配不同类型的论文
这个项目展示了如何利用大语言模型的强大能力解决复杂的、多步骤的问题,是一个优秀的AI应用设计案例。对于初学者来说,理解这个项目的架构可以帮助掌握如何构建基于LLM的复杂系统。
回复“虎sir”,进入AI交流学习群:
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 3行代码锁定起爆点:月收益翻倍的老股民私藏指标,今天拆解!
- 临时工招聘:焊工 CNC编程/操机 磨床 线切割
- PostgreSQL SQL代码格式化:pgFormatter工具实践
- 因为一行代码,全球互联网差点失忆!40年前的协议终于报仇了
- 因为一行代码,全球互联网差点失忆!40年前的协议终于报仇了
- 法律编程与计算社会科学培训的开篇
- [开源]一套代码,10+平台全搞定!Taro 开源跨端框架正式支持 React/Vue/Preact/Svelte
- 4-7岁家长必看|机器人编程寒假营高性价比硬核课!
- [开源]一套代码,10+平台全搞定!Taro 开源跨端框架正式支持 React/Vue/Preact/Svelte
- 你知道德国铁路的这些秘密代码吗?