趣话Linux Command④:Process & Scheduling篇:从 O(1) 到 CFS,再到 EEVDF
- 2026-09-02 20:24:26
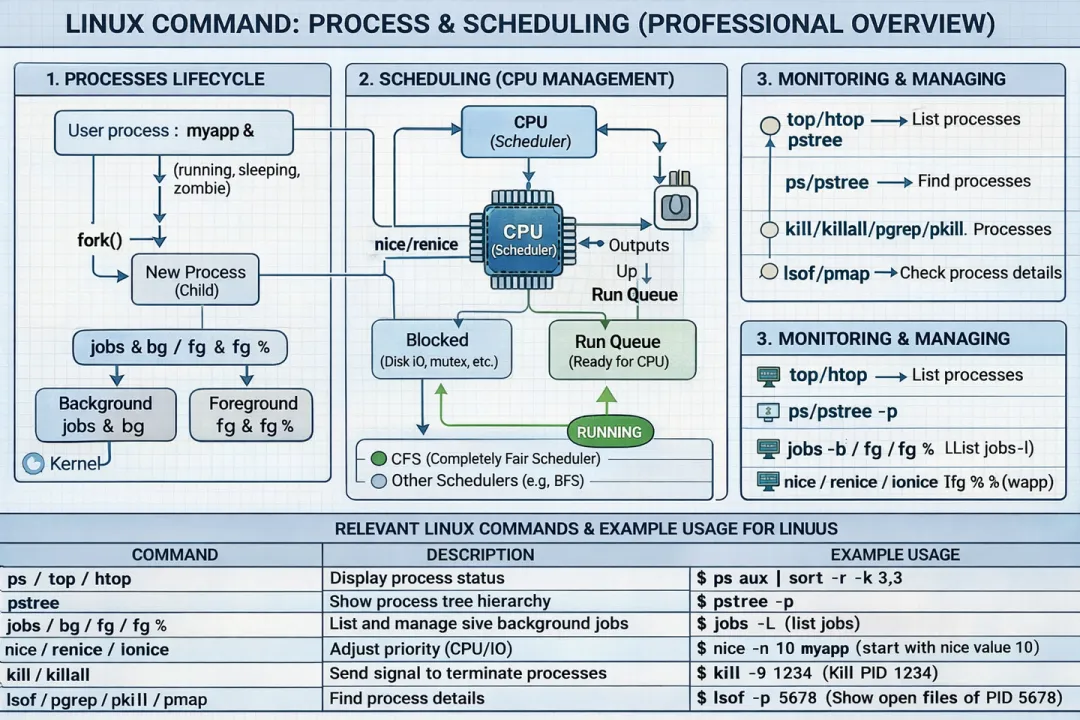
Linux 调度器不是一次设计出来的。
它是三次“理念翻转”的产物。
每一次升级,都在修补上一代的盲区。
如果你用过:
topuptimenicetaskset
那你其实已经在和调度器打交道,只是你没意识到。
一、调度器到底要解决什么问题?
一句话:
在有限 CPU 上,让多个任务“感觉”公平。
但“公平”从来不是简单的事。
它涉及:
交互响应性
吞吐量
上下文切换成本
多核负载均衡
实时任务保障
调度器本质上是在做一个优化问题:
minimize(latency) /*实时性*/maximize(throughput) /*并发性*/subject to fairness constraints /*公平性*/
问题是:不同年代,工程师对“公平”的理解不同。
二、第一阶段:O(n) 调度器 —— 朴素时代
早期 Linux(2.4 以前):
用线性链表维护 runnable 进程
每次调度遍历全部进程
复杂度:
O(n)
当 n 很小时:
没问题
当 n 上千时:
调度本身变成瓶颈
这是 SMP (对称多处理)场景爆发后暴露的问题。
三、第二阶段:O(1) 调度器 —— 工程优化的极致
Linux 2.6 引入 O(1) 调度器。
核心思想:
无论有多少进程,调度时间恒定。
怎么做到??
1️. 优先级数组
维护两个 priority array:
active:存放当前拥有时间片的任务队列。
expired:存放时间片已用完的任务队列。
通过双数组轮换,避免在运行过程中动态重排任务,保证O(1)复杂度。
每个数组包含 140 个优先级队列:
prio 0~139
优先级 0~99 用于实时任务(SCHED_FIFO/SCHED_RR),
100~139 用于普通任务(SCHED_OTHER),值越小优先级越高。
调度时:
直接从最高优先级非空队列取任务
位图辅助查找
复杂度:
O(1)
听起来完美。
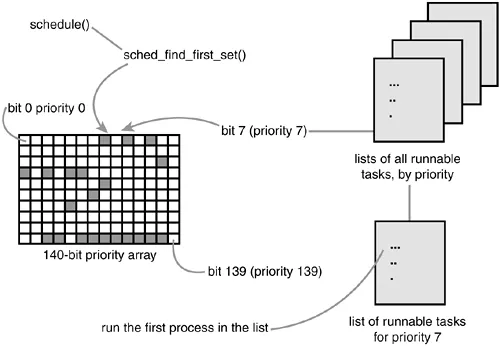
linux O(1)调度器
2️. 但问题出现了
O(1) 是“优先级驱动”的。
副作用:
交互进程可能被 CPU 密集型任务压制
复杂 heuristics 被不断加入
调度器代码越来越难维护
最终变成:
一堆补丁堆起来的“经验系统”。
Linus 评价过:
It grew into a monster.
四、第三阶段:CFS —— 理念翻转
2007 年,Ingo Molnár 提出:
Completely Fair Scheduler
核心思想非常优雅:
不再用优先级驱动,而是模拟“理想多任务 CPU”。
1️. 什么叫“理想 CPU”?
假设:
有 4 个进程
每个都应该得到 25% CPU
现实做不到真正并行,于是:
用时间片交替,尽量逼近理想情况。
关键指标:
vruntime(虚拟运行时间)— fairness value
谁的 vruntime 最小,谁优先运行。 vruntime 的概念,可以参考:
趣话Linux Command③:Process & Scheduling篇——你看到的进程,都是幻象
2️. 数据结构:红黑树
每个 CPU 有一个 runqueue:
用红黑树按 vruntime 排序
每次取最左节点
复杂度:
O(log n)
牺牲常数时间,换来:
可预测公平性
极简逻辑
极强可解释性
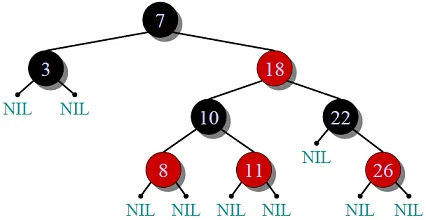
Linux CFS调度器红黑树
我们后续,会专门趣话一期Linux红黑树,为什么Linux调度器设计者Ingo Molnár,在众多的数据排序结构中会选择红黑树?
3️. nice 在 CFS 时代意味着什么?
nice 不再控制“时间片长度”。
它影响的是:
weight
权重决定:
vruntime 增长速度
高优先级进程:
vruntime 增长慢
更频繁被选中
这是一种数学公平,而不是抢占式优先。
五、CFS 的现实问题
CFS 很优雅,但它有一个结构性问题:
它只看“已经运行了多少”,不看“应该什么时候运行”。
当系统负载高、延迟敏感任务多时:
tail latency 不可控
wakeup 处理复杂
于是,新的尝试出现了。
六、第四阶段:EEVDF —— 再次理念升级
Linux 6.6 开始默认引入:
EEVDF(Earliest Eligible Virtual Deadline First)
它的核心改变:
引入“虚拟截止时间”。
1️. CFS vs EEVDF 的关键差异
CFS 逻辑:
选 vruntime 最小的
EEVDF 逻辑:
选“最早到达虚拟截止时间”的
它更接近:
EDF(Earliest Deadline First)
但保持公平性
2. EEVDF 与 CFS 的核心区别
3. 为什么要换?
因为现代负载变了:
微服务
低延迟要求
高并发 IO
多核 NUMA
单纯的“历史运行量公平”不足以保证响应时间。
EEVDF 能更好控制:
latency
wakeup 精度
burst 行为
七、命令如何暴露调度器行为?
来看几个常见命令。
1️.uptime和 load average
load 增高:
不一定 CPU 满
可能大量 D (不可中断睡眠状态)状态任务
调度器视角:
runqueue 长度增长
2️. taskset
taskset -c 0 command
改变的是:
CPU affinity
影响 runqueue 选择
调度不再全局,而是 per-CPU。
八、多核时代的隐藏复杂度
调度不只是:
选一个进程
还包括:
load balance
cache 亲和性
NUMA 迁移成本
迁移一个任务意味着:
L1/L2 cache 全丢
TLB flush (页表缓存)
远程内存访问
所以调度器经常在:
公平 vs cache locality
之间妥协。
九、三代调度器的哲学差异
十、真正值得记住的三句话
Linux 调度器从未追求“最快”,它追求“可解释的公平”。
CFS 是数学化公平的实现,EEVDF 是面向延迟的升级。
你在 top 里看到的 CPU 百分比,本质是调度结果,不是事实。
参考文献:
The Linux Scheduling Algorithm
Why Red Black Tree is the choice for Completely Fair Scheduler ? | by Udbhav Singh | Medium
