跟 AI 学 Linux:为什么另辟蹊径的 BBR 未能取代传统的 TCP 拥塞控制算法 CUBIC?
- 2026-09-16 22:00:59
1. 议题
前文《为什么 TCP Fast Open 很鸡肋?》评论了 Google 的一项工作,本文将探讨 Google 的另外一项工作:TCP 拥塞控制算法 BBR。
BBR 于2016年发布,在 Google 的 B4 backbone 和 YouTube Web servers 取得了显著效果,而且核心贡献者是 Van Jacobson。
这个背景是网络领域的天花板了!Linux 内核也立刻在 4.9 主线版本接受了该特性,但是时至今日 Linux 默认的 TCP 拥塞控制算法还是 CUBIC,这其中的原因是什么呢?
让我们继续请 AI 老师来为我们解惑。
2. 对话
2.1 问
请为我讲解 Google 提出的 TCP 拥塞控制算法 BBR,在讲解过程中需要对比 Linux 当前默认的 CUBIC 算法。
2.2 答
BBR 的核心思路
模型驱动:不依赖”丢包=拥塞”,而是在线估计两个参数:瓶颈带宽 BtlBw 和 最小 RTT(RTprop)。控制发送速率使在途数据量接近 带宽-延迟积(BDP)。
两条控制杠杆:
1. pacing(发包速率):估计带宽 × gain 2. cwnd(在途数据上限):BtlBw × RTprop × cwnd_gain
目标:避免持续队列,填满瓶颈带宽 → 高吞吐 + 低延迟。
BBR 状态机
周期性在四个状态间切换:
CUBIC 核心要点
基于丢包的拥塞控制:用 cwnd 作为主要控制量。无丢包时按三次函数增长 cwnd;检测到丢包则乘性减少窗口。专为高带宽-延迟环境设计,是 Linux 长期默认的拥塞控制算法。
2.3 思考
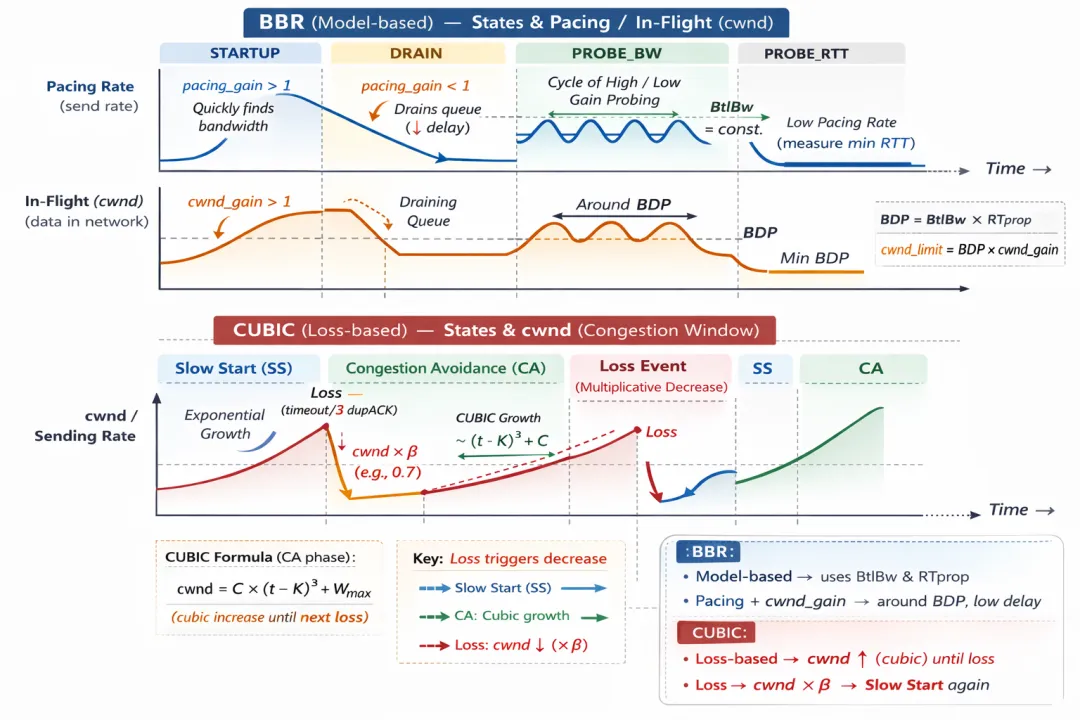
我了解了 BBR 的运行机制,但是我还是不太能掌握 BBR 和 CUBIC 各自的优势,让我继续问 AI 老师。
2.4 问
我理解了 BBR 和 CUBIC 的运行机制,请为我分别列举它们各自有优势的场景,并解释原因。
2.5 答
BBR 占优场景
CUBIC 占优场景
关键权衡
选择建议
• 跨大陆/高 BDP 传输、移动网络 → 优先试用 BBR • 互联网通用服务、需与现有 TCP 公平共存 → 保持 CUBIC • 不确定时做 A/B 测试:对比吞吐、99th RTT、丢包率 • 部署提示:BBR 配合 FQ/FQ-CoDel 更好
2.6 思考
我理解了,感觉 BBR 适合做 HTTP3/QUIC 协议的拥塞控制算法。
AI 老师没有提到数据中心的场景,我试着推理一下:在数据中心场景,链路通常是光纤,RTT 极小,丢包率极低,CUBIC 的窗口增长函数在接近 BDP 时非常激进,能快速填满带宽,所以 CUBIC 是合适的。但是 CUBIC 在超低 RTT、微突发情况下会导致短时队列波动、突发丢包或增加 FCT,因此在数据中心场景最合适的还是 DCTCP 或者定制实现。
另外 AI 老师提到了”公平性”,我感觉这是 BBR 没有成为 Linux 默认算法的一个关键因素,让我继续让 AI 老师把问题讲透彻。
2.7 问
BBR 与 CUBIC 之间的权衡我了解了,那么制约 BBR 成为 Linux 默认拥塞控制算法的关键因素是什么呢?
2.8 答
2.9 思考
总结一下:BBR 在“公平性、对丢包链路的稳健性、以及对测量/运行时异常的鲁棒性”三方面存在系统性不足。
最后再让 AI 老师讲解一下 BBR 后续版本的优化。
2.10 问
针对这些问题,BBRv2 和 BBRv3 做了哪些优化呢?
2.11 答
BBRv2 优化点
• 公平性:更好与 loss-based 算法共存,减少带宽争用的不公平性 • 丢包响应:引入对丢包的有限容忍率,不再完全忽略丢包信号 • ECN 支持:加强 ECN 支持,拥塞控制更主动 • 探测保守性:ProbeBW 阶段更保守,减少队列积累 • 收敛速度:更快适应路径变化
BBRv3 优化点
• ECN 感知:类似 DCTCP 的 ECN 导向控制,避免低延迟网络误判 • 探测优化:探测更快适应网络变化,ProbeRTT 退出更快(减少短流启动延迟) • 稳定性:更低重传率和略低延迟 • 公平性:多 RTT 场景(与 CUBIC/Reno 混合)表现更稳定
2.12 思考
期待 BBRv3 早日合入 Linux 内核主线。
由于测试拥塞控制算法需要网络仿真,本文就暂且跳过「实验」环节,直接进入「内核实现」。
3. 内核实现
3.1 任务
请梳理 @net/ 目录下 TCP 拥塞控制相关的源码,生成报告。需要讲清楚:
• Linux 提供了哪些 TCP 拥塞控制相关的可配置参数? • Linux 是如何实现的 TCP 拥塞控制框架代码,使得可以灵活切换 CUBIC、BBR、DCTCP 等具体实现?
3.2 报告
内核版本: Linux 5.15.198相关目录: net/ipv4/, include/net/
完成的报告在 05_TCP_congestion_control_analysis.md[1],这里仅摘要关键点。
Sysctl/Procfs 配置参数
位置: net/ipv4/sysctl_net_ipv4.c:852-870
1. tcp_congestion_control
/proc/sys/net/ipv4/tcp_congestion_control | |
proc_tcp_congestion_control() |
用法:
# 查看默认算法cat /proc/sys/net/ipv4/tcp_congestion_control# 设置默认算法echo "bbr" > /proc/sys/net/ipv4/tcp_congestion_control2. tcp_available_congestion_control
/proc/sys/net/ipv4/tcp_available_congestion_control | |
proc_tcp_available_congestion_control() |
用法:
cat /proc/sys/net/ipv4/tcp_available_congestion_control# 输出示例: cubic reno bbr dctcp vegas htcp ...3. tcp_allowed_congestion_control
/proc/sys/net/ipv4/tcp_allowed_congestion_control | |
proc_allowed_congestion_control() |
用法:
# 只允许 cubic 和 renoecho "cubic reno" > /proc/sys/net/ipv4/tcp_allowed_congestion_controlSocket 选项配置
TCP_CONGESTION
include/uapi/linux/tcp.h:104 | |
设置 (setsockopt): net/ipv4/tcp.c:3419-3437
case TCP_CONGESTION: { char name[TCP_CA_NAME_MAX]; if (optlen < 1) return -EINVAL; val = strncpy_from_sockptr(name, optval, min_t(long, TCP_CA_NAME_MAX-1, optlen)); if (val < 0) return -EFAULT; name[val] = 0; lock_sock(sk); err = tcp_set_congestion_control(sk, name, true, ns_capable(sock_net(sk)->user_ns, CAP_NET_ADMIN)); release_sock(sk); return err;}获取 (getsockopt): net/ipv4/tcp.c:4067-4075
case TCP_CONGESTION: if (get_user(len, optlen)) return -EFAULT; len = min_t(unsigned int, len, TCP_CA_NAME_MAX); if (put_user(len, optlen)) return -EFAULT; if (copy_to_user(optval, icsk->icsk_ca_ops->name, len)) return -EFAULT; return 0;算法切换机制
1. 算法注册流程
模块加载 (insmod tcp_cubic) │ ▼module_init() -> cubictcp_register() │ ▼tcp_register_congestion_control(&cubictcp) │ ├── 检查必需函数 (ssthresh, undo_cwnd, cong_avoid/cong_control) │ │ │ └── 缺少则返回 -EINVAL │ ├── 计算哈希键值 (jhash) │ ├── 检查键值唯一性 │ │ │ └── 重复则返回 -EEXIST │ └── 添加到 tcp_cong_list 全局链表 │ └── 成功返回 02. 默认算法选择流程
系统启动 │ ▼late_initcall(tcp_congestion_default) │ ▼tcp_set_default_congestion_control(&init_net, CONFIG_DEFAULT_TCP_CONG) │ ├── 查找算法 (tcp_ca_find_autoload) │ ├── 尝试获取模块引用 │ └── 设置 net->ipv4.tcp_congestion_control内核配置:
CONFIG_DEFAULT_TCP_CONG="cubic" # 默认拥塞控制算法3. Socket 算法分配流程
socket(AF_INET, SOCK_STREAM) │ ▼tcp_v4_init_sock() │ ▼tcp_assign_congestion_control(sk) │ ├── rcu_read_lock() │ ├── 获取 net->ipv4.tcp_congestion_control (默认算法) │ ├── bpf_try_module_get(ca, ca->owner) │ │ │ ├── 成功: 设置 icsk->icsk_ca_ops = ca │ │ │ └── 失败: 回退到 tcp_reno │ ├── 初始化 icsk_ca_priv[] │ └── 根据 flags 设置 ECN │ ├── TCP_CONG_NEEDS_ECN -> INET_ECN_xmit() │ └── 否则 -> INET_ECN_dontxmit()4. 运行时算法切换流程 (setsockopt)
用户调用 setsockopt(TCP_CONGESTION, "bbr") │ ▼do_tcp_setsockopt() -> tcp_set_congestion_control() │ ├── 检查 icsk_ca_dst_locked │ │ │ └── 锁定则返回 -EPERM │ ├── 查找算法 (tcp_ca_find_autoload) │ │ │ ├── 找到: ca = tcp_ca_find("bbr") │ │ │ └── 未找到: request_module("tcp_bbr") -> 重试 │ ├── 检查权限 │ │ │ ├── ca->flags & TCP_CONG_NON_RESTRICTED -> 允许 │ │ │ └── 否则: 需要 CAP_NET_ADMIN │ ├── bpf_try_module_get(ca, ca->owner) │ │ │ └── 失败则返回 -EBUSY │ └── tcp_reinit_congestion_control(sk, ca) │ ├── tcp_cleanup_congestion_control(sk) │ │ │ ├── 调用旧算法的 release() │ │ │ └── bpf_module_put(旧算法) │ ├── icsk->icsk_ca_ops = ca (新算法) │ ├── memset(icsk_ca_priv, 0) │ └── 如果已连接 -> tcp_init_congestion_control(sk) │ ├── 调用新算法的 init() │ └── icsk_ca_initialized = 15. 算法调用流程
数据包 ACK 到达 │ ▼tcp_ack() -> tcp_cong_avoid() │ ├── 检查是否拥塞窗口受限 │ ├── 是否慢启动? │ │ │ ├── 是: tcp_slow_start() │ │ │ └── 否: 调用 icsk_ca_ops->cong_avoid() │ │ │ ├── CUBIC: cubictcp_cong_avoid() │ │ │ ├── Reno: tcp_reno_cong_avoid() │ │ │ └── DCTCP: tcp_reno_cong_avoid() (使用 Reno) │ └── 或者调用 cong_control() (BBR)1. https://gitee.com/shichaoyuan/learn-linux-with-ai↩︎
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Python数据分析的四大金刚:手把手入门Numpy、Pandas、Matplotlib、Seaborn
- 每天认识一个新的Python库:pydantic_ai, 一键复刻一个使用 GLM Cloud 的免费 chatGPT
- 【小沐学Python】从0到1做桌面软件,看完这篇就够了!Python 界面开发(六)
- openclaw很像最早的电脑操作系统linux
- 第四次培训Python 系列课程第二期:聚焦列表核心操作,筑牢编程技能基石
- 我愿称之为Python自动化办公最详细知识库!!
- 【Linux.do中转站们】风雨缥缈 各有悲欢吧~
- CIE中国电子学会Python 四级考点
- 零基础系统学Python|保姆级路线图,一篇从入门到实战(建议收藏)
- 一图概括Python开发中最顶级的库和框架!!