在 Linux 系统中,用户会发现一个非常惊讶的现象:即便文件系统非常庞大、包含数百万文件,ls、cat 等命令依然可以在毫秒级别定位文件。这个高性能的核心秘密在于 dcache(Directory Cache,目录缓存)。
我们从原理、实现、内核源码调用链、缓存优化及实践角度,全面解析 Linux 如何实现如此快速的文件查找。
1. 文件查找的挑战与瓶颈
传统文件系统的查找流程非常直观:路径查找需要从根目录依次读取每一级目录 inode 和目录项(directory entry)信息,然后定位目标文件。
磁盘访问的性能瓶颈
机械硬盘:单次 I/O 可能需要 10ms
固态硬盘:延迟低,但仍比内存慢 3~5 个数量级
多级目录:每级目录都可能产生一次磁盘访问
例如:查找 /usr/bin/vim:
根目录 / → 磁盘 I/O
usr/ → 磁盘 I/O
bin/ → 磁盘 I/O
vim → 磁盘 I/O
如果每次都访问磁盘,响应时间累积至少 40ms(机械硬盘),在高并发场景下更是性能灾难。Linux 面对百万级文件和目录访问时,如果没有缓存机制,性能呈线性下降。传统文件系统查找算法如顺序扫描目录或基于 B+ 树索引,仍受限于磁盘 I/O 延迟。因此,内核必须依赖 内存缓存 来加速路径查找,这正是 dcache 的存在价值。
2. dcache 的概念与数据结构
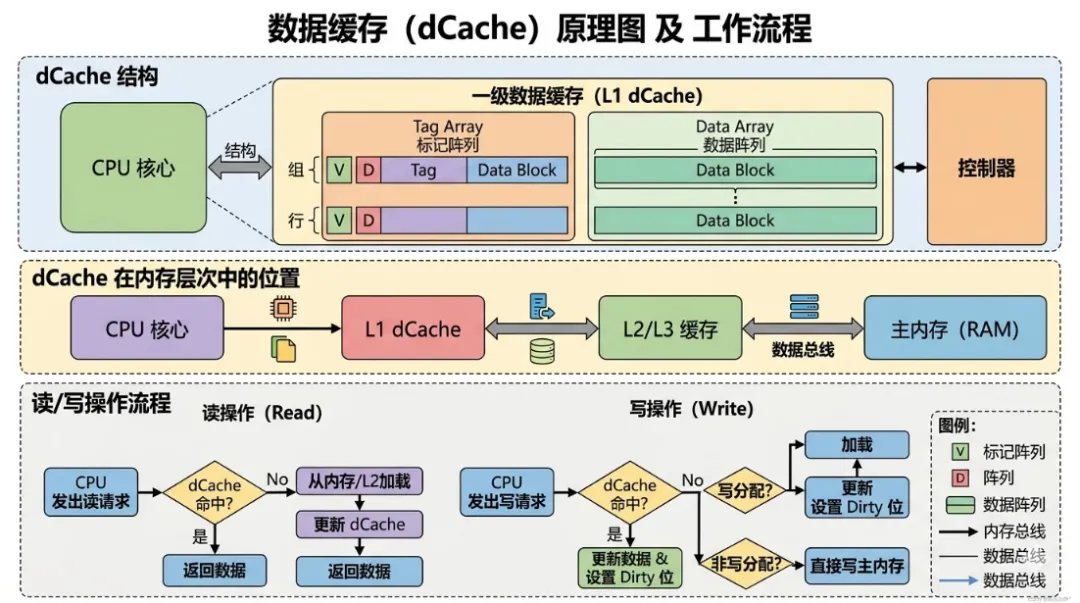
dcache 是 Linux 内核 VFS(Virtual File System) 层的目录项缓存,主要缓存目录 inode 和目录项(dentry),目的是减少磁盘访问。
核心数据结构
struct dentry { struct hlist_node d_hash; // 哈希链表节点 struct inode *d_inode; // 指向对应 inode struct dentry *d_parent; // 父目录指针 struct qstr d_name; // 文件名(哈希+长度) unsigned int d_flags; // 标志位 atomic_t d_count; // 引用计数};
理论解析
dcache 将目录项常驻内存,使得大多数文件查找仅需访问内存,而无需磁盘 I/O。
3. dcache 查找流程(ASCII 流程图)
访问 /usr/bin/vim 的查找流程:
用户态系统调用 | v VFS层 lookup(path) | v+------------------+| 查找父目录 dentry |+------------------+ | v+-------------------------+| 在父目录哈希表查找 name |+-------------------------+ | +----+----+ | |命中 未命中 | |返回 inode 读取磁盘目录块 | 创建 dentry | 插入缓存 | 返回 inode
命中 dcache:直接返回 inode → 内存访问速度 ~100ns
未命中 dcache:磁盘读取目录块 → 构建新的 dentry → 插入缓存 → 返回 inode
命中率通常 >90%,高并发文件访问几乎不触发磁盘 I/O
内核采用 dentry + inode + page cache 的多层缓存体系,实现路径访问优化
路径中父目录缓存命中可避免多级磁盘访问
4. 内核源码调用链
Linux 内核访问文件时,典型调用链如下(Linux 5.15+):
用户态 open("/usr/bin/vim") | vsys_open() / do_sys_open() | vpath_lookup() / user_path_at() | vwalk_component() // 遍历每级路径 | v__lookup_hash() // dcache 哈希表查找 | +---> dentry命中 -> 返回 inode | +---> 未命中 -> 文件系统->lookup() -> 读取磁盘块 -> 插入缓存
源码解析:
__lookup_hash():核心函数,执行哈希表查找
d_lookup():根据父目录 dentry 和名字查找已有 dentry
d_rehash() / d_add():插入新 dentry
dget() / dput():引用计数管理,保证生命周期安全
理论扩展:
5. dcache 回收策略
dcache 并不是无限增长,内核采用 LRU 风格回收:
6. dcache 优化实践
针对性能敏感系统,可优化策略:
加大 dentry/inode 缓存
目录层级优化
避免单目录下数十万文件
哈希查找 O(1),但缓存插入和内存占用仍受限
热点目录缓存
tmpfs / ramdisk 持久化关键目录
避免频繁磁盘 I/O
监控缓存状态
高命中率的 dcache 是 Linux 文件系统高性能的关键
企业级服务器、数据库和文件服务器依赖 dcache 提升并发访问性能
对比 Windows NTFS,Linux dcache 在高并发小文件访问场景下更高效
7. 总结
Linux 文件查找之所以快,核心原因是 dcache 目录缓存:
内存哈希表 + dentry 数据结构 → O(1) 查找
多级缓存体系:dcache + inode cache + page cache → 内存优先
LRU 风格回收,平衡性能与内存占用
内核源码调用链明确,命中率高 → 绝大多数查找仅在内存完成
文件访问时间 ≈ 内存命中率 × 内存访问时间 + 未命中率 × 磁盘访问时间
掌握 dcache 原理,对 Linux 文件系统调优、应用性能优化以及高并发设计都有极大帮助。
 10个月宝宝每天需要喝多少奶粉?