目录:
1、为什么选择 BeautifulSoup4?
2、快速上手:安装与基础解析
(1)安装
(2)创建BeautifulSoup对象
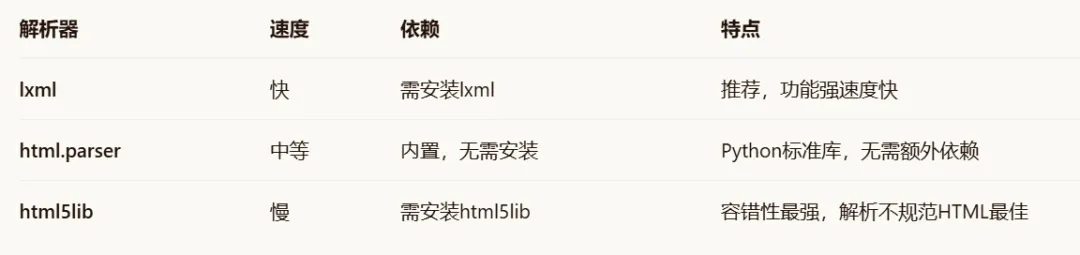
(3)解析器选择指南
3、核心API详解:查找与提取
(1)查找单个元素
(2)查找多个元素
(3)CSS选择器(最常用)
(4)提取数据
(5)遍历文档树
语法直观:类似jQuery的选择器语法,学习曲线平缓
容错性强:即使面对不规范的HTML也能优雅处理
解析器多样:支持多种后端解析器(lxml, html.parser, html5lib)
功能全面:查找、遍历、修改、编码转换一应俱全
# ❌ 正则表达式 - 脆弱且复杂import rehtml = '<div class="price">¥199.00</div>'price = re.search(r'¥(\d+\.\d+)', html).group(1)# ✅ BeautifulSoup - 直观且健壮from bs4 import BeautifulSoupsoup = BeautifulSoup(html, 'html.parser')price = soup.find('div', class_='price').text.strip('¥')
正则表达式适合简单文本匹配,但对于复杂的HTML文档结构,bs4的语义化操作更安全、更易维护。
# 安装bs4pip install beautifulsoup4# 推荐同时安装lxml解析器(速度更快)pip install lxml
from bs4 import BeautifulSoup# 从字符串解析html_doc = """<html><head><title>测试页面</title></head><body> <p class="intro">这是一个测试页面</p> <a href="https://example.com" id="link1">链接1</a></body></html>"""soup = BeautifulSoup(html_doc, 'lxml') # 使用lxml解析器# 或 soup = BeautifulSoup(html_doc, 'html.parser') # 使用内置解析器# 从文件解析with open('index.html', 'r', encoding='utf-8') as f: soup = BeautifulSoup(f, 'lxml')# 从网络响应解析(通常配合requests库)import requestsresponse = requests.get('https://example.com')soup = BeautifulSoup(response.text, 'lxml')
最佳实践:默认使用'lxml',如果环境限制再使用'html.parser'。
# 通过标签名查找(返回第一个匹配)first_p = soup.pfirst_a = soup.find('a') # 等价于 soup.a# 通过属性查找link = soup.find(id='link1')intro = soup.find(class_='intro') # 注意:class是Python关键字,需加下划线link2 = soup.find(attrs={'href': 'https://example.com'}) # 任意属性# 结合标签和属性specific_link = soup.find('a', id='link1')
# 查找所有p标签all_paragraphs = soup.find_all('p')# 查找所有a标签all_links = soup.find_all('a')# 查找所有class为intro的元素all_intro = soup.find_all(class_='intro')# 查找所有a标签且class为externalexternal_links = soup.find_all('a', class_='external')# 限制查找数量first_two_links = soup.find_all('a', limit=2)
# 类选择器intro_elements = soup.select('.intro')# ID选择器link_element = soup.select('#link1')# 标签选择器p_elements = soup.select('p')# 组合选择器external_links = soup.select('a.external')header_links = soup.select('header a')# 属性选择器secure_links = soup.select('a[href^="https"]') # href以https开头pdf_links = soup.select('a[href$=".pdf"]') # href以.pdf结尾
# 获取文本element = soup.find('p', class_='intro')text = element.text # 获取元素及其子元素的所有文本text = element.get_text() # 同上text = element.string # 仅当元素只有一个字符串子节点时有效texts = element.strings # 获取所有字符串的生成器stripped_texts = element.stripped_strings # 获取去空白后的字符串生成器# 获取属性link = soup.find('a')url = link['href'] # 方式1:字典式访问url = link.get('href') # 方式2:get方法,可设默认值url = link.get('href', '#') # 如果href不存在,返回'#'# 获取所有属性all_attrs = link.attrs # 返回属性字典
# 子节点soup.body.contents # 返回所有子节点的列表(包括换行符等)soup.body.children # 返回子节点的迭代器soup.body.descendants # 返回所有后代节点的迭代器# 父节点link.parent # 直接父节点link.parents # 所有祖先节点的迭代器# 兄弟节点link.next_sibling # 下一个兄弟节点link.previous_sibling # 上一个兄弟节点link.next_siblings # 后面所有兄弟节点的迭代器link.previous_siblings # 前面所有兄弟节点的迭代器
🔸 守规矩:爬前先看 robots.txt,尊重网站规则。
🔸 有礼貌:设置访问间隔(如 time.sleep),别把服务器挤爆。
🔸 装得像:带上合理 User-Agent和请求头,模拟真人浏览器。
🔸 不越界:绝不爬取个人隐私、机密或明确禁止的数据。
🔸 存得好:妥善处理数据,注明来源,注意脱敏。