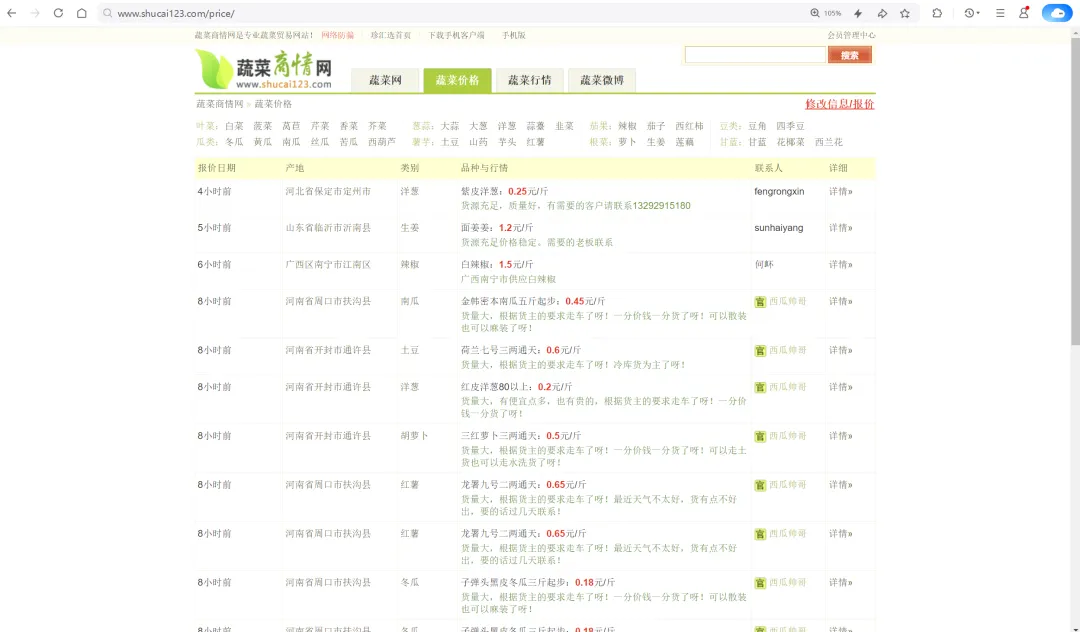
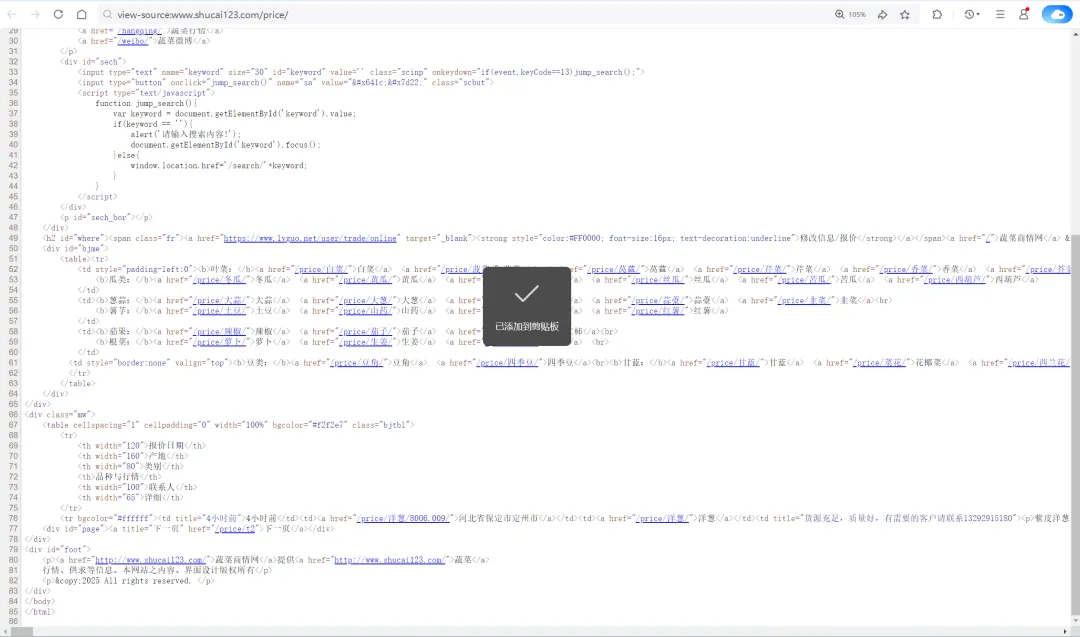
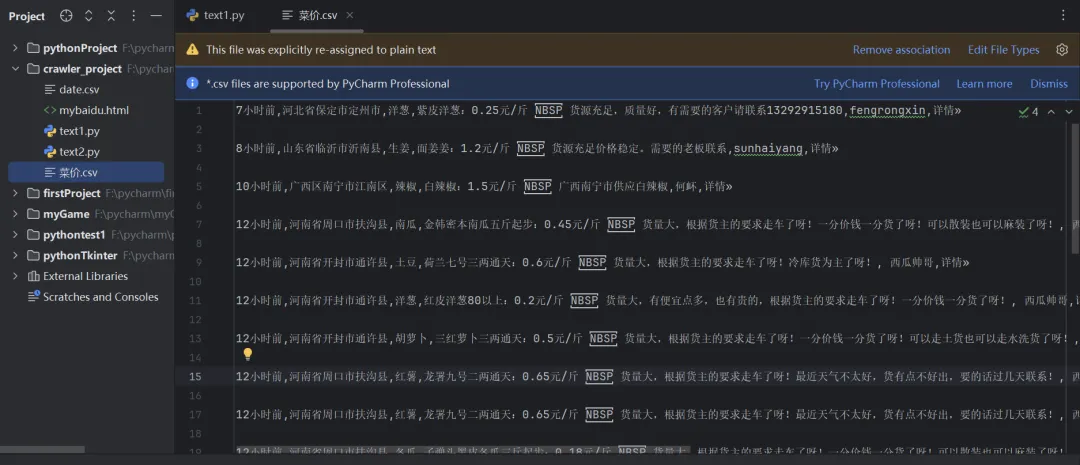
# 安装# pip install bs4 -i 清华# 1、拿到页面源代码# 2、使用bs4进行解析,拿到数据import requestsfrom bs4 import BeautifulSoupimport csvurl = "http://www.shucai123.com/price/"headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.5845.97 Safari/537.36 Core/1.116.559.400 QQBrowser/19.6.6683.400"}resp = requests.get(url, headers=headers) # 爬取数据不完整,建议加headers看看resp.encoding = "utf-8"# print(resp.text)f = open("菜价.csv", mode="w", encoding="utf-8")csvwrite = csv.writer(f)# 解析数据# 1、把页面源代码交给BeautifulSoup进行处理,生成bs对象page = BeautifulSoup(resp.text, "html.parser") # 指定html解析器# print(page)# 2、从bs对象中查找数据# find(标签,属性=值)# find_all(标签,属性=值)# table = page.find("table", class_="bjtbl") # class是python的关键字table = page.find("table", attrs={"class": "bjtbl"}) # 和上一行是一个意思,此时可以避免class# print(table)# 拿到所有数据行trs = table.find_all("tr")[1:]# print(trs)for tr in trs: # 每一行 tds = tr.find_all("td") # 拿到每行中的所有td date1 = tds[0].text # .text 表示被标签标记的内容 place1 = tds[1].text # .text 表示被标签标记的内容 kind1 = tds[2].text # .text 表示被标签标记的内容 price1 = tds[3].text # .text 表示被标签标记的内容 people1 = tds[4].text # .text 表示被标签标记的内容 more1 = tds[5].text # .text 表示被标签标记的内容 csvwrite.writerow([date1, place1, kind1, price1, people1, more1])f.close()print("over!!!")
 10个月宝宝每天需要喝多少奶粉?