最近有时间,整理了部分关于linux运维的相关文章,希望可以帮助一些小白入手,但还是老话长谈,无论是优化还是修改配置一定一定一定要先备份好,不然改错真的很麻烦,今儿在聊聊其他Linux命令的组合拳,照着做,服务器再卡也不慌。
先搞清楚:服务器卡顿时第一步该干嘛?
很多新手一看到服务器卡,第一反应是重启。大错特错!重启能解决一时,但你永远不知道是什么把服务器搞挂的。下次还卡,你总不能天天重启吧?
正确的姿势是这样的:
# 第一步:看整体负载uptime
输出示例:
15:30:22 up 45 days, 3:22, 1 user, load average: 8.52, 6.31, 4.89
重点看 load average 这三个数:
判断标准: 如果负载数值 > CPU 核心数,说明服务器已经过载了。比如你是 4 核 CPU,负载超过 4 就要警惕了。
找出罪魁祸首:谁在吃资源?
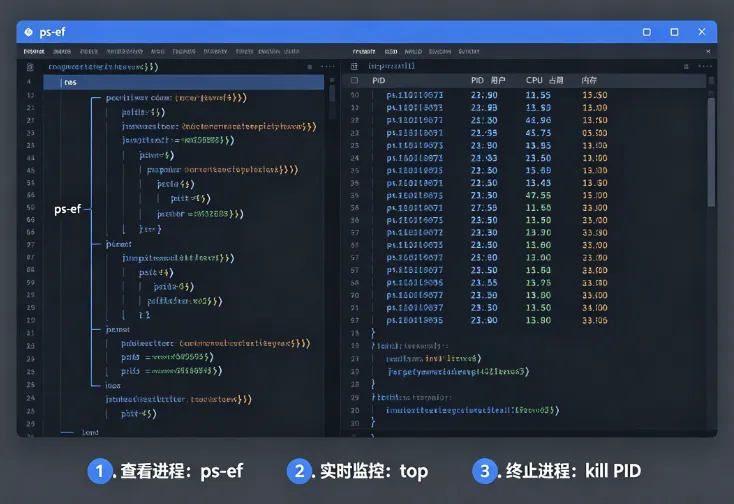
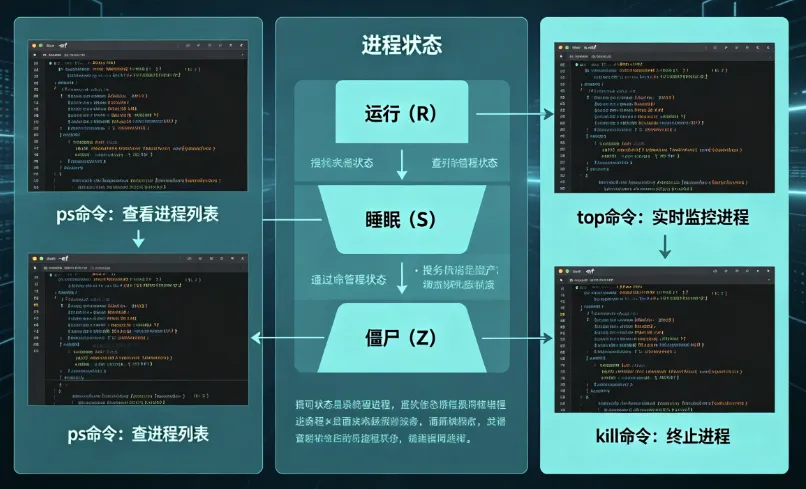
用 top 命令实时查看
top
进入 top 界面后,按几个快捷键:
重点关注这几列:
用 ps 命令静态查看
如果你想把进程信息保存下来分析,用 ps:
# 按 CPU 使用率排序,显示前 10 个进程ps aux --sort=-%cpu | head -n 11# 按内存使用率排序,显示前 10 个进程ps aux --sort=-%mem | head -n 11
输出示例:
USER PID %CPU %MEM VSZ RSS TTY STAT START TIME COMMANDroot 1234 85.2 2.1 256789 43210 ? R 10:00 12:34 javawww-data 5678 12.3 8.5 512345 172340 ? S 09:00 3:21 php-fpmmysql 9012 8.7 15.2 1024567 309876 ? S 08:00 45:12 mysqld
老哥经验: 如果看到某个进程 CPU 长期超过 80%,或者内存占用异常高,大概率就是它了。
精准打击:优雅地结束问题进程
找到问题进程后,别急着 kill -9。杀进程也是有讲究的。
先尝试温柔地终止
# 发送 SIGTERM 信号,让进程自己清理后退出kill 1234
等个几秒钟,检查进程还在不在:
ps -p 1234
如果进程还在,说明它不听话,那就上硬的。
强制终止(慎用!)
# 发送 SIGKILL 信号,强制杀死进程kill -9 1234
警告:kill -9 不会给进程任何清理的机会,可能导致数据丢失或文件损坏。只在进程完全无响应时使用。
批量杀进程(同类型进程一起处理)
# 杀死所有名为 php-fpm 的进程pkill php-fpm# 或者用 killallkillall php-fpm# 更狠的:杀死所有 php 相关进程pkill -9 php
进阶技巧:深入分析进程行为
查看进程打开了哪些文件
有时候进程卡住是因为文件锁或者 IO 问题:
# 查看进程 1234 打开的所有文件lsof -p 1234# 查看某个文件被哪些进程占用lsof /var/log/nginx/error.log
查看进程的系统调用
如果进程卡住但不知道在干嘛,可以跟踪它的系统调用:
# 跟踪进程 1234 的系统调用strace -p 1234# 只统计调用次数,不输出详细内容strace -c -p 1234
老哥实战案例: 有一次服务器卡死,用 strace 发现某个 PHP 进程一直在尝试连接一个已经下线的数据库,导致大量超时等待。修复数据库配置后问题解决。
查看进程的线程详情
有些进程(比如 Java)会启动大量线程:
# 查看进程 1234 的所有线程top -H -p 1234# 或者用 ps 查看线程ps -eLf | grep 1234
预防胜于治疗:让进程管理自动化
设置进程资源限制
防止某个进程吃光所有资源,可以用 ulimit:
# 编辑 limits.confvim /etc/security/limits.conf# 添加以下内容(限制 www-data 用户的进程)www-data soft nofile 65535www-data hard nofile 65535www-data soft nproc 4096www-data hard nproc 4096
用 systemd 管理服务的资源限制
如果是 systemd 管理的服务,可以直接在 service 文件里限制:
# 编辑 nginx 服务配置systemctl edit nginx# 添加以下内容[Service]CPUQuota=80%MemoryLimit=2G
写个监控脚本自动报警
#!/bin/bash# 保存为 /usr/local/bin/check-process.shTHRESHOLD=80 # CPU 阈值# 获取 CPU 使用率最高的进程TOP_PROC=$(ps aux --sort=-%cpu | head -n 2 | tail -n 1)PID=$(echo$TOP_PROC | awk '{print $2}')CPU=$(echo$TOP_PROC | awk '{print $3}')CMD=$(echo$TOP_PROC | awk '{print $11}')# 如果超过阈值,记录日志if (( $(echo "$CPU > $THRESHOLD" | bc -l) )); thenecho"$(date): 警告!进程 $CMD (PID: $PID) CPU 使用率 ${CPU}% 超过阈值" >> /var/log/process-alert.logfi
然后加到 crontab 里,每 5 分钟检查一次:
*/5 * * * * /usr/local/bin/check-process.sh
老哥的私房命令清单
最后分享几个我常用的组合命令,复制就能用:
# 1. 一键查看最耗资源的 5 个进程ps aux --sort=-%cpu | head -n 6# 2. 查看僵尸进程(状态为 Z 的进程)ps aux | awk '$8 ~ /Z/ {print}'# 3. 杀死所有僵尸进程的父进程(谨慎使用!)ps aux | awk '$8 ~ /Z/ {print $2}' | xargs -I {} ps -o ppid= -p {} | xargs -I {} kill -9 {}# 4. 实时监控 CPU 最高的进程(每 2 秒刷新)watch -n 2 'ps aux --sort=-%cpu | head -n 6'# 5. 查看进程的完整启动命令cat /proc/1234/cmdline | tr'\0'' '
总结
进程管理是运维的基本功,但很多人只会 kill -9。今天教的这些方法,从排查到分析到预防,形成了一套完整的流程。
记住三点:
服务器运维这条路,老哥我还在继续摸索。你有什么进程管理的独门秘籍?欢迎在评论区交流!
参考资料:
man ps- Linux Performance Analysis: http://www.brendangregg.com/linuxperf.html