2026年值得关注的Python库
2026年的Python生态确实迎来了一波由性能驱动的大换代。以下是从开发工具链、数据处理、AI应用和自动化办公四个维度精选的9个“封神”库,它们能直接替代你项目中的旧工具,带来显著的效率提升 |
一、开发工具链
1.uv库: 一个命令,解决所有Python包与虚拟环境管理 (夯)
可替代对象:pip, virtualenv, pyenv
新一代Python包管理器:
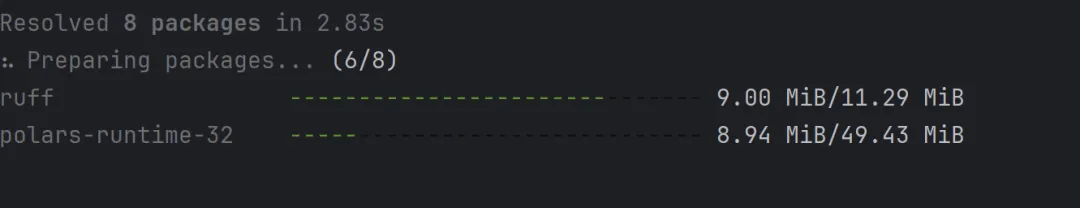
这是来自Ruff团队的大作,一个用Rust编写的工具,旨在整合 pip, virtualenv, pyenv 三者的功能。它最大的魅力在于其不可思议的速度:创建虚拟环境从秒级压缩到近乎瞬时,安装依赖包将分钟级的等待缩短为秒级,这在旧工具上几乎无法想象。
# 创建并激活虚拟环境uv venv.\.venv\Scripts\activate # 安装依赖(比 pip install 快几十倍 并行下载速度要快uv pip install ruff polars pydantic# 零依赖运行脚本(无需事先创建虚拟环境)uv run python script.py
2.Ruff库:代码检查与格式化的瑞士军刀(夯)
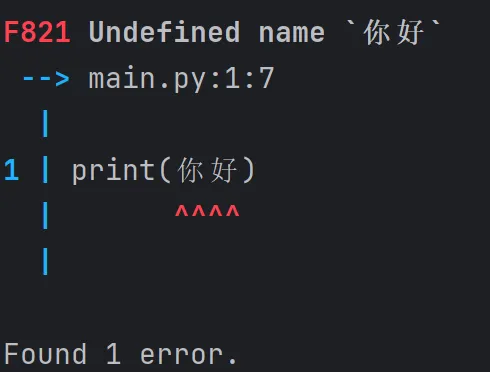
Ruff因一个二进制文件替代了五个常用的代码检查工具而闻名。作为几乎所有场景下旧工具的替代品,它拥有以下特点:
极速:以毫秒级甚至亚秒级的惊人速度检查整个代码库,而旧工具通常需要数秒甚至更长。
统一配置:所有检查规则都统一配置在 pyproject.toml 文件中,告别多个工具的繁杂配置。
功能全面:内置数百条规则,其功能涵盖 Flake8、Black、isort 等多个工具的能力
# 检查并格式化整个项目ruff check . --fix # 检查代码并自动修复问题ruff format . # 直接格式化代码
3. Typer库:Python风格的命令行工具(顶级)
当你需要为脚本创建一个像 ls 或 grep 那样专业的CLI时,Typer 是比 argparse 或 click 更便捷的选择。它允许你定义一个函数,再通过类型注解和参数默认值,即可自动完成参数解析、类型校验和帮助文档的生成。
Typer 只需几行代码就能写出专业命令行工具
基于类型注解,不用写复杂解析逻辑
自动生成 --help 帮助文档
示例代码直接复制即可运行,零学习成本
# 导入 Typerimport typer# 创建一个 Typer 应用app = typer.Typer()# 1. 最简单的命令:无参数@app.command()def hello(): """打印 Hello World""" typer.echo("👋 Hello, Typer!")# 2. 带位置参数的命令@app.command()def greet(name: str): """向指定的人打招呼""" typer.echo(f"Hello {name}! 👋")# 3. 带可选参数(选项)的命令@app.command()def multiply(a: int, b: int, verbose: bool = False): """计算两个数字的乘积""" result = a * b if verbose: typer.echo(f"计算 {a} * {b} = {result}") else: typer.echo(result)# 运行应用if __name__ == "__main__": app()
运行测试
1. 查看帮助(Typer 自动生成)
输出:
Usage: main.py [OPTIONS] COMMAND [ARGS]...╭─ Options ────────────────────────────────────╮│ --install-completion Install completion for the current shell. ││ --show-completion Show completion for the current shell, to copy it or customize the installation. ││ --help Show this message and exit. │╰───────────────────────────────────────────────╯╭─ Commands ───────────────────────────────────╮│ greet 向指定的人打招呼 ││ hello 打印 Hello World ││ multiply 计算两个数字的乘积 │╰───────────────────────────────────────────────╯
2.运行 hello 命令
输出:
3.运行 greet 命令(带参数)
输出:
4.运行 multiply 命令(带数字参数 + 可选开关)
输出:
二、数据处理
1.Polars: 披着Rust外衣的“新一代Pandas”(夯)
Polars是一个用Rust编写的数据处理库,旨在从零开始重新定义DataFrame应有的样子,设计之初就考虑了现代硬件性能和内存效率。它相较于 pandas 主要有以下两大优势:
import polars as pl# 惰性求值:先构建操作计划,再执行df = pl.scan_csv("sales.csv") \ .filter(pl.col("count") > 200) \ .group_by("datetime") \ .agg(pl.col("count").mean()) \ .collect() # 到这一步才开始真正计算print(df)
shape: (2_518, 2)
┌─────────────────────┬───────┐
│ datetime ┆ count │
│ --- ┆ --- │
│ str ┆ f64 │
╞═════════════════════╪═══════╡
│ 2011-12-20 19:00:00 ┆ 275.0 │
│ 2012-02-27 18:00:00 ┆ 528.0 │
│ 2012-06-21 15:00:00 ┆ 256.0 │
│ 2012-10-22 18:00:00 ┆ 705.0 │
│ 2012-06-21 17:00:00 ┆ 752.0 │
│ … ┆ … │
│ 2012-01-26 08:00:00 ┆ 508.0 │
│ 2012-06-24 19:00:00 ┆ 423.0 │
│ 2012-02-29 17:00:00 ┆ 359.0 │
│ 2012-06-26 14:00:00 ┆ 287.0 │
│ 2012-09-26 22:00:00 ┆ 203.0 │
└─────────────────────┴───────┘
这段代码中,scan_csv 只是声明了一个操作,由 collect() 触发时才进行计算。Polars 在此期间会自动重排操作顺序,只读取必要的列,显著减少内存占用并提升处理速度。2.orjson:更快更严谨的JSON(夯)
orjson是一个完全用Rust编写的库,用来替代标准库 json 或 ujson。它的特点包括:
可以看到,直接使用它就能获得性能提升,API与标准库几乎完全兼容,可以作为 json.loads / json.dumps 的直接替代品。3.DuckDB:你Python进程里的“分析型数据库”(顶级)
DuckDB是一个嵌入式的列式数据库,它被“内嵌”在你的Python程序中,无需任何额外配置。当需要在 pandas DataFrame、CSV或Parquet文件上执行复杂的SQL查询时,它是最佳选择。import duckdbimport polars as pl# 直接在 Polars DataFrame 上执行 SQLdf = pl.DataFrame({"name": ["小张", "小李"], "salary": [30000, 50000]})result = duckdb.sql(""" SELECT name, salary FROM df WHERE salary > 35000""").pl() # 结果直接转为 Polars DataFrameprint(result)
结果:
shape: (1, 2)
┌──────┬────────┐
│ name ┆ salary │
│ --- ┆ --- │
│ str ┆ i64 │
╞══════╪════════╡
│ 小李 ┆ 50000 │
└──────┴────────┘
你可以看到,DuckDB甚至不需要任何表定义的 CREATE 语句,就能直接在已有的DataFrame上运行聚合分析,结果支持以 pandas、Polars 等多种格式返回。
三、AI应用
1.Instructor:让LLM的输出不再“失控”(夯)
Instructor是一个让大型语言模型(LLM)返回结构化数据的库。过去,LLM可能返回格式混乱的纯文本,开发者需要编写复杂的正则表达式(Regex)来手动清洗数据。而 Instructor 颠覆了这一繁琐过程:你只需定义一个 Pydantic 模型,它会自动指导LLM按照这个模型返回严格符合规范的JSON。
import instructorfrom pydantic import BaseModelfrom openai import OpenAI# 1. 定义数据模型class UserInfo(BaseModel): name: str age: int# 2. 创建 OpenAI 客户端client = OpenAI( api_key="apikey", base_url="https://api.deepseek.com/v1",)client = instructor.from_openai( client, mode=instructor.Mode.JSON)# 4. 调用user_info = client.chat.completions.create( model="deepseek-v4-pro", messages=[{"role": "user", "content": "提取哈雷的信息,他今年28岁。"}], response_model=UserInfo,)# 输出结果print("姓名:", user_info.name)print("年龄:", user_info.age)
结果:
这段代码的输出是一个类型安全的 UserInfo 对象,不再是难以解析的原始字符串。
2. Pydantic v2:数据校验的顶梁柱(人上人)
Pydantic v2的核心用Rust重写了,这使得其在数据解析、校验和序列化性能上比v1版本提升了5到50倍。如今,Pydantic 已不仅仅是数据校验工具,它已成为 FastAPI、Instructor 等优秀库的底层基础,并为Python的应用层提供了坚固健壮的类型系统。
from pydantic import BaseModel, Field, EmailStrfrom typing import Optionalclass User(BaseModel): # 定义强类型字段,并添加校验规则 name: str email: EmailStr age: Optional[int] = Field(default=None, ge=0, le=150)# 校验成功,返回 User 对象valid_user = User(name="哈雷", email="harley@example.com", age=30)# 校验失败,触发 ValidationErrortry: invalid_user = User(name="哈雷", email="not-an-email")except Exception as e: print(e)
通过这段代码,Pydantic 自动验证了 email 的格式,并限制了 age 必须为0到150之间的整数,省去了大量手写的 if ... 校验代码。
1.PDFPlumber:PDF表格的“终结者”
PDFPlumber是专门从PDF中提取文本、表格和元数据的工具。与性能低下且早已停止维护的 PyPDF2 相比,它提供了精准的表格解析能力,并且处理大文件时性能也显著更好
提取所有的文本:
import pdfplumber# 打开 PDFwith pdfplumber.open("sample.pdf") as pdf: # 遍历每一页 for page in pdf.pages: # 提取当前页的所有文字 text = page.extract_text() # 打印出来 print("===== 第", page.page_number, "页 =====") print(text)
提取所有的表格:
import pdfplumber# 打开PDF文件with pdfplumber.open("sample.pdf") as pdf: # 遍历每一页 for page in pdf.pages: # 提取该页表格并转为Pandas DataFrame for table in page.extract_tables(): for row in table: print(row)
提取所有的图片并下载:
import pdfplumberimport os# 创建文件夹if not os.path.exists("pdf_images"): os.mkdir("pdf_images")with pdfplumber.open("a.pdf") as pdf: for page_num, page in enumerate(pdf.pages, 1): # 直接用 page.images 遍历,兼容所有版本 for img_id, img in enumerate(page.images, 1): try: # 兼容所有图片格式 → 核心修复 img_obj = page.images[img_id - 1] x0, top, x1, bottom = img_obj["x0"], img_obj["top"], img_obj["x1"], img_obj["bottom"] # 裁剪并保存图片 cropped = page.within_bbox((x0, top, x1, bottom)).to_image() filename = f"pdf_images/page{page_num}_img{img_id}.png" cropped.save(filename) print(f"✅ 已保存:{filename}") except Exception as e: print(f"⚠️ 第{page_num}页图片{img_id} 提取失败:{e}")
这段代码会精确捕捉到PDF中表格的每一个文本字符,并按照其原本的视觉位置进行重构,这对于处理扫描件或复杂排版的文档尤为强大