当前位置:首页>python>Python毕设:基于Spark的全国高校数据可视化系统源码分享 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

Python毕设:基于Spark的全国高校数据可视化系统源码分享 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

  • 2026-10-11 08:00:43
Python毕设:基于Spark的全国高校数据可视化系统源码分享 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘
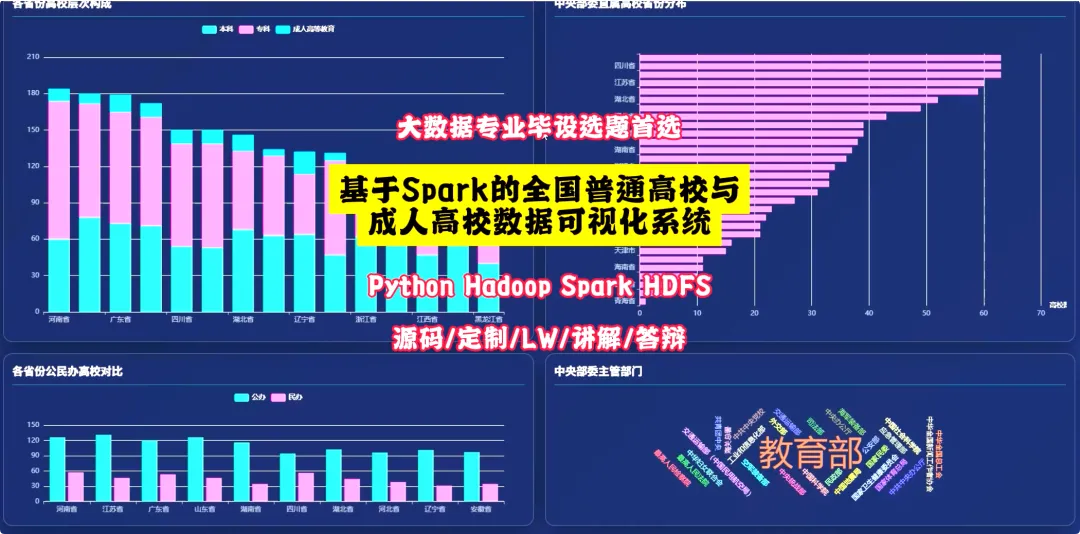
基于Spark的全国普通高校与成人高校数据可视化系统

一

全国普通高校与成人高校数据可视化系统-简介

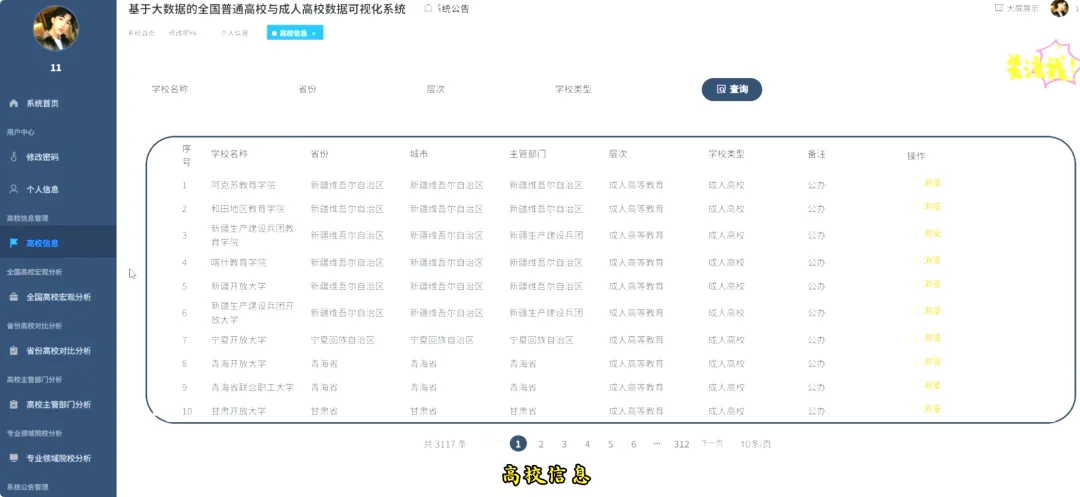
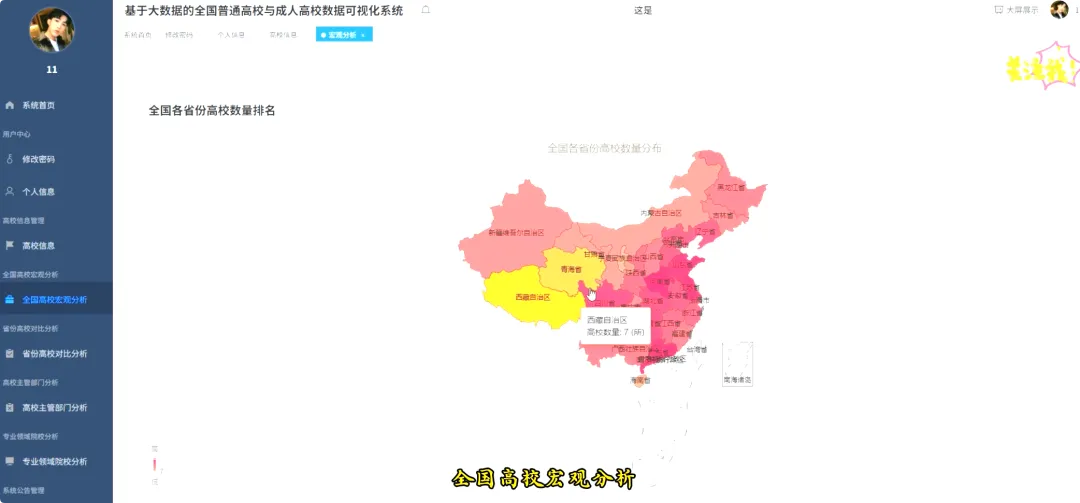
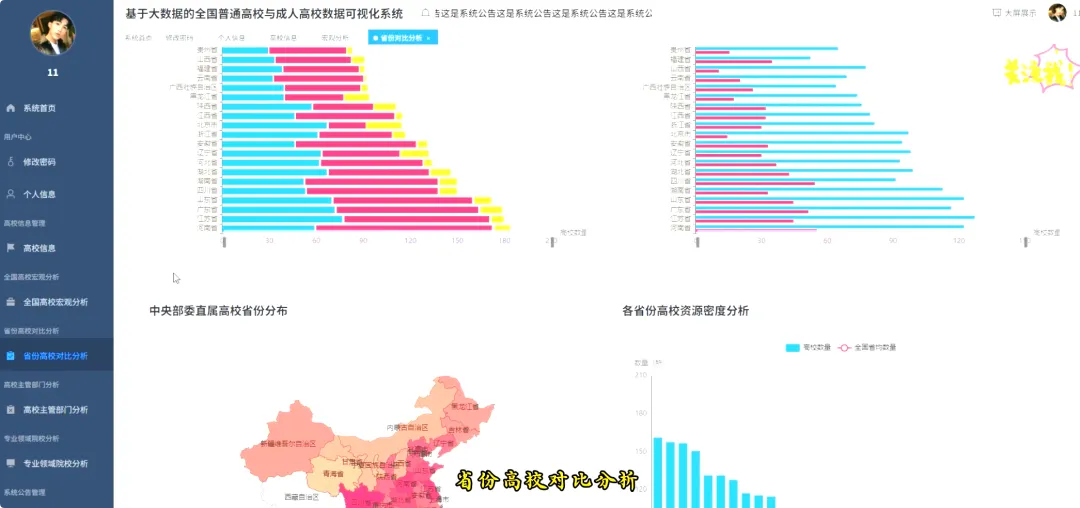
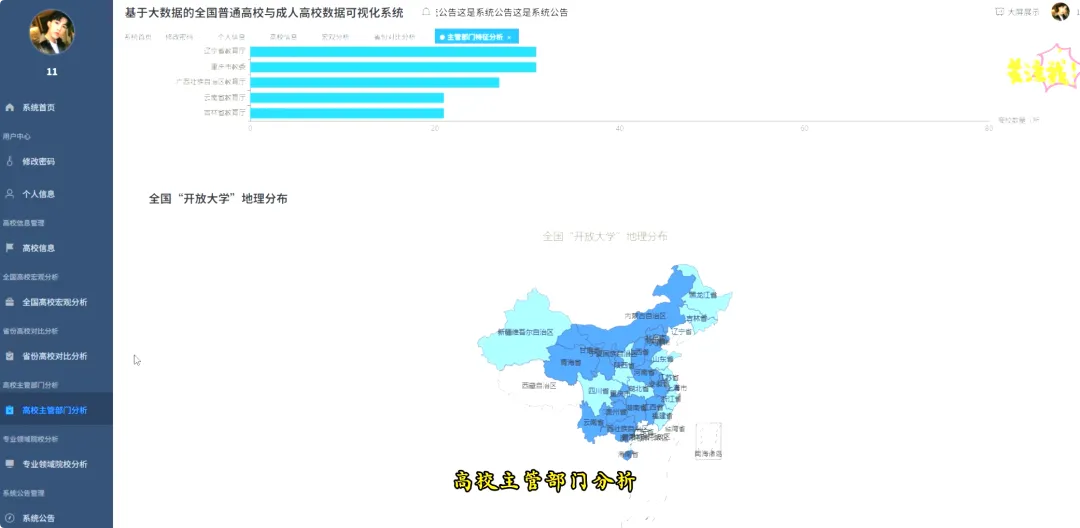
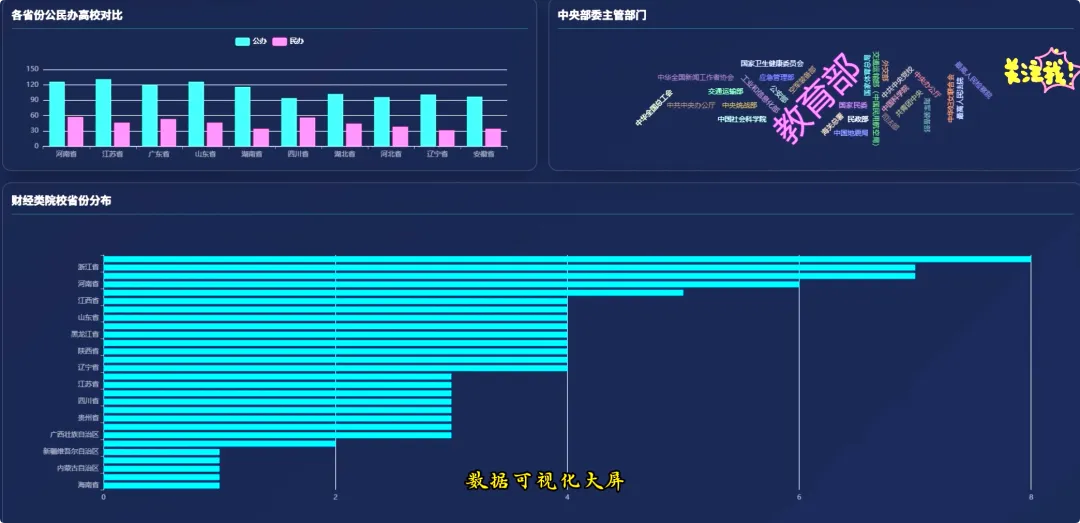
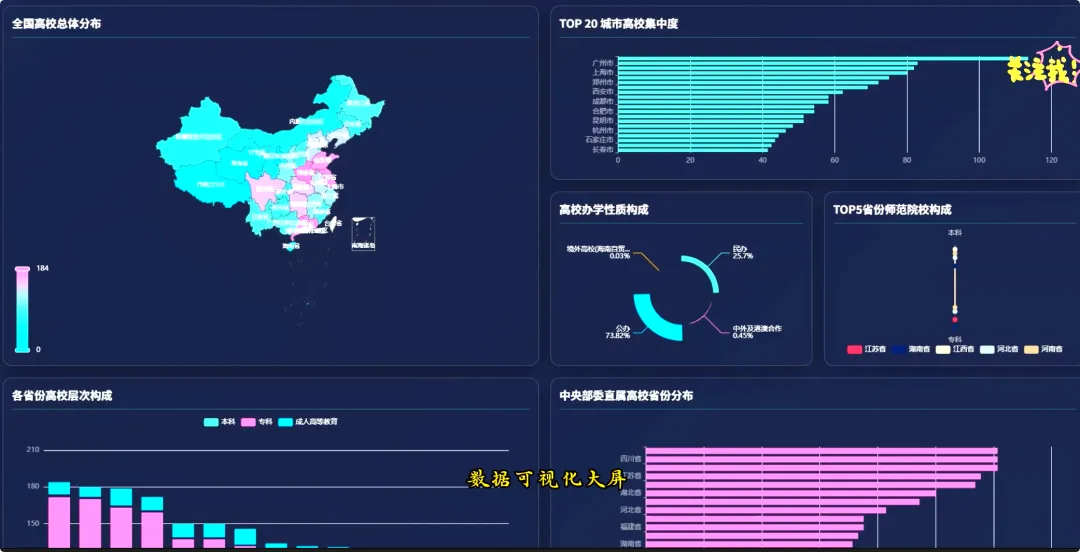
本系统采用Python语言进行开发,后端框架选用Django,前端界面通过Vue框架结合ElementUI组件库搭建,并利用Echarts图表库实现数据的可视化展示。在大数据处理架构上,系统依托Hadoop生态系统,核心计算引擎采用Spark,利用Spark SQL进行结构化数据处理,并结合Pandas与NumPy库进行辅助分析。系统数据集涵盖了全国普通高校与成人高校的详细信息,功能设计主要包含四个核心维度:一是全国高等教育宏观格局分析,通过省份排名、高校类型结构、办学层次及性质构成等指标,宏观展示教育资源分布;二是各省份高等教育资源深度对比,深入剖析各省在办学层次、公民办结构及资源密度上的差异;三是高校主管单位与办学特色分析,重点挖掘中央部委直属高校、开放大学及中外合作办学的分布规律;四是特定专业领域高校专题分析,通过关键词匹配技术,对师范、医药、财经等特定类型院校进行专题研究,实现了从数据清洗、Spark分析处理到前端可视化展示的完整闭环。

二

全国普通高校与成人高校数据可视化系统-背景

选题背景

现在大家都能感觉到,高等教育发展得越来越快,不管是普通高校还是成人高校,每年的招生规模和院校调整都在变。这就导致关于学校分布、办学层次的数据变得特别繁杂,数据量也是越来越大。以前我们想了解某个地区有多少大学,或者想对比一下本科专科的比例,往往得去翻阅厚厚的统计年鉴,或者去各个网站东拼西凑,既费时间又容易出错。而且这些数据大多躺在表格里睡大觉,看着枯燥不说,很难直观感受到教育资源分布到底是个啥情况。对于教育管理者或者研究人员来说,面对这么多杂乱的数据,想要快速理清头绪、发现背后的规律,确实是一件挺让人头疼的事情,传统的处理方式显然已经有点跟不上节奏了。

选题意义

开发这个系统,其实就是想换个法子看数据,把那些干巴巴的数字变成直观的图表。这样一来,大家一眼就能看明白哪里的学校多,哪里的资源少,这对理解教育布局还是挺实用的。对于想考研或者找工作的同学来说,看看目标城市的学校分布,也能心里更有数。再说回毕设本身,用Spark来处理这些数据,本身就是一次很好的练手机会,能让自己熟悉大数据处理的那套流程,从数据清洗到分析再到展示,走完这一遍,对技术的理解肯定能深一层。虽然这只是一个毕设项目,能力有限做不到面面俱到,但起码能在一个小范围内把数据的价值挖出来,给需要的人提供一个看数据的便利窗口,这也就是做这个东西最大的初衷了。

三

全国普通高校与成人高校数据可视化系统-技术框架展示

开发语言:Python+Java

数据库:MySQL

系统架构:B/S

后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery大数据技术框架:Spark+Hadoop+Hive支持定制

四

全国普通高校与成人高校数据可视化系统-视频展示

已关注
关注
重播 分享 赞
大数据毕设太难?Spark高校数据可视化系统带你轻松入门

五

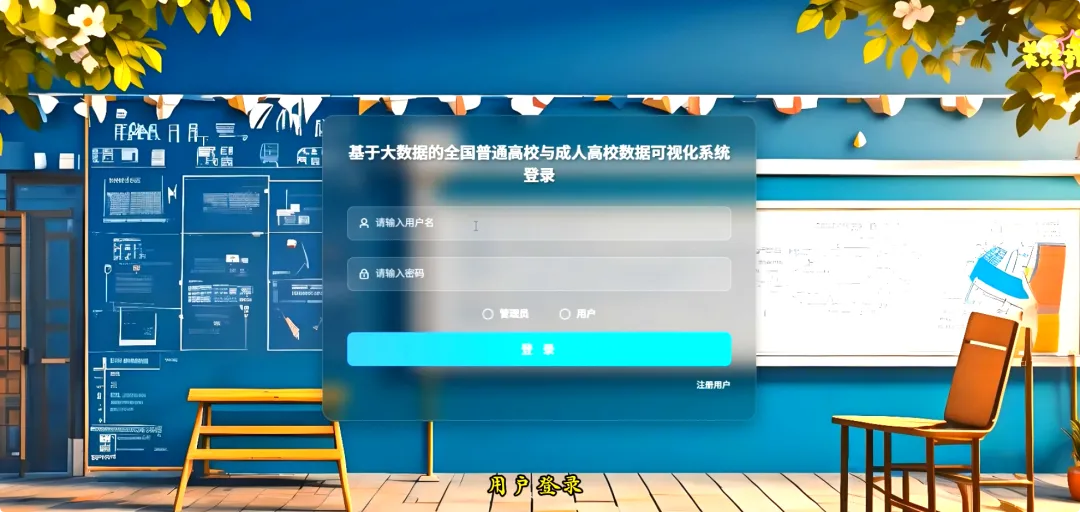
全国普通高校与成人高校数据可视化系统-图片展示

六

全国普通高校与成人高校数据可视化系统-代码展示

from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, count, descimport pandas as pddef get_spark_session():    spark = SparkSession.builder \        .appName("UniversityAnalysisSystem") \        .config("spark.some.config.option", "some-value") \        .getOrCreate()    return sparkdef process_province_rank_analysis(spark, df):    province_counts = df.groupBy("province").agg(count("*").alias("school_count"))    sorted_province_counts = province_counts.orderBy(desc("school_count"))    result_list = sorted_province_counts.collect()    json_data = []    for row in result_list:        province_name = row['province']        school_count = row['school_count']        json_data.append({"name": province_name, "value": school_count})    return json_datadef process_school_type_analysis(spark, df):    type_counts = df.groupBy("school_type").agg(count("*").alias("count"))    type_list = type_counts.collect()    data_map = {}    for row in type_list:        s_type = row['school_type']        s_count = row['count']        data_map[s_type] = s_count    total_count = df.count()    ratio_map = {}    for key, value in data_map.items():        ratio = round((value / total_count) * 100, 2)        ratio_map[key] = ratio    return {"counts": data_map, "ratios": ratio_map}def process_specific_field_analysis(spark, df, keyword):    filtered_df = df.filter(col("school_name").contains(keyword))    province_dist = filtered_df.groupBy("province").agg(count("*").alias("count"))    province_list = province_dist.collect()    province_data = []    for row in province_list:        province_data.append({"name": row['province'], "value": row['count']})    level_dist = filtered_df.groupBy("level").agg(count("*").alias("count"))    level_list = level_dist.collect()    level_data = {}    for row in level_list:        level_data[row['level']] = row['count']    final_result = {        "keyword": keyword,        "province_distribution": province_data,        "level_distribution": level_data    }    return final_result
联系我们

扫码关注

商务合作

       关注公众号:

 计算机毕设指导师

~~感谢你抽出时间来阅读此文~~

最新文章

随机文章