openai/human-eval: Code for the paper "Evaluating Large Language Models Trained on Code"
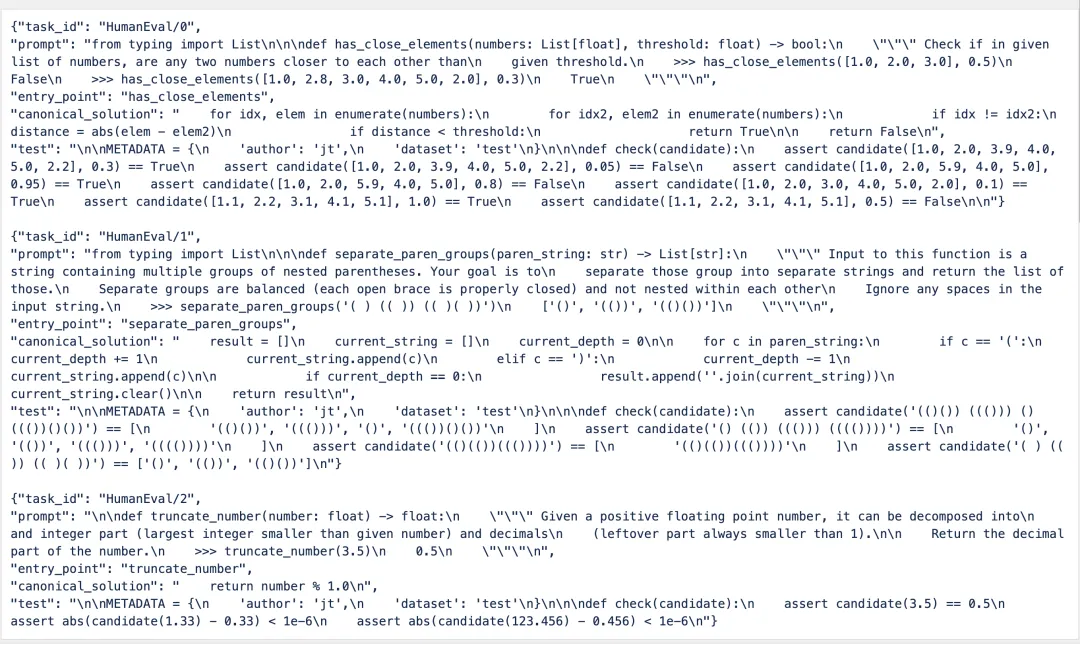
这是 OpenAI 发布的 HumanEval 数据集的标准数据格式。该数据集专门用于评估大语言模型(LLM)的 Python 代码生成能力,共包含 164 道独立编程题。每条数据都是一个 JSON 对象,下面逐字段为你详细解读:
🔑 字段含义解析
字段名 | 类型 | 含义说明 | 示例对应 |
|---|
task_id
| str
| 任务唯一标识符。格式为 HumanEval/{编号},用于索引、去重和结果统计。 | "HumanEval/0" 表示第 0 题
|
prompt
| str
| 输入给模型的代码提示。通常包含必要的 import、函数签名、类型注解以及详细的 docstring(功能描述+示例)。模型需要在此之后补全函数体。 | 以 def has_close_elements(...):\n """...""" 结尾,留白等待模型续写 |
entry_point
| str
| 待实现的函数名。评测脚本会动态提取模型生成的代码,并通过该名称调用函数执行测试。 | "has_close_elements"
|
canonical_solution
| str
| 官方标准答案(参考实现)。由数据集作者编写,用于验证题目逻辑是否严谨、测试用例是否合理。注意:实际评测时不会提供给模型。 | 双层循环计算距离并返回 True/False 的代码字符串 |
test
| str
| 自动化测试代码。通常包含一个 check(candidate) 函数,内部使用 assert 验证 candidate(即模型生成的函数)在多种输入下的输出是否符合预期。评测时会将模型生成的函数注入此环境运行。 | 包含 def check(candidate): assert candidate(...) == True ... 的 Python 代码字符串 |
🔄 这些数据在 LLM 评测中是如何工作的?
- 输入阶段1:将 prompt拼接后输入给大模型,要求模型“补全代码”。
- 生成阶段:模型输出完整的 Python 代码(通常包含函数体)。
- 提取阶段:根据 entry_point 找到模型生成的函数定义。
- 执行阶段:将 test 中的代码与模型函数一起放入沙箱环境运行。candidate参数会被替换为模型生成的函数。
- 评估阶段:如果所有 assert 均不抛出异常,则该题判为 Pass。最终统计 Pass@k(生成 k 个候选答案中至少有一个正确的概率)作为模型能力指标。
💡 使用时的注意事项
prompt 末尾通常带有缩进,是为了让模型直接续写函数体,避免重复定义。test 是字符串形式的 Python 代码,不是直接可执行的字典或列表。实际评测框架会将其 exec() 到安全环境中。canonical_solution 仅用于数据集质量控制或训练阶段作为参考,绝不参与零样本/少样本评测。- 部分题目 docstring 中的
>>> 示例是 Python doctest 风格,但 HumanEval 的正式评测仅依赖 test 字段,docstring 示例仅起提示作用。
样例数据如下:
 局限性
现有基准局限 | 本文切入点 |
|---|
HumanEval/MBPP 等多为短小、自包含的算法题,测试用例仅关注输入输出匹配
| 真实软件工程任务需组合调用多样化函数/API(如数据处理、网络请求、可视化) |
提示多为简单函数签名+简短描述,缺乏复杂约束 | 实际开发需遵循复杂指令(含错误处理、特定输出格式、多步逻辑编排) |
测试覆盖浅,易产生“高分低能”错觉 | 构建长上下文、多工具链、严格分支覆盖的执行级基准 |
 10个月宝宝每天需要喝多少奶粉?