Linux 内核 ORC 解栈器原理介绍
- 2026-10-11 07:32:22
# 典型帧指针维护代码(启用了 -fno-omit-frame-pointer)func:push %rbp # 保存旧 RBPmov %rsp, %rbp # RBP = 当前栈指针sub $0x20, %rsp # 分配局部变量空间...leave # 相当于 mov %rbp, %rsp; pop %rbpret
基于 Frame Pointer 的解栈方式的优点是实现简单,逻辑非常直接,不依赖额外的调试信息,但是它的缺点也很明显。下面的表格是根据 Linux 内核文档总结出来的基于 Frame Pointer 的解栈方式的缺点。
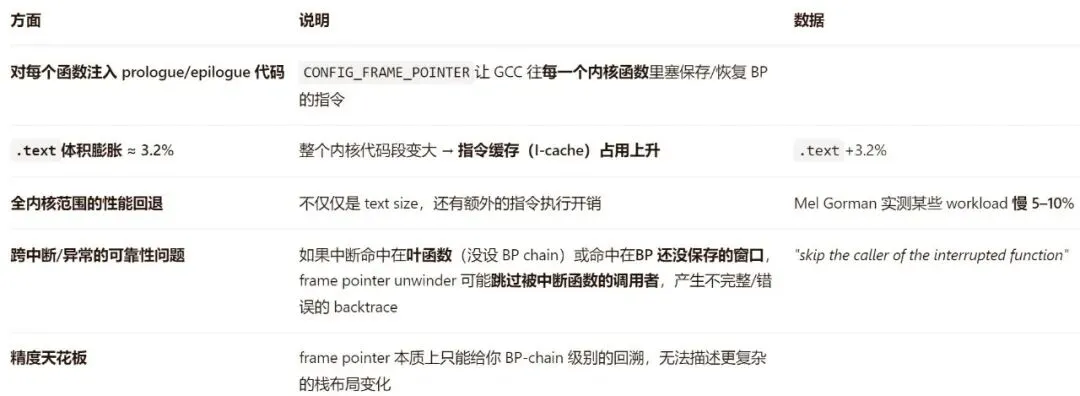
由于有上面这些缺陷,在 2017 年的时候,Linux 内核开发者 Josh Poimboeuf 在 x86 平台上引入了一种被称为 Oops Rewind Capability (ORC) 的解栈方式,这种方式不需要在每个函数调用时保存帧指针,形成链表,摆脱了对 Frame Pointer 的强依赖。目前在 x86_64 架构上,ORC 就是 Linux 内核的默认解栈器。
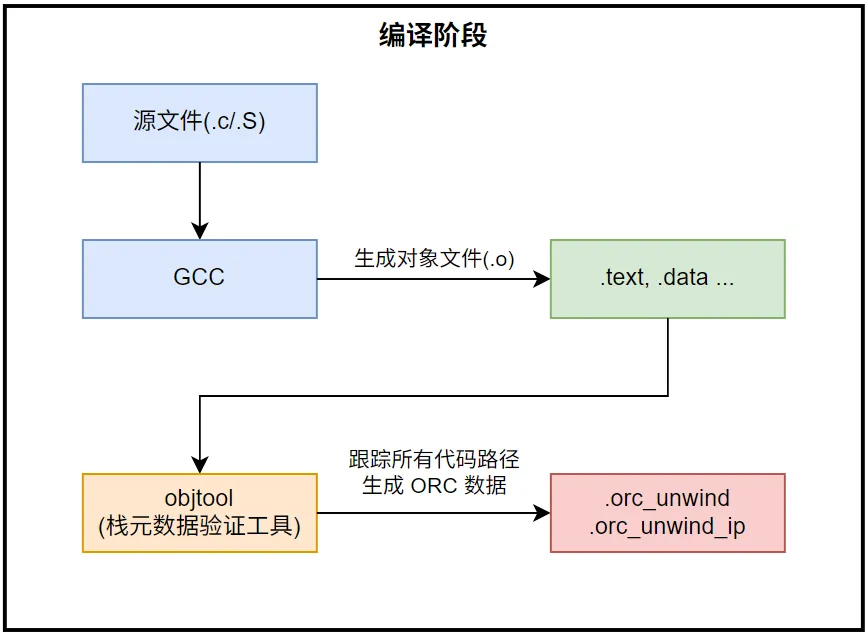
简单的说 ORC 的原理就是:在编译阶段用 objtool 把“每条指令位置对应的栈布局规则”抽出来做成一张只读查找表;运行时不解 Frame Pointer 链,而是拿着当前指令地址去查表,按表里记录的“栈指针偏移 / 有没有帧指针 / 是否进入异常栈”等信息,一步步把上一层栈帧和返回地址算出来,从而拼出完整调用链。ORC 只追踪两个关键寄存器:RSP(栈指针)和 RBP(帧指针),这对于 x86-64 Linux 调用约定足够用了。
下面我们分别从编译阶段和运行阶段来详细地说一说 ORC 的核心原理。
1. 编译时生成 ORC 数据
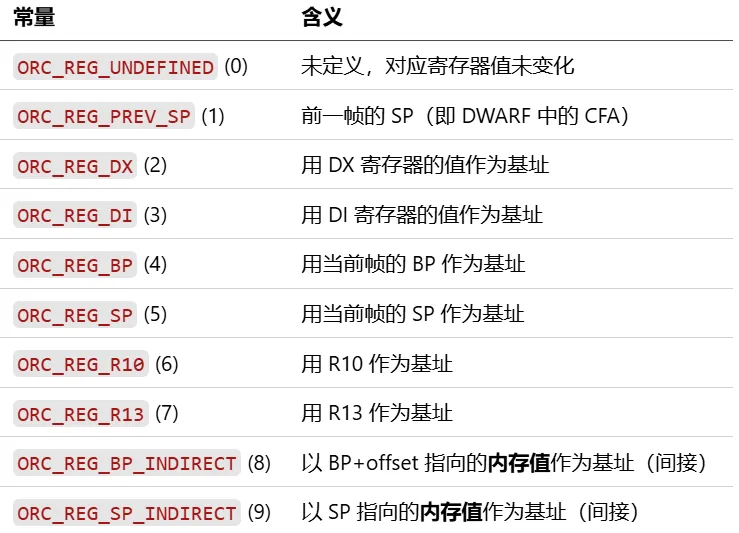
struct orc_entry {s16 sp_offset; // SP 的偏移量s16 bp_offset; // BP 的偏移量unsigned sp_reg:4; // 指定用于计算前一帧 SP 的基址寄存器unsigned bp_reg:4; // 指定用于计算前一帧 BP 的基址寄存器unsigned type:3; // 条目类型unsigned signal:1; // 是否为信号帧} __packed;
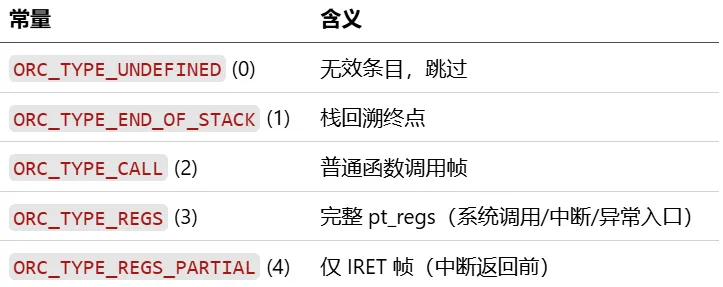
1.3 条目类型(type)
1.4 两张核心表
.orc_unwind_ip:int 数组,每个元素是相对于指令地址的偏移(*ip + ip = 实际指令地址),按 IP 排序。 .orc_unwind:struct orc_entry 数组,与上表一一对应。
对于普通 C 函数,objtool 无需任何提示就能全自动地跟踪栈变化。但对于系统调用、中断入口等"非标准"汇编代码,开发者需要通过 UNWIND_HINT 宏在汇编中插入提示信息。该宏(定义于 include/linux/objtool.h)在 .discard.unwind_hints 段中生成一个 struct unwind_hint:
struct unwind_hint {u32 ip; // 指令地址(相对偏移)s16 sp_offset; // SP 偏移u8 sp_reg; // SP 基址寄存器u8 type; // 提示类型u8 signal; // 是否信号帧};
例如,系统调用入口代码通常会标注:
UNWIND_HINT type=UNWIND_HINT_TYPE_REGS, sp_reg=ORC_REG_SP, sp_offset=offsetof(struct pt_regs, sp)1.5.2 阶段二:逐指令 CFI 状态跟踪
struct cfi_state {struct cfi_reg regs[CFI_NUM_REGS]; // 各寄存器的保存位置struct cfi_reg cfa; // CFA = 前一帧的 SPunsigned char type; // 帧类型(CALL/REGS/...)int stack_size; // 当前栈使用量bool signal; // 是否信号帧// ...};
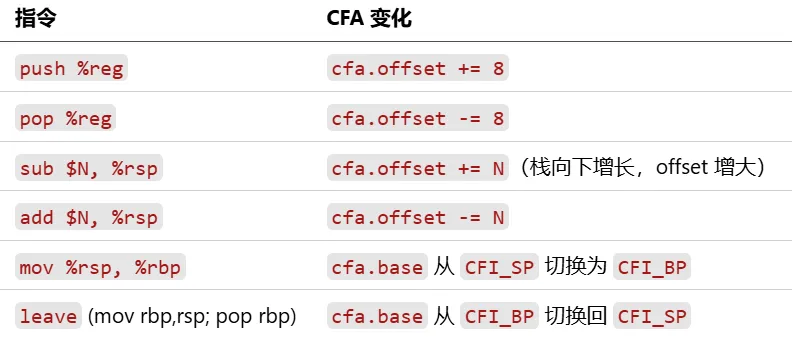
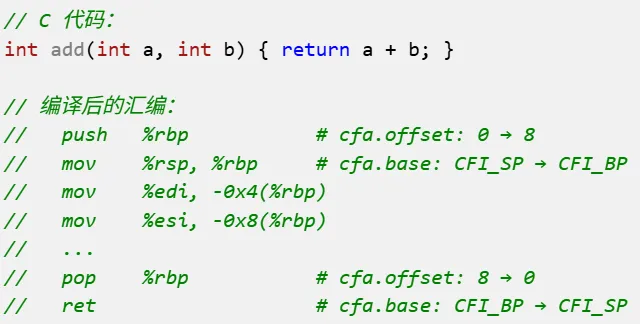
1.5.3 阶段三:CFI 状态 → ORC 条目转换
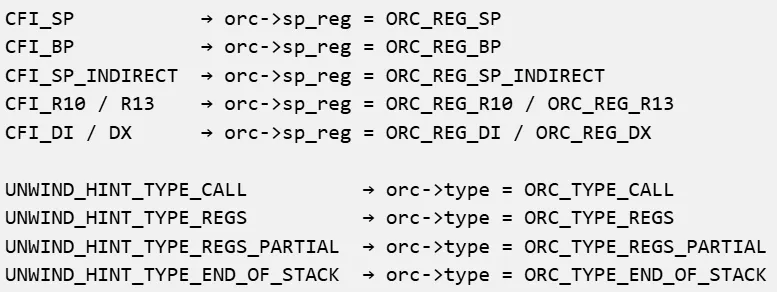
1.5.4 阶段四:sorttable 排序与查找表生成
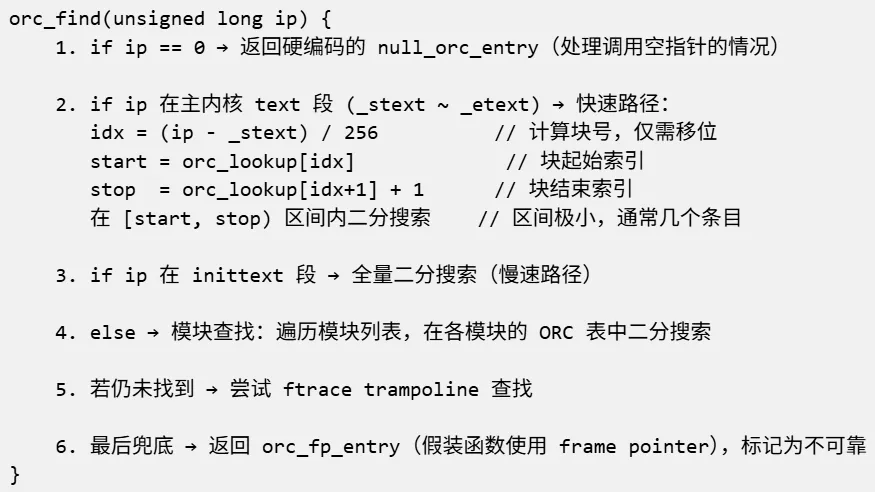
排序:以 orc_ip(指令的实际绝对地址 = base + offset)为 key,对 .orc_unwind_ip 和 .orc_unwind 进行并行升序排序。其中 ORC_TYPE_UNDEFINED 哨兵条目在相同 IP 时排在最前(以确保二分查找优先匹配真实条目)。 生成查找表 .orc_lookup:将内核 text 段(_stext 到 _etext)按 256 字节分块,为每个块预先计算其对应的 ORC 索引范围。这样做的好处是:运行时查 ORC 时,先用 IP 除以 256 得到块号,直接定位到 ORC 表的子区间,在这个极小的区间内做二分查找,大幅加速查找速度。
验证 .orc_unwind_ip 和 .orc_unwind 表的完整性(大小是否匹配、对齐是否正确)。 初始化 orc_lookup 数组:遍历每个 256 字节块,用二分查找定位到该块对应的 ORC 条目在 orc_table 中的起始索引,存储到 orc_lookup[i]。
2.2 ORC 查找:orc_find(ip)
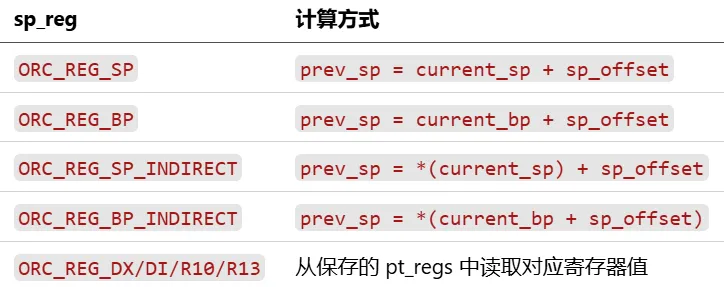
2.3 逐帧解栈:unwind_next_frame()
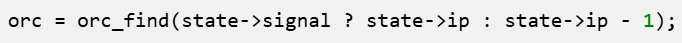
Step 2 — 计算前一帧的 SP
Step 3 — 根据条目类型读回 IP 和 SP
ORC_TYPE_CALL(普通函数调用):返回地址存于 sp - 8(栈顶),从该位置读取新 IP,SP 设为上一步算出的值。 ORC_TYPE_REGS(系统调用/中断/异常入口):SP 指向一个完整 pt_regs 结构体,从中读取 regs->ip 和 regs->sp,同时设置 state->regs 指针。 ORC_TYPE_REGS_PARTIAL(IRET 帧):SP 指向硬件中断返回栈帧(SS, RSP, RFLAGS, CS, RIP),偏移计算后读取 IP 和 SP。
Step 4 — 计算前一帧的 BP
根据 orc->bp_reg:
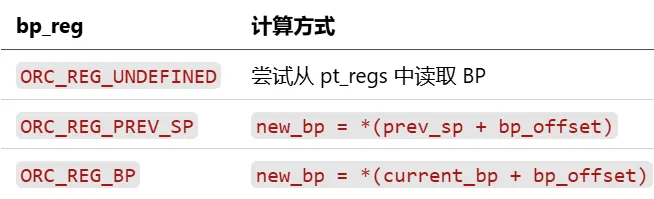
Step 5 — 安全校验
2.4 起始解栈:__unwind_start()
从 pt_regs 启动(如 panic 时):直接从 regs->ip/regs->sp/regs->bp 开始,且立即调用一次 unwind_next_frame() 跳过 regs 帧本身。 从当前任务启动(如 dump_stack()):通过内联汇编获取当前的 RIP、RSP、RBP。 从其他任务启动(如 /proc/<pid>/stack):从 task->thread.sp 指向的 inactive_task_frame 中读取保存的 IP、SP、BP。
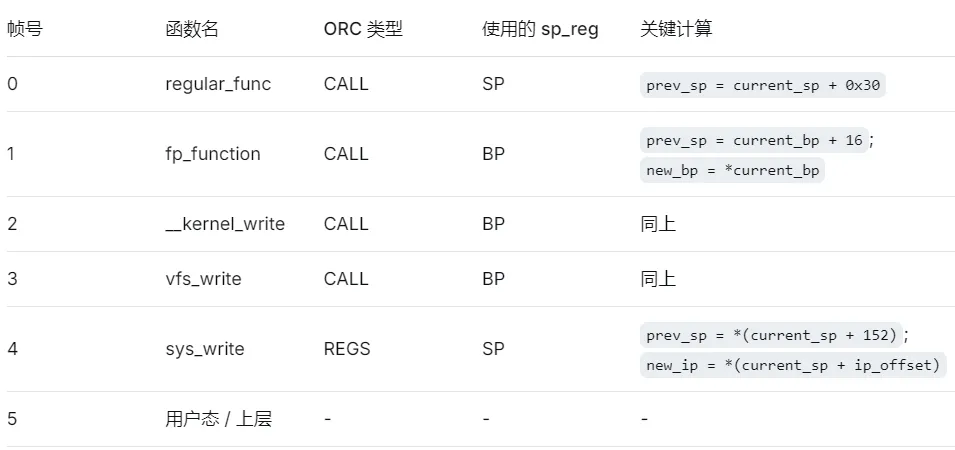
假设内核中有如下调用链(x86-64 架构):
sys_write() ← 系统调用入口,有 pt_regs→ vfs_write()→ __kernel_write()→ fp_function() ← 使用了 frame pointer 的函数→ regular_func() ← 普通 C 函数(无 frame pointer)
当前 CPU 正在执行 regular_func() 内部的某条指令时触发了 panic()。此时内核栈上已经保存了完整的调用链,且栈底(较高地址)处有一个 struct pt_regs,由系统调用入口代码在进入内核时压入。
panic 时的 CPU 寄存器状态(以 x86-64 为例):
RIP=regular_func内触发 panic 的指令地址RSP=regular_func当前栈指针(指向其栈帧内某个位置)RBP= 沿用fp_function的基址指针值(因为regular_func没有保存rbp)
内核栈布局(从高地址到低地址,即栈底 → 栈顶):
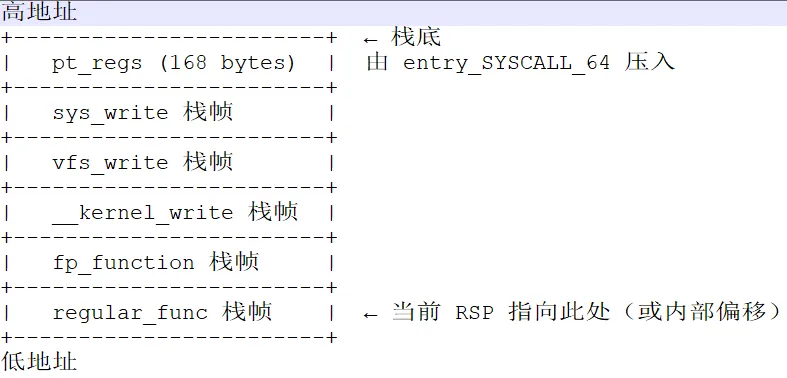
解栈过程从当前 RSP、RIP、RBP 开始,逐层向上(向高地址)回溯。
3.2 各函数的汇编与 ORC 信息
3.2.1 系统调用入口(汇编)
entry_SYSCALL_64:swapgsmovq %rsp, %gs:SCA_SP0...pushq %rax /* 保存 pt_regs->orig_rax */pushq %rbp /* 保存 pt_regs->bp */.../* 最终 rsp 指向 pt_regs 结构起始 */call do_syscall_64 /* 进入 C 代码,参数为 pt_regs 指针 */
orc_sys_write = {.type = ORC_TYPE_REGS,.sp_reg = ORC_REG_SP,.sp_offset = offsetof(struct pt_regs, sp), // 假设 152.bp_reg = ORC_REG_UNDEFINED,// 含义:当前 SP 指向 pt_regs,从 SP + 152 处读取调用者的 SP};
3.2.2 普通 C 函数(有 frame pointer):vfs_write、__kernel_write、fp_function
vfs_write:push %rbpmov %rsp, %rbpsub $0x30, %rsp # 分配 48 字节局部变量...call __kernel_write...leaveret
对于这类函数,ORC 条目(位于函数内任何 call 指令处,例如 call __kernel_write 对应的代码位置):
orc_normal_fp = {.type = ORC_TYPE_CALL,.sp_reg = ORC_REG_BP,.sp_offset = 16, // 调用者的 SP = 当前 BP + 16.bp_reg = ORC_REG_BP,.bp_offset = 0, // 调用者的 BP = 当前 BP 指向的内存值};
注:bp_offset = 0 表示 *(current_bp) 即为上一帧的 BP。这是 Linux 内核中更常见的写法。
3.2.3 无 frame pointer 的函数:regular_func
regular_func:sub $0x28, %rsp # 分配 40 字节局部变量...call some_other...add $0x28, %rspret
orc_regular = {.type = ORC_TYPE_CALL,.sp_reg = ORC_REG_SP,.sp_offset = 0x30, // 当前 SP + 0x30 = 调用者的 SP.bp_reg = ORC_REG_UNDEFINED, // 不保存 BP,沿用上一帧 BP};
3.3 详细解栈过程
struct unwind_state state = {.ip = RIP, // regular_func 内 panic 指令地址.sp = RSP, // regular_func 当前的栈指针.bp = RBP, // 来自 fp_function 的 BP 值.regs = NULL, // 没有 pt_regs 被直接关联};
注意:state.bp 此时保存的是 fp_function 的基址指针(因为 regular_func 从未修改过 rbp)。
帧 0(当前帧):regular_func 内部
目标:回溯到 regular_func 的调用者,即 fp_function。
获取 ORC:
orc = orc_find(state.ip - 1)。由于state.ip是 panic 指令地址,ip-1仍然落在regular_func的代码范围内,找到orc_regular。根据
orc_regular.type = ORC_TYPE_CALL:计算前一个栈帧的 SP:
prev_sp = state.sp + sp_offset=RSP + 0x30
此时RSP指向regular_func的栈帧内部(分配 0x28 后),RSP + 0x30正好指向regular_func的返回地址存储位置(即栈上保存的返回地址的地址)。读取返回地址:
new_ip = *(u64 *)(prev_sp - 8)prev_sp - 8就是返回地址所在的位置,读取得到fp_function中call regular_func的下一条指令地址。设置新的 SP:
new_sp = prev_sp设置新的 BP:因为
orc_regular.bp_reg = ORC_REG_UNDEFINED,所以new_bp = state.bp(保持不变,即fp_function的 BP)。更新
state:state.ip = new_ip,state.sp = new_sp,state.bp = new_bp。此时
state已经指向fp_function的栈帧(即regular_func的调用者)。
中间状态摘要(帧 0 → 帧 1 后):
ip=fp_function内call regular_func的下一条指令地址sp=fp_function栈帧的顶部(即返回地址存储位置 + 8,或者说调用者的 SP 值)bp= 仍然是fp_function的 BP 值(未变,但接下来会被覆盖)
帧 1:fp_function
目标:回溯到 fp_function 的调用者,即 __kernel_write。
获取 ORC:
orc = orc_find(state.ip - 1)。找到orc_normal_fp(因为fp_function有帧指针)。orc_normal_fp.type = ORC_TYPE_CALL,sp_reg = ORC_REG_BP,sp_offset = 16,bp_reg = ORC_REG_BP,bp_offset = 0。计算前一个 SP:
prev_sp = state.bp + 16。
注意:state.bp是fp_function的 BP 值(指向其栈帧内保存的上一帧 BP 的位置)。state.bp + 8指向返回地址,+16指向调用者的 SP 值(按照 x86-64 布局,调用者的 SP = 当前 BP + 16)。读取返回地址:
new_ip = *(u64 *)(prev_sp - 8) = *(state.bp + 8),即返回地址。读取上一帧的 BP:
new_bp = *(u64 *)(state.bp + 0)(因为bp_offset = 0),即从fp_function保存的 BP 位置读取值,那就是__kernel_write的 BP。更新
state:state.ip = new_ip,state.sp = prev_sp,state.bp = new_bp。
中间状态摘要:
ip=__kernel_write内call fp_function的下一条指令地址sp=__kernel_write的栈帧顶部bp=__kernel_write的 BP 值
帧 2:__kernel_write
回溯到 vfs_write。过程与帧 1 完全相同(__kernel_write 同样有帧指针,ORC 与 orc_normal_fp 相同)。
prev_sp = state.bp + 16new_ip = *(state.bp + 8)new_bp = *(state.bp + 0)更新
state,使其指向vfs_write的栈帧。
中间状态摘要:
ip=vfs_write内call __kernel_write的下一条指令地址sp=vfs_write的栈帧顶部bp=vfs_write的 BP 值
帧 3:vfs_write
回溯到 sys_write。同样使用 orc_normal_fp 逻辑。
prev_sp = state.bp + 16new_ip = *(state.bp + 8)new_bp = *(state.bp + 0)更新
state,指向sys_write的栈帧。
中间状态摘要:
ip=sys_write内call vfs_write的下一条指令地址sp=sys_write的栈帧顶部bp=sys_write的 BP 值
帧 4:sys_write
目标:回溯到 sys_write 的调用者。sys_write 本身可能没有自己的栈帧(或者它直接使用 pt_regs),根据 ORC 类型 REGS,我们需要从 pt_regs 结构中恢复调用者上下文。
获取 ORC:
orc = orc_find(state.ip - 1)。找到orc_sys_write。orc_sys_write.type = ORC_TYPE_REGS,sp_reg = ORC_REG_SP,sp_offset = 152(pt_regs.sp字段偏移)。因为
state.regs == NULL,但 ORC 类型为REGS暗示当前state.sp指向pt_regs结构的起始地址?这里需要明确:在sys_write函数执行时,rsp指向的是内核栈上的pt_regs结构吗?实际上,在do_syscall_64调用sys_write之前,栈顶就是pt_regs。sys_write被调用时,rsp并未改变(因为do_syscall_64没有分配额外栈帧),所以sys_write的第一条指令执行时,rsp仍然指向pt_regs的起始地址。因此state.sp此时就是pt_regs的地址。根据
REGS类型规则:从
state.sp + sp_offset处读取调用者的 SP:prev_sp = *(u64 *)(state.sp + 152)。pt_regs->sp字段保存的是进入内核前的用户栈指针。调用者的 IP 从
pt_regs->ip读取:new_ip = *(u64 *)(state.sp + offsetof(struct pt_regs, ip))(通常偏移 120 左右)。new_bp = *(u64 *)(state.sp + offsetof(struct pt_regs, bp))。new_sp = prev_sp(调用者的 SP)。此时回溯出了系统调用之前的上下文(可能是用户态,也可能是更早的内核态,取决于
pt_regs的内容)。通常这是用户态代码的地址,解栈过程可以结束,或者继续(若pt_regs的 CS 指示内核态,则可以继续回溯)。
最终状态:
ip= 用户态指令地址(或更早的内核函数地址)sp= 用户栈指针bp= 用户态 BP
帧 5(可选):如果继续回溯到用户态
由于用户态通常没有 ORC 信息(或者使用用户态的 unwinder),一般内核解栈到此停止。
零运行时开销:所有元数据在编译时生成,正常执行路径无额外指令。 空间效率极高:每条记录仅 8 字节,加上 IP 表 4 字节/条和查找表约原数据 5%,整体增量很小。 查找快速:两级查找(256 字节块索引 + 块内二分)使定位时间接近 O(1)。 覆盖全面:通过 UNWIND_HINT 机制,即使是手写汇编的 entry code 也能被正确建模。 与 FP 互补:ORC 不依赖 frame pointer,但可以在有/无 FP 的函数间无缝切换。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Skill 与 Python 项目的区别:Agent 接入层与业务核心层的边界
- Python办公自动化连载03:读取已有Excel表格数据,遍历所有行和单元格
- Python基础思维导图内容整理
- Python学习【170】:容器和虚拟机傻傻分不清?看完这篇文章你就懂了
- Rust 2026 全面爆发:Linux内核转正、CISA强推、字节阿里落地,重塑系统编程格局
- Linux SLUB 分配器深度拆解:malloc 背后内核在干什么?
- 万字长文!关于Python常用语法,一篇超详细的总结
- 逼自己学完这230页纸,你的Python就很了!
- 我用 Python 做了一个 OpenClaw 一键安装器
- 别再乱学Python了,新手照着这张路线图走就够了