用Python做科研级画图——误差分布图(直方图 + KDE + Bias 线)
- 2026-10-11 07:30:48
大家好,我是你们的小帅学长。
上一篇我们讲了真值 vs 预测(1:1线 + 指标框)。那张图解决的是一个非常直接的问题:模型预测值和真值,整体上贴得近不近?
但如果你真的想把模型讲清楚,仅有“贴得近”还不够。因为读者/审稿人还会继续追问:
误差主要集中在 0 附近吗?
模型是整体偏高还是偏低?
误差分布是对称的,还是偏态的?
有没有长尾?有没有极端误差?
这时候,最该补上的,就是今天这张图:误差分布图(直方图 + KDE + Bias 线)
这张图和上一篇的关系非常像一组搭档:
真值 vs 预测图:看模型整体一致性
误差分布图:看模型误差结构与偏差特征
如果说上一篇是在看“结果像不像”,那这一篇就是在看“模型到底偏在哪里,误差长什么样。”
01.误差分布图到底在看什么?
先把误差定义说清楚:
error = predicted – true简单来说:error > 0:模型高估
error < 0:模型低估
error = 0:预测刚好等于真值
把所有样本的误差汇总起来,我们就能看到一整个“误差分布”。
这张图最核心的观察点有 4 个:
中心位置:误差是不是围绕 0
分布宽度:误差波动大不大
偏态:高估和低估是否不对称
尾部:是否存在长尾或极端误差
02.为什么一定要加 KDE 曲线?
如果只画直方图,读者能看到“频数分布”,但有时不够平滑,尤其在 bin 选择不同的情况下,图形外观会有波动。加上 KDE(核密度估计)之后,读者/审稿人能更直观地看到,误差分布的整体形状。
它适合帮助你判断:是单峰还是多峰、是否偏态、中心是不是靠近 0、分布是否“胖尾”?
所以这张图里,直方图负责展示频数,KDE 负责展示形状。
03.Bias 线为什么重要?
Bias 的定义非常简单:
Bias = mean(predicted - true)也就是误差的平均值。
这条竖线的意义在于,它能一眼回答模型有没有系统性偏差?
Bias 线在 0 右侧 → 模型整体偏高
Bias 线在 0 左侧 → 模型整体偏低
Bias 线越靠近 0 → 系统偏差越小
所以这张图里最关键的两条“基准线”通常是:
0 线:理想无偏
Bias 线:真实平均偏差
04.一张好的误差分布图,应该包含什么?
如果你想把它画成“论文图”,我建议至少包含下面 5 个要素:误差直方图、KDE 平滑曲线、0 参考线、Bias 竖线、指标说明(可选:Bias、SD、RMSE)。
如果你再往上做一点“表达优化”,还可以让:0 线用黑色虚线、Bias 线用红色虚线、图内加一个简洁指标框。
这样读者/审稿人基本 3 秒就能抓住重点。
05.这张图最容易踩的 4 个坑
1)误差定义不统一
有的人写 pred - true,有的人写 true - pred。
结果正负方向完全反过来,解释也会颠倒。
所以你一定清楚:误差定义为 Predicted − True。
2)只画直方图,不画 0 线
没有 0 线,读者很难快速判断分布到底偏左还是偏右。
所以 0 线几乎是必须项。
3)KDE 太“漂亮”,但样本太少
当样本量小、分布不稳定时,KDE 可能画得很平滑,但不一定可靠。
这个时候要更依赖直方图本身,而不是过度解读 KDE 的细节起伏。
4)bin 乱设,导致图像失真
bin 太多会显得噪声过强,bin 太少又会掩盖结构。
你可以用上一篇讲的规则,比如 bins="fd",通常比较稳。
06.论文级 Python 示例代码
下面给你一份完整、可复用的模板:
import osimport numpy as npimport matplotlib as mplimport matplotlib.pyplot as pltimport seaborn as snsfrom matplotlib import font_manager as fmfrom matplotlib.ticker import MaxNLocatorfrom sklearn.metrics import mean_squared_error# =========================# 字体设置:英文 Times New Roman + 中文 SimSun# =========================win_fonts = r"C:\Windows\Fonts"for p in [os.path.join(win_fonts, "times.ttf"),os.path.join(win_fonts, "timesbd.ttf"),os.path.join(win_fonts, "timesi.ttf"),os.path.join(win_fonts, "simsun.ttc"),]:if os.path.exists(p):try:fm.fontManager.addfont(p)except Exception:passmpl.rcParams["font.family"] = ["Times New Roman", "SimSun"]mpl.rcParams["axes.unicode_minus"] = False# =========================# 输出路径# =========================OUT_DIR = r"D:\py_figs"os.makedirs(OUT_DIR, exist_ok=True)# =========================# 构造示例数据# =========================np.random.seed(42)y_true = np.random.uniform(280, 320, 600)y_pred = y_true + np.random.normal(0, 2.0, 600) + 0.35# 误差定义:predicted - trueerrors = y_pred - y_true# 指标bias = np.mean(errors)sd = np.std(errors, ddof=1)rmse = np.sqrt(mean_squared_error(y_true, y_pred))# =========================# 绘图# =========================fig, ax = plt.subplots(figsize=(6.2, 4.8))# 直方图sns.histplot(errors,bins="fd",stat="density",alpha=0.35,ax=ax)# KDEsns.kdeplot(errors,linewidth=2.0,ax=ax)# 0线(理想无偏)ax.axvline(0, color="black", linestyle="--", linewidth=1.4)# Bias线ax.axvline(bias, color="red", linestyle="--", linewidth=1.6)# 坐标轴与标题ax.set_title("Error Distribution / 误差分布", fontsize=14)ax.set_xlabel("Error = Predicted - True (K) / 误差", fontsize=12)ax.set_ylabel("Density / 密度", fontsize=12)ax.xaxis.set_major_locator(MaxNLocator(nbins=6))ax.yaxis.set_major_locator(MaxNLocator(nbins=6))# 指标框metrics_text = (f"Bias = {bias:.3f}\n"f"SD = {sd:.3f}\n"f"RMSE = {rmse:.3f}")ax.text(0.97, 0.95,metrics_text,transform=ax.transAxes,va="top",ha="right",fontsize=11,bbox=dict(boxstyle="round,pad=0.3", facecolor="white", edgecolor="black", alpha=0.9))# 边框优化for spine in ax.spines.values():spine.set_linewidth(1.2)# 保存out_path = os.path.join(OUT_DIR, "error_distribution_hist_kde_bias.jpg")fig.savefig(out_path, dpi=300, bbox_inches="tight", pad_inches=0.05)plt.close(fig)print("Saved:", out_path)
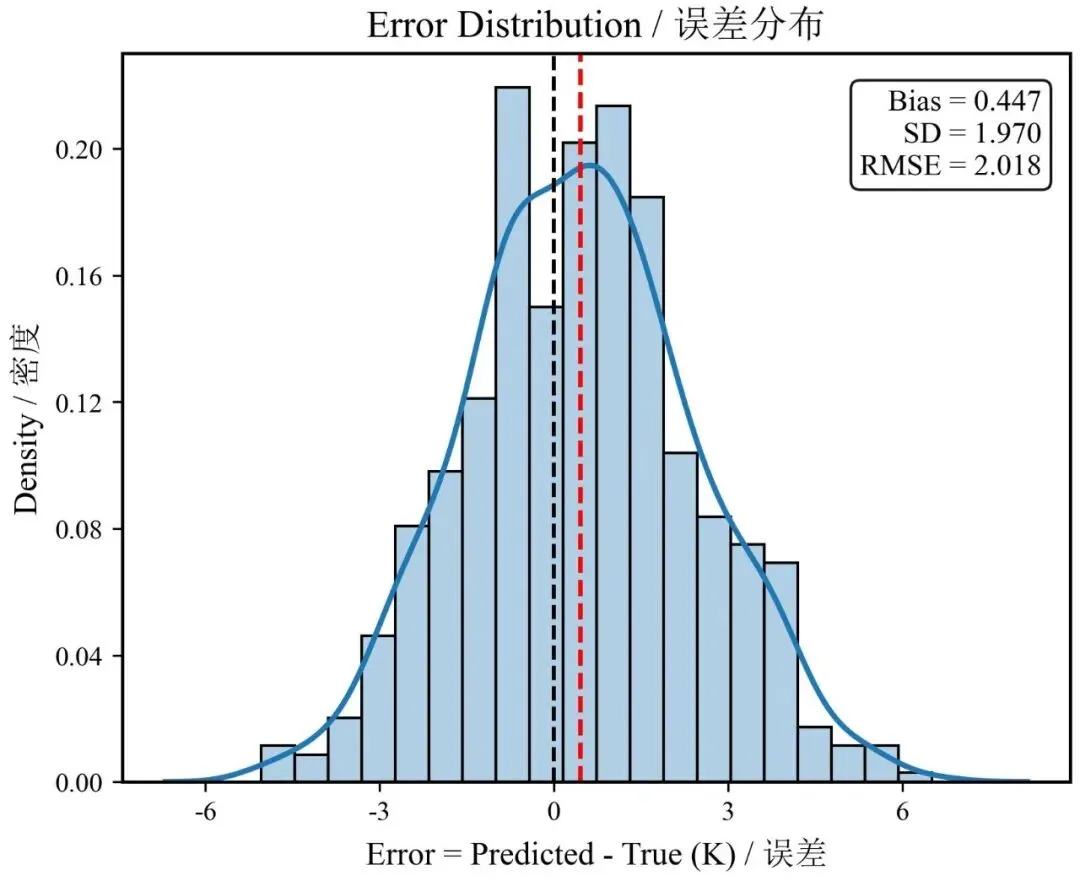
误差分布图的价值,不只是告诉你误差有多大,更重要的是告诉你误差“偏不偏、散不散、长什么样”——直方图负责频数,KDE 负责形状,Bias 线负责揭示系统偏差,这三者合在一起,才是一张完整的误差图。
下一篇我们继续往下走,进入更细一步的误差分析:《分组误差》。下一篇我会讲,当总体误差看起来不错时,是否可能在某些区间、某些类别、某些条件下“悄悄变差”——也就是说,不只看整体误差,还要看误差到底“坏”在什么地方。
——期待你的关注——
往期内容:
