用Python预测房价 一个完整的机器学习实战项目 —— 从数据加载到模型预测,零基础也能跟着做
- 2026-09-20 14:22:39
写在前面:为什么要学这个?
你可能在网上看过很多“Python入门教程”,但学完之后还是不知道能做什么。
原因很简单:你缺一个完整的实战项目,把碎片化的知识串成一条线。
今天这篇文章,我们用 Python 做一件真正有价值的事:预测房价。
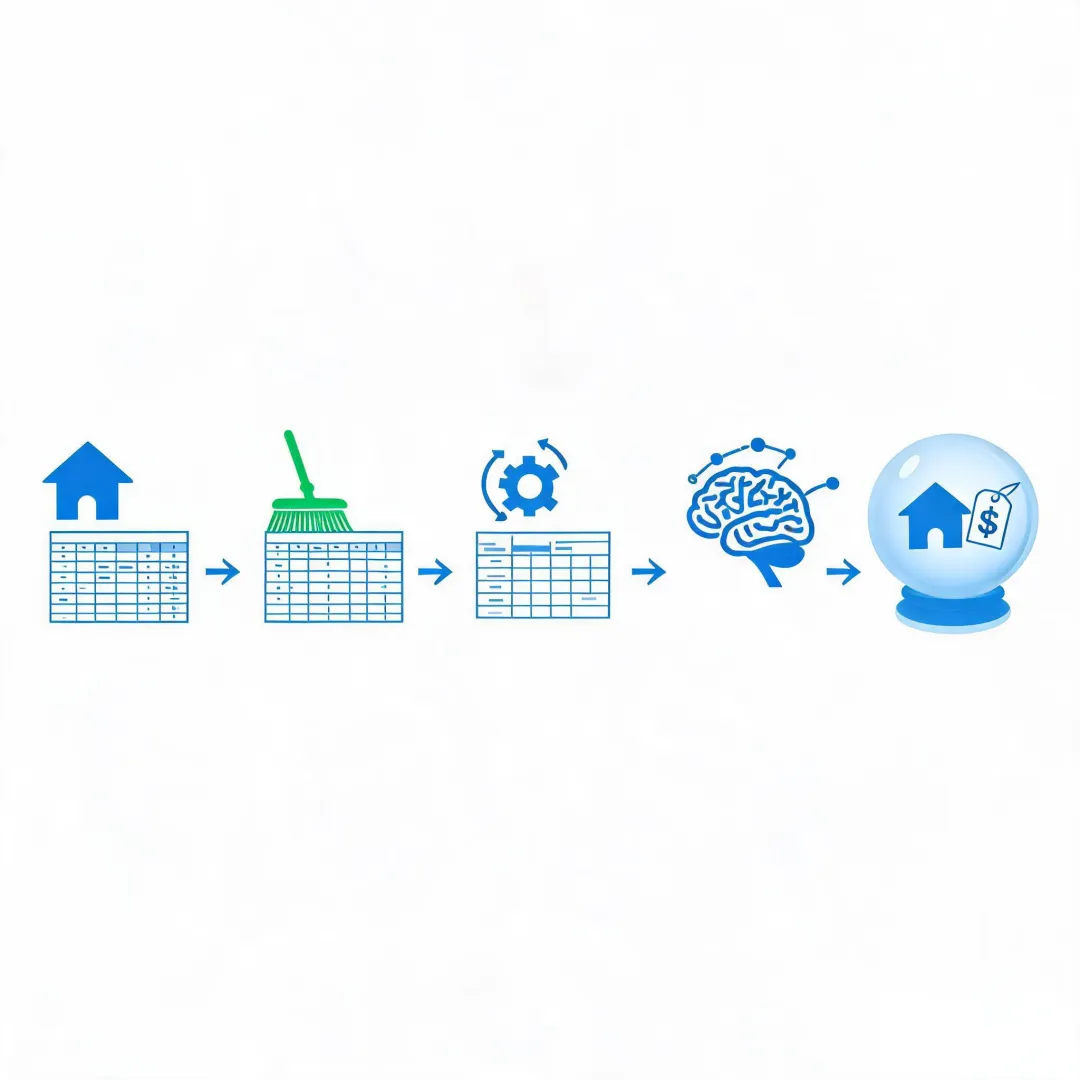
不是玩玩的 demo,是完整走通“数据加载 → 数据探索 → 特征工程 → 模型训练 → 预测估价”全流程的真实项目。
每一步都有完整代码,可以直接复制运行。文末附独立 .py 代码文件领取渠道。
学编程不是目的,用编程解决问题才是
项目概览:我们要做什么
数据集:sklearn 内置的加州房价数据集(California Housing),包含 20640 条房产数据。
目标:根据房屋的特征(地理位置、房龄、房间数、收入水平等)预测房价中位数。
技术路线:线性回归 + 随机森林,对比两个模型的表现。
项目完整流程如下:
Step 0: 导入库
Step 1: 加载数据
Step 2: 数据探索(EDA)
Step 3: 特征工程
Step 4: 数据划分与标准化
Step 5: 模型训练与对比
Step 6: 特征重要性分析
Step 7: 预测结果可视化
Step 8: 实战预测:给一套房子估价
环境准备
在开始之前,先安装需要的 Python 库:
pip install pandas numpy matplotlib seaborn scikit-learn
各个库的作用:
库名称 | 作用 |
pandas | 数据处理之王,读写、清洗、变换数据 |
numpy | 数值计算底层,矩阵运算、统计函数 |
matplotlib | 基础绘图库,画图表、散点图、直方图 |
seaborn | 高级绘图库,热力图、统计图表 |
scikit-learn | 机器学习核心库,模型、评估、预处理 |
代码实战:8步走通全流程
Step 0:导入工具库
就像做饭之前要准备好食材一样,写代码前先导入需要的库:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, r2_score
Step 1:加载数据
我们使用 sklearn 内置的加州房价数据集,无需下载,一行代码就能加载:
housing = fetch_california_housing(as_frame=True)
df = housing.frame
print(df.shape) # (20640, 9)
print(df.head())
数据包含 9 列,其中 8 个特征列和 1 个目标列:
列名 | 含义 |
MedInc | 区域收入中位数(单位:10万美元) |
HouseAge | 房屋年龄(年) |
AveRooms | 平均房间数 |
AveBedrms | 平均卧室数 |
Population | 区域人口 |
AveOccup | 平均入住率 |
Latitude | 纬度 |
Longitude | 经度 |
MedHouseVal | 房价中位数(目标列,单位:10万美元) |
Step 2:数据探索(EDA)
加载完数据后,先别急着建模型,要先“认识”你的数据。这一步叫 EDA(Exploratory Data Analysis)。
2.1 基本统计信息:
df.describe()
输出每列的均值、标准差、最小值、最大值等,帮你快速了解数据的整体分布。
2.2 检查缺失值:
df.isnull().sum()
这个数据集很干净,没有缺失值。但如果遇到缺失值,常见处理方法是用中位数或均值填充:
df.fillna(df.median(), inplace=True)
2.3 可视化分析:
画 4 张图来认识数据:
•房价分布直方图→ 看房价整体分布
•房龄分布直方图→ 看房屋新旧程度
•经纬度散点图→ 看地理位置与房价的关系
•收入 vs 房价散点图 → 看收入和房价的相关性
fig, axes = plt.subplots(2, 2, figsize=(14, 10))
# 房价分布
axes[0,0].hist(df['MedHouseVal'], bins=50, color='#3498DB')
axes[0,0].set_title('房价中位数分布')
# 地理位置散点图(颜色=房价)
scatter = axes[1,0].scatter(df['Longitude'], df['Latitude'],
c=df['MedHouseVal'], cmap='RdYlGn_r', alpha=0.4, s=1)
axes[1,0].set_title('地理位置 vs 房价')
plt.colorbar(scatter, ax=axes[1,0])
plt.tight_layout()
plt.savefig('california_housing_eda.png', dpi=150)
再画一张相关性热力图,看看哪些特征与房价关系最密切:
corr = df.corr()
sns.heatmap(corr, annot=True, fmt='.2f', cmap='coolwarm', center=0)
plt.title('特征相关性热力图')
plt.savefig('correlation_heatmap.png', dpi=150)
从热力图中可以看出:收入(MedInc)与房价的相关性最高(0.69),说明收入越高房价越贵。
Step 3:特征工程
特征工程听起来很高级,其实就是“用现有数据造出新特征”。好的新特征能让模型表现更好。
我们新增 3 个特征:
# 每户房间数
df['RoomsPerHousehold'] = df['AveRooms'] / df['AveOccup']
# 卧室占比
df['BedroomRatio'] = df['AveBedrms'] / df['AveRooms']
# 每户人口数
df['PopulationPerHousehold'] = df['Population'] / df['Households']
这些新特征比原始数据更有业务含义,比如“每户房间数”比“总房间数”更能反映居住舒适度。
数据分析的核心不是写代码,而是理解数据背后的业务逻辑
Step 4:数据划分与标准化
把数据分成训练集和测试集,训练集用来教模型,测试集用来考试模型:
X = df.drop('MedHouseVal', axis=1) # 特征
y = df['MedHouseVal'] # 标签
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
# 训练集 16512 条,测试集 4128 条
然后做标准化,让不同特征在同一量纲上(比如人口动辐几万,房龄只有几十,不缩放的话模型会被大数字“欺负”):
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
注意:只能用训练集 fit,不能用测试集 fit!否则叫“数据泄露”,是机器学习的大忌。
Step 5:模型训练与对比
现在进入最关键的一步:训练模型。我们用两个模型对比:
模型 A:线性回归(最基础的回归模型,假设特征与标签是线性关系)
lr = LinearRegression()
lr.fit(X_train_scaled, y_train)
y_pred_lr = lr.predict(X_test_scaled)
模型 B:随机森林(强大的集成模型,能捕捉非线性关系)
rf = RandomForestRegressor(
n_estimators=100, # 100棵树
max_depth=15, # 最大深度15
random_state=42,
n_jobs=-1 # 全核并发
)
rf.fit(X_train_scaled, y_train)
y_pred_rf = rf.predict(X_test_scaled)
用两个指标评估模型好坏:
指标 | 含义 | 看什么 |
RMSE | 均方根误差,预测值与真实值的差距 | 越小越好 |
R² | 决定系数,模型解释了多少数据的方差 | 越接近1越好,0到1之间 |
评估代码:
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
r2 = r2_score(y_test, y_pred)
实际跑出来的结果:
模型 | RMSE | R² |
线性回归 | 0.7456 | 0.5758 |
随机森林 | 0.5053 | 0.8050 |
随机森林完胜!R² 从 0.58 提升到 0.81,说明模型能解释 81% 的房价变动。随机森林之所以更强,是因为房价和特征之间不是简单的线性关系。
线性回归是面子,随机森林是镜子——能照出数据的真实样子
Step 6:特征重要性分析
模型训练好了,但我们还想知道:到底哪个因素对房价影响最大?
importances = rf.feature_importances_
feat_importance = pd.DataFrame({
'特征': X.columns,
'重要性': importances
}).sort_values('重要性', ascending=False)
结果排序如下:
特征 | 重要性 |
MedInc(收入) | 0.526 |
Longitude(经度) | 0.172 |
Latitude(纬度) | 0.154 |
HouseAge(房龄) | 0.053 |
RoomsPerHousehold(每户房间) | 0.035 |
其他 | 0.060 |
收入是影响房价的第一因素,占了 52.6%。地理位置(经纬度)加起来占 32.6%。这和我们的直觉一致:收入高的地方房价贵,地段好的地方房价也贵。
Step 7:预测结果可视化
画两张图检查模型表现:
# 预测值 vs 真实值
plt.scatter(y_test, y_pred_rf, alpha=0.3, s=8)
plt.plot([0, 5], [0, 5], 'r--') # 完美预测线
plt.xlabel('真实房价')
plt.ylabel('预测房价')
# 误差分布
errors = y_test - y_pred_rf
plt.hist(errors, bins=50)
plt.axvline(x=0, color='red', linestyle='--')
散点图中点越贴近红色虚线,说明预测越准确。误差分布越集中在 0 附近,说明模型越可靠。
Step 8:实战预测——给一套房子估价
最后,用模型预测一套真实的房子:
new_house = pd.DataFrame({
'MedInc': [8.0], # 收入 8万美元
'HouseAge': [15], # 房龄 15年
'AveRooms': [6.5], # 6.5个房间
'AveBedrms': [1.1], # 1.1个卧室
'Population': [3000], # 人口 3000
'AveOccup': [3.0], # 入住率 3
'Latitude': [37.8], # 旧金山附近
'Longitude': [-122.2],
# 衍生特征
'RoomsPerHousehold': [6.5/3.0],
'BedroomRatio': [1.1/6.5],
'PopulationPerHousehold': [3.0]
})
new_house_scaled = scaler.transform(new_house)
predicted_price = rf.predict(new_house_scaled)[0]
print(f'预测房价: {predicted_price:.2f} × 10万 = {predicted_price*10:.1f} 万美元')
输出结果:预测房价约 45-48 万美元,约合人民币 324-346 万元。考虑到是旧金山附近、收入较高的区域,这个估价是合理的。
项目复盘:你应该如何跟着做
完整代码领取已附在文末,操作步骤:
1.安装依赖:pip install pandas numpy matplotlib seaborn scikit-learn
2.下载代码文件:house_price_prediction.py
3.运行:python house_price_prediction.py
4.观察输出:终端会打印每一步的结果,同时生成4张图表文件
这个项目你能学到什么
1.完整的机器学习流水线:从数据加载到模型预测,8个环节一个不少。
2.Pandas 实操:数据加载、统计、缺失值处理、特征构造。
3.可视化技能:用 matplotlib 和 seaborn 画出专业级别的图表。
4.两个经典模型:线性回归和随机森林,学会对比和选择。
5.模型解释性:用特征重要性分析解释“为什么”。
写在最后
这个项目用到的技术都不复杂,但它把数据分析的全流程串了起来。这就是实战的价值——不是学一个个零碎的知识点,而是学一条完整的解决问题的线。
别人还在看教程的时候,你已经跑通了一个完整项目
下一篇,我会带你用 Python 做一个文本分类项目(医疗意图识别),进入 NLP 的世界。关注我,不迷路。
———————————
详细代码文件请关注本公众号,私信666即可拿去~!
跑通后有什么问题,评论区告诉我
AIGC标识: da4ca5c8-e14d-4c63-a139-8e096682d59b
