Python五大核心容器:AI模型训练、Agent开发必备底层基本功
- 2026-10-11 06:10:06
Python五大核心容器:AI模型训练、Agent开发必备底层基本功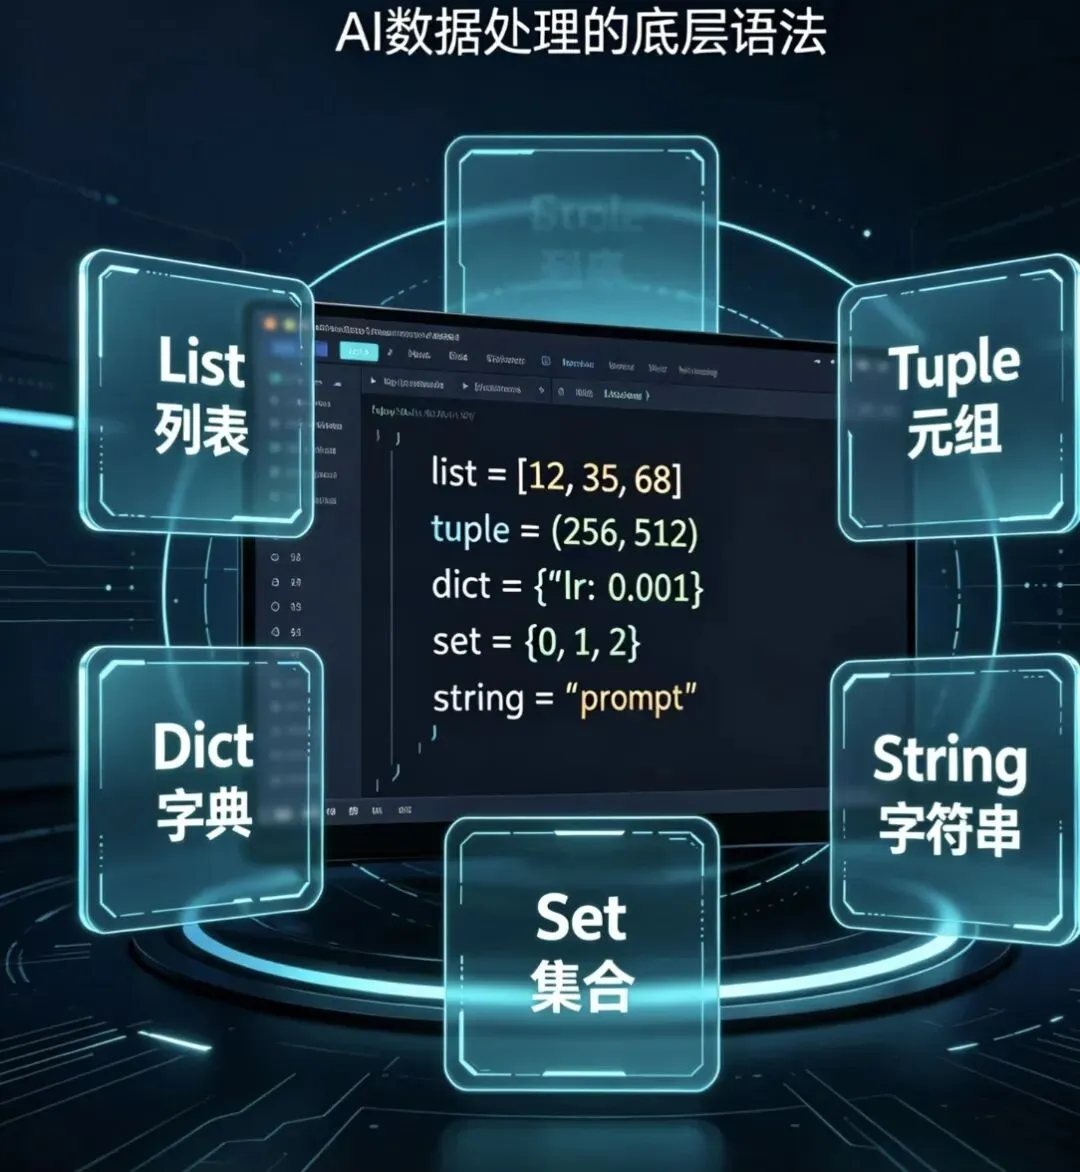 大家好,我是数行天下。做AI开发、模型训练、大模型Agent落地,Python容器数据结构是所有代码的底层基石。很多人跑不通模型、数据预处理报错、Agent记忆逻辑混乱、超参数配置出错,根源都是没吃透五大核心容器的特性和适用场景。
Python 90%的AI业务代码:数据清洗、数据集存储、模型参数配置、Prompt交互、Agent记忆读写、特征工程,全部依赖 List、Tuple、Dict、Set、String 这五大核心容器。 
今天这篇干货,摒弃零基础冗余讲解,完全贴合AI实战场景,从核心特性、专属用途、可直接复用代码、优缺点、避坑要点全方位拆解,彻底打通AI开发底层逻辑。 核心定义:可变、有序、可重复、可嵌套,Python最灵活的通用容器,是AI数据预处理、样本存储的第一常用结构。 核心语法: [] 定义,支持增、删、改、查所有操作,长度和内容可随时动态修改。 代码示例: ✅ 优势:灵活万能、支持嵌套、动态增删改、适配绝大多数数据场景 ❌ 劣势:底层是线性存储,海量数据查询速度慢,不适合千万级数据集检索 ⚠️ 避坑:AI大数据训练中,批量数据尽量用List暂存,最终转Numpy/张量提速 核心定义:不可变、有序、可重复、可嵌套,专门用于存储禁止修改的核心固定参数,是保障模型训练稳定性的关键结构。 核心语法: () 定义,数据初始化后无法增删改,仅支持查询读取。 代码示例: ✅ 优势:数据安全不可篡改、占用内存更小、读取速度优于列表 ❌ 劣势:无修改能力,仅适用于固定参数场景 ⚠️ 避坑:所有模型静态配置参数优先用元组,杜绝训练中参数异常变动导致崩模 核心定义:可变、无序(3.7+有序)、键唯一、键值映射存储,是大模型开发、Agent记忆、超参数配置、数据标签映射的核心结构,没有字典就没有现代化AI工程。 核心语法: {key:value} 键值对存储,通过唯一key精准匹配value,支持动态增删改。 代码示例 ✅ 优势:精准键值匹配、查询速度极致快、结构化极强,适配所有配置类场景 ❌ 劣势:内存占用略高,key必须唯一且不可变(List不能做key) ⚠️ 避坑:Agent记忆读写、模型配置更新,优先用字典,结构清晰且易于解析 核心定义:可变、无序、元素唯一、不可重复,核心能力只有一个:自动去重+快速成员判断,是AI数据集预处理、冗余数据剔除的专用容器。 核心语法: set() 定义,自动过滤重复数据,支持交集、并集、差集运算。 代码示例: ✅ 优势:去重效率极高、集合运算便捷、成员判断速度远超列表 ❌ 劣势:无序、不支持索引、无法存储重复数据、不能嵌套可变元素 ⚠️ 避坑:仅用于数据清洗、去重、筛选,绝对不要用来存储有序训练数据 核心定义:不可变、有序字符序列,是大模型所有交互、文本AI任务的唯一原生载体,所有LLM对话、文本数据集、Prompt工程、模型输出解析都基于字符串实现。 核心语法: "" / '' 定义,支持切片、拼接、正则匹配、格式化输出。 代码示例: ✅ 优势:大模型原生支持、适配所有文本交互、操作方法丰富、兼容性极强 ❌ 劣势:不可变,频繁拼接会产生内存冗余 ⚠️ 避坑:海量文本拼接优先用 join() ,杜绝频繁 + 拼接,提升代码效率
Python五大核心容器,看着是零基础基础,实则是所有AI工程落地的底层骨架。 模型跑不起来、数据预处理出错、Agent逻辑混乱、参数配置不规范,本质都是基础不牢。 真正的AI落地开发,不是只会调包、跑开源代码,而是吃透底层数据结构,精准选择最合适的容器承载对应业务数据,写出高效、稳定、可迭代的工程代码。 日拱一卒|功不唐捐 上海AI实验室&上交重磅研究:脑电大模型性能狂飙,但它真的看懂脑信号了吗? 智研类脑,调控神经:2026学术盛会落址大理,诚邀各界专家学者齐聚论道! PyTorch神经网络构建+训练优化全流程 脑解码新反常识:别急着堆模型,先问有没有对齐 欧盟人脑计划启示录 —— 反思 “大科学计划” 1D卷积网络模型如何做eeg时间序列分析?
大家好,我是数行天下。做AI开发、模型训练、大模型Agent落地,Python容器数据结构是所有代码的底层基石。很多人跑不通模型、数据预处理报错、Agent记忆逻辑混乱、超参数配置出错,根源都是没吃透五大核心容器的特性和适用场景。一、列表List:AI最万能的动态数据集容器
# 基础定义:存储普通序列数据train_epochs = [10, 20, 30, 40, 50]# AI核心场景:存储模型训练样本、特征数据#存储多张图像的像素特征向量img_features = [[0.21, 0.35, 0.89], [0.12, 0.77, 0.45], [0.91, 0.22, 0.33]]#动态修改:训练过程迭代更新参数train_epochs.append(60)#追加迭代轮次train_epochs.pop(0)#删除无效首轮数据
AI应用场景
存储批量训练样本、图像/文本特征向量、迭代参数序列; 数据集分批加载(Dataloader底层批量数据存储); 模型训练过程中动态记录loss、准确率等指标变化; 多组实验参数的遍历测试存储。
优缺点&避坑
二、元组 Tuple:AI模型的「只读固定参数容器」
#1. 基础定义:固定维度参数img_size = (256, 256)#图像宽高model_layers = (8, 16, 32, 64)#网络层级通道数#2. AI核心场景:模型初始化固定超参数#适配CNN、Transformer模型维度配置model_shape = (1, 512, 512, 3)#(batch, height, width, channel)#取值查询(唯一合法操作)print("模型输入维度:", model_shape)
AI应用场景
固定模型输入尺寸、网络层数、特征维度、卷积核大小; 冻结训练参数:防止模型微调、迁移学习中核心参数被意外篡改; 数据集固定划分比例、设备配置(CPU/GPU固定参数); 作为字典键、函数固定返回值(不可变特性适配高级语法)。
优缺点&避坑
三、字典 Dict:大模型&AI Agent的「核心中枢容器」
#1. 基础定义:键值映射存储model_config = {"model_name": "ViT", "lr": 1e-4, "batch_size": 16}#2. AI核心场景1:大模型Prompt参数配置(LLM通用写法)llm_params = {"prompt": "基于用户问题生成专业数据分析报告","temperature": 0.7,#随机性"top_p": 0.9,"max_tokens": 2048}#3. AI核心场景2:Agent短期记忆存储agent_memory = {"user_query": "脑机接口情绪识别模型优化","chat_history": ["初次提问:EEG数据集选型", "二次提问:模型精度提升"],"action": "检索相关论文+优化技术路线"}#4. 动态更新超参数llm_params["temperature"] = 0.5
AI应用场景
大模型超参数、推理参数、对话参数全局配置; AI Agent记忆存储、对话历史、任务状态、行为日志记录; 数据集标签映射(数字标签→文本标签)、分类任务映射关系; 模型训练日志、评估指标、实验结果结构化存储; 对接API接口、JSON数据解析(AI接口传输标准格式)。
优缺点&避坑
四、集合 Set:AI数据清洗的「专属去重工具」
#1. 基础去重:自动剔除重复元素raw_labels = [0, 1, 1, 2, 2, 3, 3, 3]unique_labels = set(raw_labels)print("去重后标签:", unique_labels)#{0,1,2,3}#2. AI核心场景1:数据集冗余样本清洗all_sample_ids = [101, 102, 103, 102, 104, 101]valid_sample = set(all_sample_ids)#剔除重复样本ID#3. AI核心场景2:特征交集筛选feature1 = set(["纹理特征", "色彩特征", "边缘特征"])feature2 = set(["边缘特征", "轮廓特征", "纹理特征"])common_feature = feature1 & feature2
提取通用特征
AI应用场景
训练数据集标签、样本ID、特征值去重,避免重复训练过拟合; 多组特征筛选、特征交集/差集对比,精简模型输入特征; 异常数据过滤、重复日志清洗、实验重复项剔除; 分类任务中统计唯一类别数量、校验数据集完整性。
优缺点&避坑
五、字符串 String:大模型交互的「原生核心载体」
#1. 基础定义base_prompt = "请专业、简洁地解答AI技术问题"#2. AI核心场景1:动态Prompt拼接(Prompt工程必备)user_question = "EEG情绪识别模型如何提升准确率?"full_prompt = f"{base_prompt} 问题:{user_question}"#3. AI核心场景2:模型输出解析、文本数据预处理model_output = "模型精度92.3%,召回率89.7%,损失值0.021"#字符串切片、匹配提取关键指标print("模型输出摘要:", model_output[:20])
AI应用场景
大模型Prompt编写、动态Prompt拼接、Few-shot提示词构建; 文本数据集存储、语音转文字、OCR识别结果承载; AI Agent交互话术、对话上下文、指令解析与输出渲染; 模型日志文本、实验报告、接口返回文本数据处理; 正则清洗文本噪声、过滤无效字符、标准化输入输出。
优缺点&避坑
六、五大容器AI场景对比
七、AI开发使用原则
动态数据用List,固定参数用Tuple,杜绝模型参数意外篡改; 所有AI配置、记忆、映射关系全部用Dict,结构化、易扩展、易解析; 数据预处理去重必用Set,是提升数据集质量、防止过拟合的关键; 所有大模型交互、文本任务底层全是String,Prompt工程本质是字符串处理; 海量数据优先放弃List/原生容器,结合Numpy、Tensor、Pandas提速。
总结
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 期刊图片复现|Python回归分析全流程深度解析-回归拟合图、SHAP特征重要性总览图、交互作用强度气泡图、单特征依赖图、双特征交互效应图
- AI + Python:财务人员的效率革命!
- Python应用之web开发
- 清朗学堂|C语言、Python教师专项答疑助力期末备考
- PHP中的多线程:展望未来
- BEC专栏 | 60天超越 Linux!这个叫 OpenClaw 的 AI Agent为何引爆全球?
- Python二阶第3课|return返回值!函数终极进阶,学会数据传出与运算复用
- 6款Python神级工具,把90%的重复活交给代码!工作效率起码翻几倍!
- 2026年Python高频面试八股文终极总结版.pdf
- Python数据分析:Pandas其实并不难,只需要看懂这几页