大家好,我是木木。
今天给大家分享一个高速 DataFrame的 Python 库,polars。
polars
polars 是一个用 Rust 实现、面向列式计算的 DataFrame 库。它在 Python 里提供表达式 API、LazyFrame 查询优化和较好的多线程执行能力,适合处理比普通脚本更重的本地分析任务。相比 pandas,Polars 的写法更强调表达式组合和惰性执行,刚开始需要一点习惯,但一旦进入批处理和特征加工流程,优势会很明显。
项目地址:https://github.com/pola-rs/polars
官方文档:https://docs.pola.rs/
三大特点
列式高速
底层列式内存和 Rust 引擎让聚合、过滤、选择列更有性能空间。
惰性优化
LazyFrame 会先构建查询计划,再统一优化和执行,适合复杂链路。
表达式清晰
with_columns、over、group_by 等表达式能把转换逻辑写得更集中。
最佳实践
安装方式:pip install polars。如果要读写云存储、数据库或更多格式,可以按项目需要补充对应依赖。
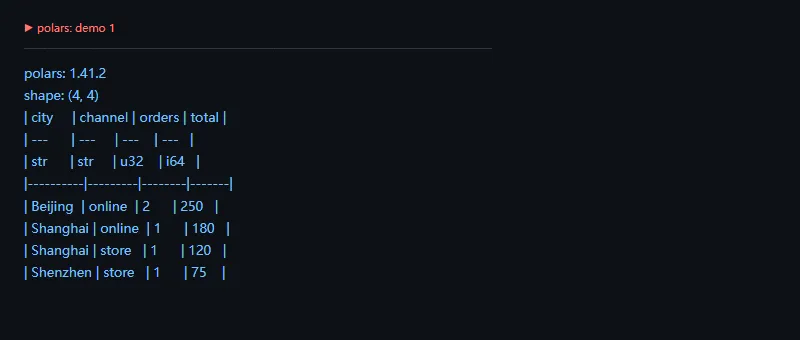
第一段代码解决的问题是:按城市和渠道聚合销售额,感受 Polars 的表达式式 group_by。
importpolarsasplpl.Config.set_tbl_formatting("ASCII_MARKDOWN")sales=pl.DataFrame({"city":["Shanghai","Beijing","Shanghai","Shenzhen","Beijing"],"channel":["store","online","online","store","online"],"amount":[120,90,180,75,160],})summary=(sales.group_by(["city","channel"]).agg(pl.len().alias("orders"),pl.col("amount").sum().alias("total")).sort(["city","channel"]))print("polars:",pl.__version__)print(summary)
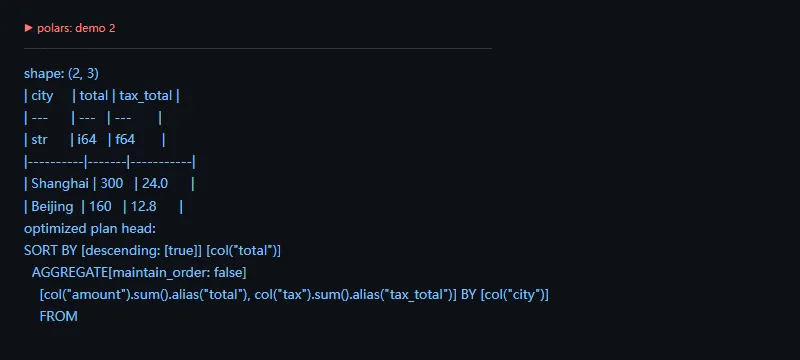
第二段代码解决的问题是:用 LazyFrame 把过滤、派生列、聚合和排序放进一个查询计划里。
importpolarsasplpl.Config.set_tbl_formatting("ASCII_MARKDOWN")sales=pl.DataFrame({"city":["Shanghai","Beijing","Shanghai","Shenzhen","Beijing"],"channel":["store","online","online","store","online"],"amount":[120,90,180,75,160],})lazy_result=(sales.lazy().filter(pl.col("amount")>=100).with_columns((pl.col("amount")*0.08).round(2).alias("tax")).group_by("city").agg(pl.col("amount").sum().alias("total"),pl.col("tax").sum().alias("tax_total")).sort("total",descending=True))print(lazy_result.collect())print("optimized plan head:")print("\n".join(lazy_result.explain(optimized=True).splitlines()[:4]))
环境与版本信息
本文示例使用 Python 3.11.0、polars 1.41.2。为了让 Windows 终端截图不出现边框乱码,示例设置了 ASCII 表格输出格式。
高级功能
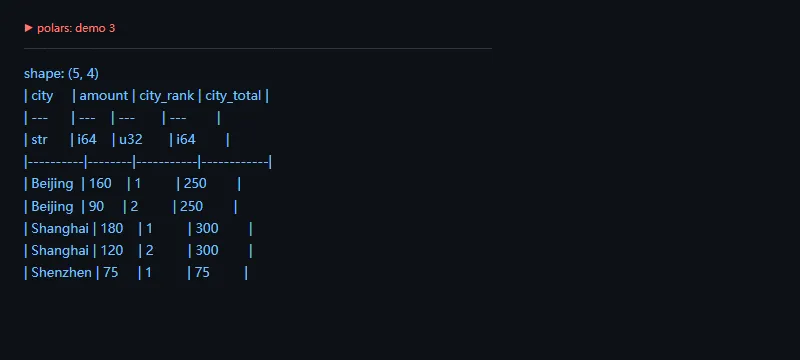
Polars 的进阶能力集中在表达式系统。很多时候你不需要写循环,只要把列运算、窗口统计和分组聚合组合起来,就能得到更稳定的执行计划。
importpolarsasplpl.Config.set_tbl_formatting("ASCII_MARKDOWN")sales=pl.DataFrame({"city":["Shanghai","Beijing","Shanghai","Shenzhen","Beijing"],"amount":[120,90,180,75,160],})ranked=sales.with_columns(pl.col("amount").rank("dense",descending=True).over("city").alias("city_rank"),pl.col("amount").sum().over("city").alias("city_total"),)print(ranked.sort(["city","city_rank"]))
适用场景
适合本地中大型 CSV/Parquet 分析、批处理特征工程、日志聚合、需要比 pandas 更高吞吐的单机任务。
不适用场景
不适合完全依赖 pandas 特殊 API 的旧代码,也不适合需要数据库事务、实时流处理或复杂分布式调度的场景。
上线检查
- 固定 Polars 版本并关注升级说明。2. 对 LazyFrame 的结果做回归测试。3. 控制 collect 的时机,避免中途把大数据全部拉回内存。4. 统一时间类型和字符串编码策略。
总结
polars 的关键不是“换个 DataFrame 名字”,而是用表达式和查询计划重新组织数据处理。适合对性能有感觉、也愿意调整写法的团队。
 10个月宝宝每天需要喝多少奶粉?