💡你离“被优化”,可能只差一个本地的 7B 模型
去年,你用 C# 调 OpenAI API 写业务,觉得自己站在了技术前沿。
今年,你发现同事用 Python 在本地跑 Llama 3,成本是你1/10,速度是你的3倍,还不用操心数据出境。
技术的代差,往往始于“工具链”的颠覆。 当整个行业从“云端调用”转向“本地部署”时,.NET 开发者,你的武器库更新了吗?
今天要介绍的,不是一个普通的库,而是一个让 .NET 技术栈,重新拿回“大模型时代”入场券的战略级项目——LLamaSharp。
GitHub:SciSharp/LLamaSharp,当前约 3.6k stars,在 .NET/AI 圈子里属于近期上升非常明显的一个项目。它的 README 里直接有 “Star history” 入口,点进去可以看到 Star 增长曲线,近半年明显陡峭。
让你用写 CRUD 的熟悉感,在 .NET 环境里部署和运行 LLaMA、Llava 等主流大模型。
你熟悉的 .NET 技术 | 对应的大模型能力 | LLamaSharp 提供的集成 |
|---|
ASP.NET Core | 提供智能对话 API | 官方示例,直接跑在 Kestrel 上 |
WPF/WinForms | 本地智能客户端 | 官方 Demo,打造离线助手 |
Semantic Kernel | AI 工作流编排 | 官方深度集成,作为“推理引擎” |
Entity Framework | 存储对话历史 | 需要自己封装,但模式通用 |
所以,它不是让你从零造大模型,而是让你用最熟悉的 .NET 姿势,去“驾驶”大模型。
如果你符合以下任何一条,那么 LLamaSharp 不是“可选项”,而是“必选项”:
【数据牢笼型】:你的项目在政务、军工、金融内网。数据是生命线,GPT-4 再强也进不来。LLamaSharp 是你在“数据孤岛”里创造智能的唯一解。
【成本敏感型】:你的客服机器人每天处理10万次问答,调用 GPT-4 每月账单50万。用 LLamaSharp + 一张 A100,一次性投入,长期成本接近为零。
【体验失控型】:你受够了 OpenAI API 的偶尔抖动、速度延迟和审查规则。你需要对响应时间、内容风格有100%的控制权。本地部署,意味着“确定性”。
一个真实场景:某制造业内部的 ERP 系统,有几十万份非标件的 PDF 图纸。新员工想查一个老零件,以前要翻3天档案。现在,用 LLamaSharp + RAG,在系统里直接问,10秒出结果,还能标出图纸位置。这就是 AI 在“内网”的杀手级应用。
一、为什么是 LLamaSharp?
1. 站在 .NET 视角,它踩中了三个趋势
- 本地大模型热:从“只调 OpenAI 接口”变成“在本地跑 7B、14B 模型”,这是最近一年最明显的趋势之一。LLamaSharp 直接把 llama.cpp 的能力搬到 .NET,让 C# 开发者也能“本地推理”。
- 跨平台 & 高性能:基于 llama.cpp,CPU/GPU 推理效率高,支持 Windows / Linux / macOS,.NET 8+ / .NET Framework 都能玩。
- 生态集成友好:官方就集成了 Semantic Kernel、Kernel Memory 等,还给出 Blazor、WPF、ASP.NET Core 示例,对 .NET 开发者非常“接地气”。
2. Star 增长肉眼可见
打开 GitHub Star History 页面,可以看到整体曲线是从 2023 下半年开始抬头,到 2024–2025 这段时间明显加速。
- 近半年:曲线明显更陡,说明关注度在快速提升。 对于一个偏“基础设施”的 .NET 库来说,这种增长已经算是“出圈”了。
二、LLamaSharp 能做什么?
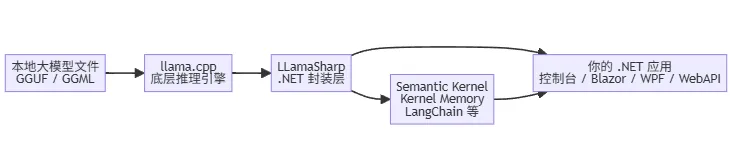
用一个简单架构图帮你看清它的定位:
你可以理解为:LLamaSharp = .NET 版的 llama.cpp SDK,把底层 C++ 接口暴露成 C# 友好的 API,并顺带做了和 SK、Kernel Memory 等的集成。 典型能力包括:
- 本地加载 LLaMA、LLaVA 等模型(GGUF/GGML);
- CPU / GPU 推理(依赖 llama.cpp 的硬件支持);
- 与 Semantic Kernel、Kernel Memory、LangChain 等集成示例。
三、适合什么场景?
1. 你想做一个“完全本地”的 AI 助手
典型场景:
- 想把“对话机器人”集成进现有 .NET 业务系统(ERP、OA、客服等)。 LLamaSharp 可以让你完全不用走外部 API,在本地跑一个 7B–14B 模型,再配合向量检索做 RAG。
2. 你想在现有 .NET 项目里加“AI 能力”
比如:
- 在 ASP.NET Core WebAPI 里暴露一个
/chat 接口,内部调用 LLamaSharp; - 在 Blazor / WPF 客户端里做一个本地聊天窗口;
- 在控制台工具里写一个“智能命令行助手”。 官方已经提供了:
3. 你想学习大模型推理工程
如果你打算深入理解:
- RAG 的基础流程(分片、嵌入、检索、生成)。 LLamaSharp 的代码量适中,又贴近底层 llama.cpp,是很好的“学习样本”。
四、从零开始跑一个本地 LLaMA 示例(.NET 8)
下面给你一个尽量“工程化”的步骤,方便你照着做 demo,也方便你将来往文章里放。
1. 环境准备
- 安装 .NET SDK 8.0+(官方 README 要求 .NET 8+)。
- 准备一个 GGUF 模型文件(比如 Llama-3–8B-Instruct 的量化版),放到某个固定目录,例如
E:\Models\Llama-3-8B-Instruct.Q4_K_M.gguf。 - 可以从 Hugging Face 下载,注意 README 里提醒:模型文件时间要和 LLamaSharp 版本对应。
2. 创建控制台项目
dotnet newconsole -n LlamaSharpDemocd LlamaSharpDemo
3. 引入 LLamaSharp 包
在项目文件里加(或用 dotnet add package):
<PackageReference Include="LLamaSharp" Version="0.8.0" /><PackageReference Include="LLamaSharp.Backend.Cpu" Version="0.8.0" />
实际版本号可以按 README 中“Map of LLamaSharp and llama.cpp versions”表来选。
4. 写一个简单的问答程序
Program.cs 示例(简化版):
using LLama;using LLama.Common;// 1. 模型参数var modelPath = @"E:\Models\Llama-3-8B-Instruct.Q4_K_M.gguf";var parameters = new ModelParams(modelPath){ ContextSize = 4096, // 上下文长度 GpuLayerCount = 0 // 0 表示纯 CPU};// 2. 加载模型using var model = LLamaWeights.LoadFromFile(parameters);using var context = model.CreateContext(parameters);var executor = new InteractiveExecutor(context);// 3. 构建聊天历史var history = new ChatHistory();history.AddMessage(AuthorRole.System, "你是一个乐于助人的 AI 助手,请用中文回答问题。");// 4. 聊天循环Console.WriteLine("LLamaSharp 问答示例(输入 exit 退出)");while (true){ Console.Write("你: "); var userInput = Console.ReadLine(); if (string.Equals(userInput, "exit", StringComparison.OrdinalIgnoreCase)) break; history.AddMessage(AuthorRole.User, userInput); var result = executor.InferAsync(history); Console.Write("AI: "); await foreach (var token in result) { Console.Write(token); } Console.WriteLine();}
实际 API 细节(命名空间、类名)以 README 和 API 文档为准。这里只是为了让你有一个直观印象。
5. 运行
dotnet run
如果你看到模型在加载条进度,然后能跟它对话,说明跑通了。
五、在实际项目中落地,要注意什么?
1. 模型选型与资源开销
- 7B 模型:纯 CPU 勉强能跑,体验一般,适合 demo / 开发调试;
- 14B+ 模型:强烈建议有 GPU(或 Apple Silicon);
- 注意内存占用:8-bit 量化已经能显著降低需求,但 8B 模型仍要数 GB 内存。 如果你的项目是:
- 桌面工具(WPF / WinForms):可以接受一定内存占用;
- WebAPI:要考虑并发时资源占用,建议做好队列和限流。
2. 会话管理 & 状态持久化
LLamaSharp 本身是“推理引擎”,不会帮你自动持久化会话。在真实项目中,你需要:
- 每次推理前,把历史拼成
ChatHistory 再传入; - 注意上下文长度限制(
ContextSize),必要时裁剪历史。
3. RAG:让模型“看”你的文档
LLamaSharp 官方集成了 Kernel Memory,本质上就是:
- 用户提问 → 检索相关片段 → 把片段塞进提示词 → 再调用推理。 你可以在 LLamaSharp 仓库里找到
LLama.KernelMemory 相关项目,照着示例做。
六、和其它方案对比,什么时候选 LLamaSharp?
简单对比一下常见方案:
- 想在现有架构里深度集成大模型; 那么 LLamaSharp 是一个非常自然的选择。
七、.NET 开发者的“本地大模型时代”
LLamaSharp 的流行,其实折射出一个趋势:.NET 开发者正在从“调用 API 的消费者”,变成“本地大模型的部署者和调优者”。 如果你一直觉得“大模型 = Python / JS / Go”,那 LLamaSharp 会打破这个印象——原来在 .NET 里,也能用相对少的代码,跑起一个像模像样的本地对话模型。
🚀 结尾:你的下一个项目,不应该只是“增删改查”
大模型不是未来,它正在成为现在的水和电。.NET 作为一个拥有庞大存量企业市场的平台,其与AI结合的最大机会,不在酷炫的AIGC,而在改造那些沉重、复杂、数据敏感的旧系统。
LLamaSharp 提供的就是这把钥匙。它不完美,但它是我们的钥匙。
💡 下一步行动建议:
本周:在你的开发机上,花20分钟跑通上面的5分钟Demo。建立体感。
下个月:找一个边缘业务(如内部知识库检索),做一个真正的 PoC。算清经济账。
今年:将本地模型能力,融入你的技术架构蓝图。构筑护城河。
时代在奖励那些用自己最擅长的工具,去解决最真实问题的人。
 10个月宝宝每天需要喝多少奶粉?