当把电子递交包的材料递交给监管机构的时候,一般要自己用官方提供的验证软件检查一下(本人未经历),看递交的材料是否符合要求,比如PDF的字体是否正确;或者看下有什么error。但是我感觉用python判断acrf上的注释 用的是什么字体,这种场景不常见,所以大家稍微了解一下就好了。首先需要知道CRF上的字体和注释的字体是不一样的,前者是DM在设计库的时候可能系统就设置好的,后者是我们按照一些指导原则使用的字体。所以DS提供了两个选项:会用到pdfminer.six 和PyMuPDF。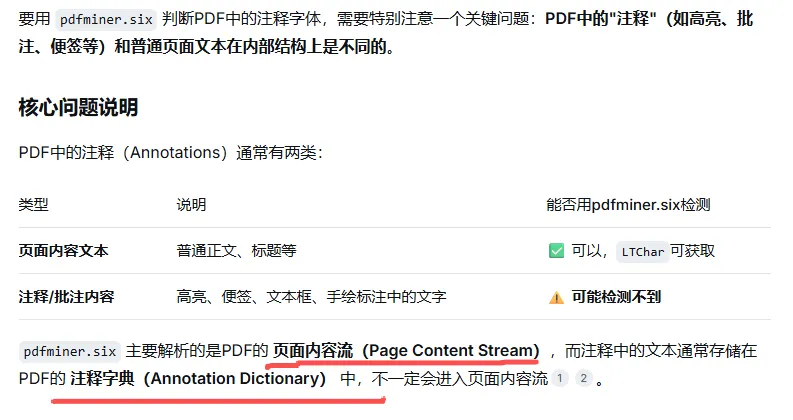
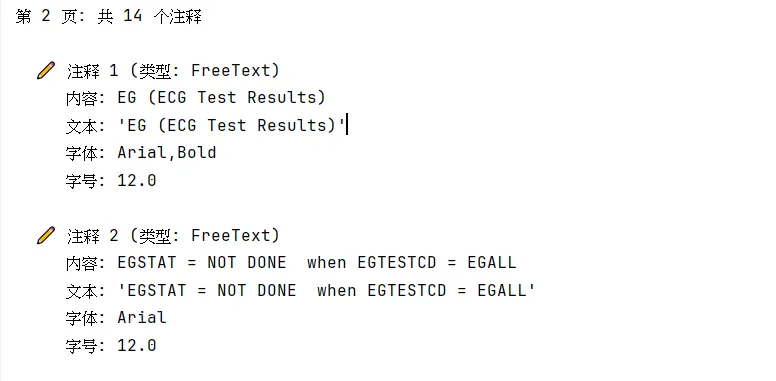
import fitz # PyMuPDFdef check_all_annotations(pdf_path): """ 检测PDF所有页面中的注释及其字体信息 """ doc = fitz.open(pdf_path) print(f"📄 PDF总页数: {len(doc)}") print("=" * 60) for page_num in range(len(doc)): page = doc[page_num] annotations = list(page.annots()) if page.annots() else [] print(f"\n第 {page_num + 1} 页: 共 {len(annotations)} 个注释") for i, annot in enumerate(annotations, 1): # 获取注释的info字典,content就包含在这里面 info = annot.info annot_type = annot.type[1] # 注释类型(如 FreeText, Highlight 等) print(f"\n ✏️ 注释 {i} (类型: {annot_type})") # 获取注释内容(存储在 info["content"] 中) if info.get("content"): print(f" 内容: {info['content']}") # 获取注释作者(如果有) if info.get("title"): print(f" 作者: {info['title']}") # 对于 FreeText 类型注释,使用 get_text() 提取文本及字体 if annot_type == "FreeText": text_dict = annot.get_text("dict") if text_dict: for block in text_dict.get("blocks", []): for line in block.get("lines", []): for span in line.get("spans", []): print(f" 文本: '{span['text']}'") print(f" 字体: {span['font']}") print(f" 字号: {span['size']}") if span.get("color"): print(f" 颜色: {span['color']}") # 对于其他类型(如 Highlight),可提取被高亮的文本(需要配合页面文字) elif annot_type == "Highlight": # 获取高亮区域坐标,然后从页面提取对应文本(稍复杂) # 简化版:直接提示无法直接提取 pass doc.close()check_all_annotations("XXX\\acrf.pdf")
运行程序后,输出的结果会显示该页有多少个注释,每个注释用的字体和大小是多少如果只是想看看CRF设计的时候,页面用了什么字体,可以告诉DS用下面这两个包解决from pdfminer.high_level import extract_pages
from pdfminer.layout import LTTextContainer, LTChar
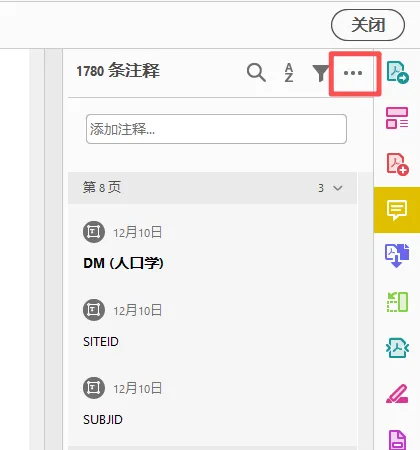
二:当我们在CRF上标注了注释之后,这些注释是可以导出为一个文件的,点击adobe acrobat reader红框里的3个小点,一个是“导出所有注释到数据文件”;一个是“导入数据文件”
“导出所有注释到数据文件”可以将注释导出成xfdf文件;
“导入数据文件”可以将xfdf文件导入到一个空白的CRF,比如DM改库,CRF有一些些改动,这时候肯定不是重新全部重头注释,而是将之前已经注释好的文件导出,然后稍微做调整,导入到最新的blank crf,能大大减少时间。
 10个月宝宝每天需要喝多少奶粉?