一些简单的Python脚本-实现某些分析效果-过程展示
- 2026-09-10 12:07:51
做模拟,做科研,不可避免要有许多计算分析,但作为上一个时代的人,用的办法都比较直给,借助的工具,从之前公号的内容就可以看出来,常用的是excel、origin这些,虽然会写一点简单C语言程序、shell脚本,但是毕竟要花时间写,现在应该已经是AI时代了吧,是可以借助一些编程语言,比如python之类的来完成一些计算分析。下面简单就这几天的python使用经验,展示一下不会python的人如何通过查阅AI来做一些简单的分析。有些操作并不是很聪明,且看就好。
不会Python,但也不是一点都不会啊,语法基本不懂,但是看到一些和C语言差不多的内容,还是大概可以明白其中逻辑的,只是大概可以明白,有些语法、命令看着还是陌生。所以这个就是初级的,查到写什么,怎么写,就怎么写,类似这样的,修改的较少。非常初级。
先说一个容易碰到的问题,线性拟合。
很多数据分析,需要线性拟合,以前可以放到excel中,或者orgin中,画散点图,点线性拟合,顺便拟合曲线的图都做出来了。类似这样
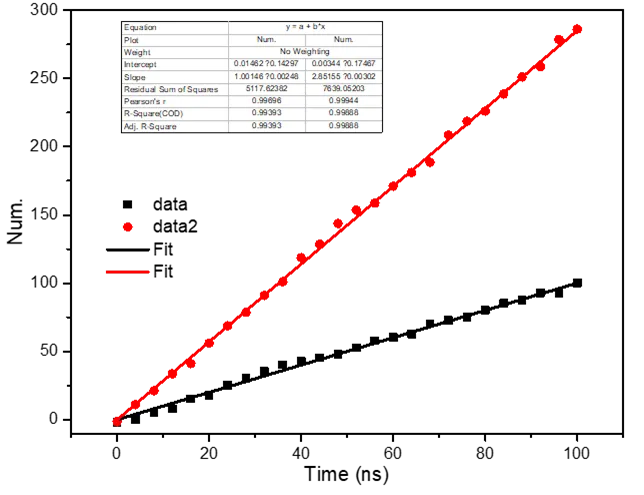
但是如果只是想要斜率的话,也可以导入到excel中,使用SLOPE函数,也很方便。这个只展示如何使用Python来做。
按照处理问题的具体情况,数据某两列的分别作为x、y,计算斜率,于是做了如下红字的搜索。
最小二乘法 回归直线方程,需要斜率和截距,数据文本以空格分隔,python实现,要求第一列为x,第4列为y
搜索结果,直接就有AI概览:
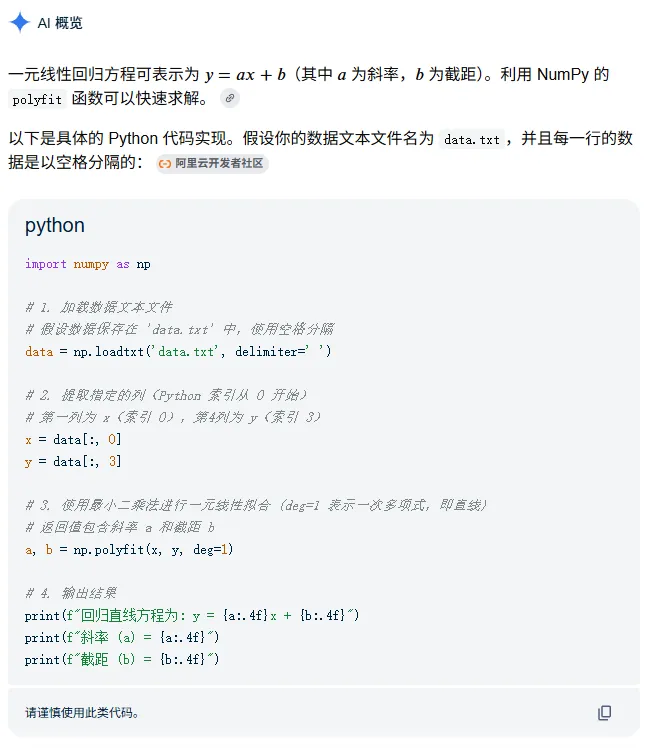
稍作修改:
import numpy as np# 1. 加载数据文本文件# 假设数据保存在 'data.txt' 中,使用空格分隔data = np.loadtxt('data.txt', delimiter=' ')# 2. 提取指定的列(Python 索引从 0 开始)# 第一列为 x(索引 0),第4列为 y(索引 3)x = data[:, 0]y = data[:, 3]y2 = data[:, 6]# 3. 使用最小二乘法进行一元线性拟合 (deg=1 表示一次多项式,即直线)# 返回值包含斜率 a 和截距 ba1, b1 = np.polyfit(x, y, deg=1)a2, b2 = np.polyfit(x, y2, deg=1)# 4. 输出结果# print(f"回归直线方程为: y = {a1:.4f}x + {b1:.4f}")# print(f"斜率 = {(a1+a2)*5:.4f}")# print(f"截距 = {b1:.4f}")print(f"{(a1+a2)*5:.4f}")
修改之后,可以实现第一列作为x轴,第4列、第7列分别作为y轴,分析斜率,二者平均值的10倍是结果。这样的修改应该不难吧。
还有AI给了这么一个脚本。
import numpy as npdef calculate_linear_regression(data_text):"""使用最小二乘法计算回归直线方程的斜率和截距:param data_text: 输入的数据文本,行与行之间用换行符,列与列之间用空格分隔:return: 斜率 k 和 截距 b"""x_list = []y_list = []# 逐行处理文本数据for line in data_text.strip().split('\n'):# 过滤掉可能存在的空行if not line.strip():continue# 按空格拆分每一行columns = line.split()# 提取第一列 (索引 0) 和第四列 (索引 3)# 注意:这里假设您的数据至少有 4 列,并且都是数值x_list.append(float(columns[0]))y_list.append(float(columns[3]))# 转换为 numpy 数组进行数学计算X = np.array(x_list)Y = np.array(y_list)# === 核心:最小二乘法公式计算 ===# 斜率 k = Cov(X, Y) / Var(X)n = len(X)mean_x = np.mean(X)mean_y = np.mean(Y)# 分子: sum((x - mean_x) * (y - mean_y))numerator = np.sum((X - mean_x) * (Y - mean_y))# 分母: sum((x - mean_x)^2)denominator = np.sum((X - mean_x) ** 2)k = numerator / denominatorb = mean_y - k * mean_xreturn k, b# --- 测试数据 ---# 每一行代表一组数据,以空格分隔,第一列为 x,第四列为 ymock_data = """1.0 99 99 2.12.0 99 99 3.93.0 99 99 6.14.0 99 99 8.05.0 99 99 10.2"""# 运行计算slope, intercept = calculate_linear_regression(mock_data)# 输出结果print("--- 计算结果 ---")print(f"斜率 (k): {slope:.4f}")print(f"截距 (b): {intercept:.4f}")print(f"回归直线方程为: y = {slope:.4f}x + ({intercept:.4f})")
这个大概是对的,但是有点麻烦了,按照道理来说,应该有类似Matlab或者excel那种,写好的函数,自动就生成统计分析。再继续找:
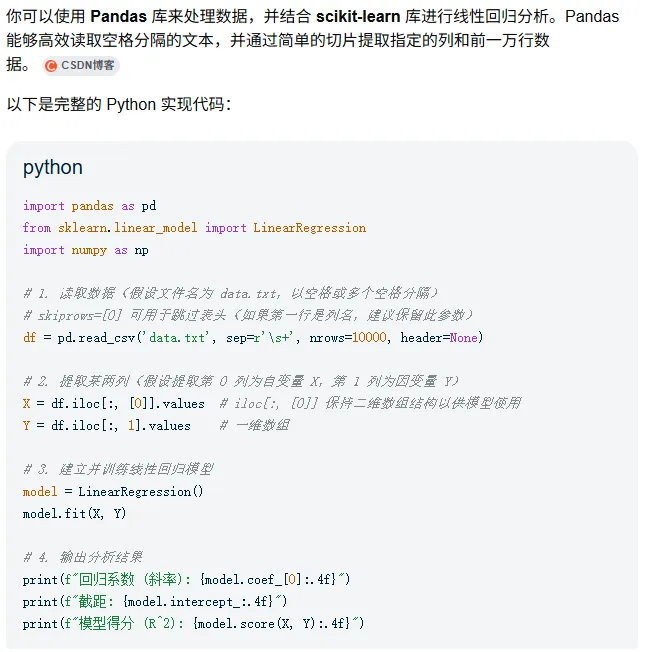
就是这个了,这个在前面介绍机器学习的时候,也写过(一次机器学习的尝试),当时介绍例子,后续慢慢得吃透。
稍微修改一下,最终的效果如下:
import pandas as pdfrom sklearn.linear_model import LinearRegressionimport numpy as np# 1. 读取数据(假设文件名为 data.txt,以空格或多个空格分隔)# skiprows=[0] 可用于跳过表头(如果第一行是列名,建议保留此参数)df = pd.read_csv('diffusion.txt', sep=r'\s+', nrows=101, header=None)# 2. 提取某两列(假设提取第 0 列为自变量 X,第 1 列为因变量 Y)X = df.iloc[:, [0]].values # iloc[:, [0]] 保持二维数组结构以供模型使用Y = df.iloc[:, 3].values # 一维数组# 3. 建立并训练线性回归模型model = LinearRegression()model.fit(X, Y)# 4. 输出分析结果print(f"回归系数 (斜率): {model.coef_[0]*10:.4f}")print(f"截距: {model.intercept_:.4f}")print(f"模型得分 (R^2): {model.score(X, Y):.4f}")
除了拟合,还有一类,比如计算能量,两个分子间的相互作用,不管使用gromacs软件 rerun + energy分析,还是自己编写程序硬算,如果是自己写C语言程序最好可以并行,至少应该使用fopenmp,这样才能快一些。得到的结果都是数据点,要统计平均值和标准差,这个用python也比较方便。
以前教学生都是导出数据到excel,利用average和stdev函数计算平均值和标准差。
依然是搜索,点开各种网页,查看教程,大概关于数字处理的,都可以使用numpy实现,不停的找就可以找到如下内容:
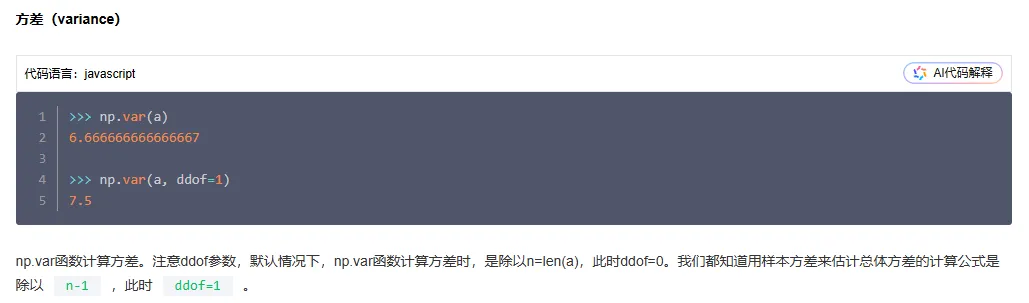
那功能实现就容易了。
import pandas as pdimport numpy as np# 1. 读取数据(假设文件名为 data.txt,以空格或多个空格分隔)# skiprows=[0] 可用于跳过表头(如果第一行是列名,建议保留此参数)df = pd.read_csv('pull1-2.4-5.log-1.6', sep=r'\s+', nrows=101, header=None)# 2. 提取某两列(假设提取第 0 列为自变量 X,第 1 列为因变量 Y)X = df.iloc[:, [1]].values # iloc[:, [0]] 保持二维数组结构以供模型使用Y = df.iloc[:, 2].values # 一维数组Z = X + Ya = np.average(Y)print(f"{np.mean(X)} +/- {np.std(X, ddof=1)} , {a} +/- {np.std(Y, ddof=1)} , {np.mean(Z)} +/- {np.std(Z, ddof=1)}")
这里不参考第一个脚本,用numpy直接读取,是因为在文本中不止有一个空格,用numpy会报错。当然格式还有csv,在前面(机器学习的尝试(2))也用过,当然可以用脚本生成。
这里介绍的这些,按某人的使用习惯,在服务器上直接生成结果,比较省事。也可以下载到本地,在本地部署python,在本地运行,都比较方便,科学解放生产力。
最后,补充说明下:
本文介绍的内容,更多的一种方法,通过搜索来实现一些辅助分析的手段。到具体问题上,学生理应比老师更清晰,在使用新工具,包括AI的一些工具会更熟练,更容易上手,获取知识的速度更快,实践碰到的障碍也更容易跨过,不存在固有偏见。就是新的CPU,眼神清澈,脑子也更灵活,希望可以做得更好一些。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 2025信息素养大赛Python小学组 (真题解析版)
- 找到了用Codex+Python做绘制图表的Skill
- Kali Linux 2026.2 更新重点:这次值得升级,但别忘了重启
- Ubuntu Linux发现并处理rust-coreutils的cp问题!
- Hannah Montana Linux 回归,但愿不只为了恶搞?!
- 在 Rocky Linux 10 上搭建本地 DNS 缓存解析器(Unbound 实战指南)
- 最新整理了108个Python实战项目,代码拿走即用,一起练起来吧!
- Mesop:基于Python的轻量级Web UI框架
- 论文图表总被打回?这篇Python数据可视化教程快来看!
- 期刊图片复现|Python绘制主坐标分析(PCoA)图