随着多组学(Multi-omics)研究的爆发式增长,研究人员测量的数据量已从几十种分析物飙升至成千上万种 。如何从如此高维、高噪声的数据中准确识别生物学亚型(Endotypes)和底层机制,成为了生信分析的重大挑战 。
日前,单聚类算法(Mono-cluster solutions)仍是主流,但其固有的算法假设和局限性极易对生物学结论产生误导 。为了解决这一痛点,Montana State University 的 Ronald K. June 团队在 bioRxiv 发表了名为ECCO: A Python UI for Performing Ensemble Clustering Combined with Cluster Optimization on Omics Data的预印本文章 。他们开发了一款名为 ECCO(组合聚类结合聚类优化)的开源 Python 软件,为大尺度组学数据提供了一个无需代码、快速且可扩展的组合聚类框架 。
一、 ECCO 的核心优势
组合聚类(Ensemble Clustering)通过整合多个聚类算法的结果,寻找能稳定聚类在一起的观测值,可显著缓解高维组学数据中的稀疏性和噪声问题 。然而,以往的组合聚类工具(如 diceR 和 clariconc)需要较强的编程能力,未能广泛普及 。
ECCO 带来了以下关键改进:
零代码操作:提供 Unix/Mac 和 Windows 的独立可执行程序,双击即可运行图形用户界面(UI)。
高度可定制:仅需修改一个 CSV 配置文件(Specification File),即可自由组合各种相异度指标、联动函数和内部评估指标 。
多核并行与可扩展性:基于 scipy 和 scikit-learn 构建,支持多线程加速,能随计算资源的增加展现出优异的扩展性 。
功能全套:内置 24 种功能,涵盖数据预处理、聚类性能评估及下游通路富集分析衔接 。
二、 核心图表与工作流详解
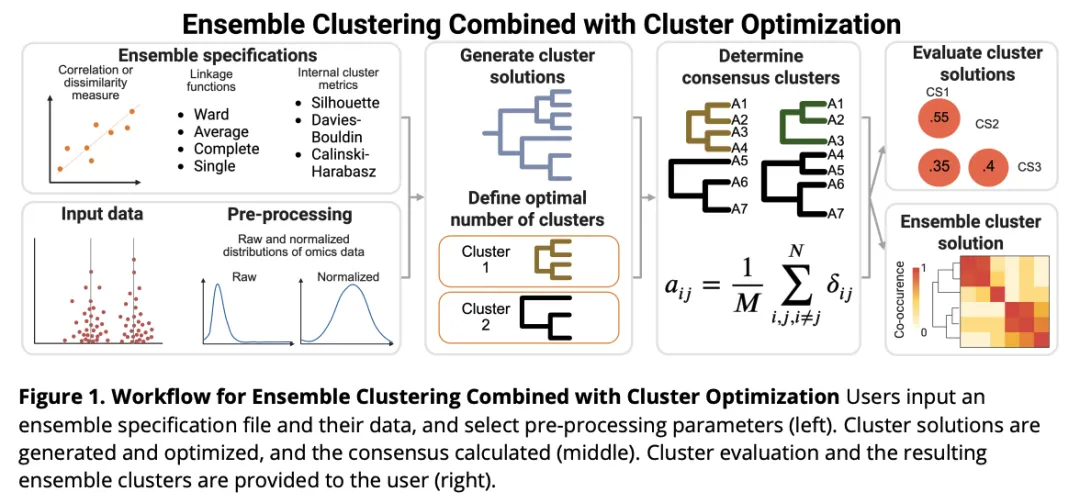
1. ECCO 整体工作流(Figure 1)
文章中的 Figure 1 详细展示了 ECCO 的四步法标准工作流(从左至右):
Ensemble specifications(组合聚类规范):用户上传一个 CSV 文件,自定义聚类参数 。支持多种相异度或相关性度量(如相关系数、欧氏距离等) ;支持 Ward、Average、Complete、Single 等联动函数(Linkage functions) ;支持三种内部聚类优化指标(轮廓系数 Silhouette、Davies-Bouldin 指标 DBI、Calinski-Harabasz 指标 CH) 。
Input data & Pre-processing(输入数据与预处理):支持连续、二值或计数数据输入 ,UI 内置了 log10 转换、Auto-scaling(Z-score 标准化)等常见分布调整功能 。
Generate cluster solutions:根据规范生成多个独立的凝聚层级聚类方案(M 个方案) 。
Define optimal number of clusters:自动根据内部指标的评估(例如让平均轮廓系数最接近 1,或使 DBI 最小),为每个单独的方案动态决定最佳的聚类数目($K$ 值) 。
Determine consensus clusters:采用投票共识(Voting Consensus)策略 ,计算任意两个分析物(分子)在所有聚类方案中被划分到同一簇的频率 。其核心公式为:
其中M为方案总数,若分析物i和j在方案m中同簇,则
否则为 0 。若它们在所有方案中都同簇,权重则为 1 。
Evaluate & Ensemble cluster solution:自动计算各单聚类方案之间以及其与最终组合聚类方案的 Rand 指数和调整 Rand 指数(Adjusted Rand Index),并输出最终的组合聚类共现矩阵聚类图(Clustergram)和原始数据热图 。
2. 案例分析:代谢组学数据应用(Figure 2)
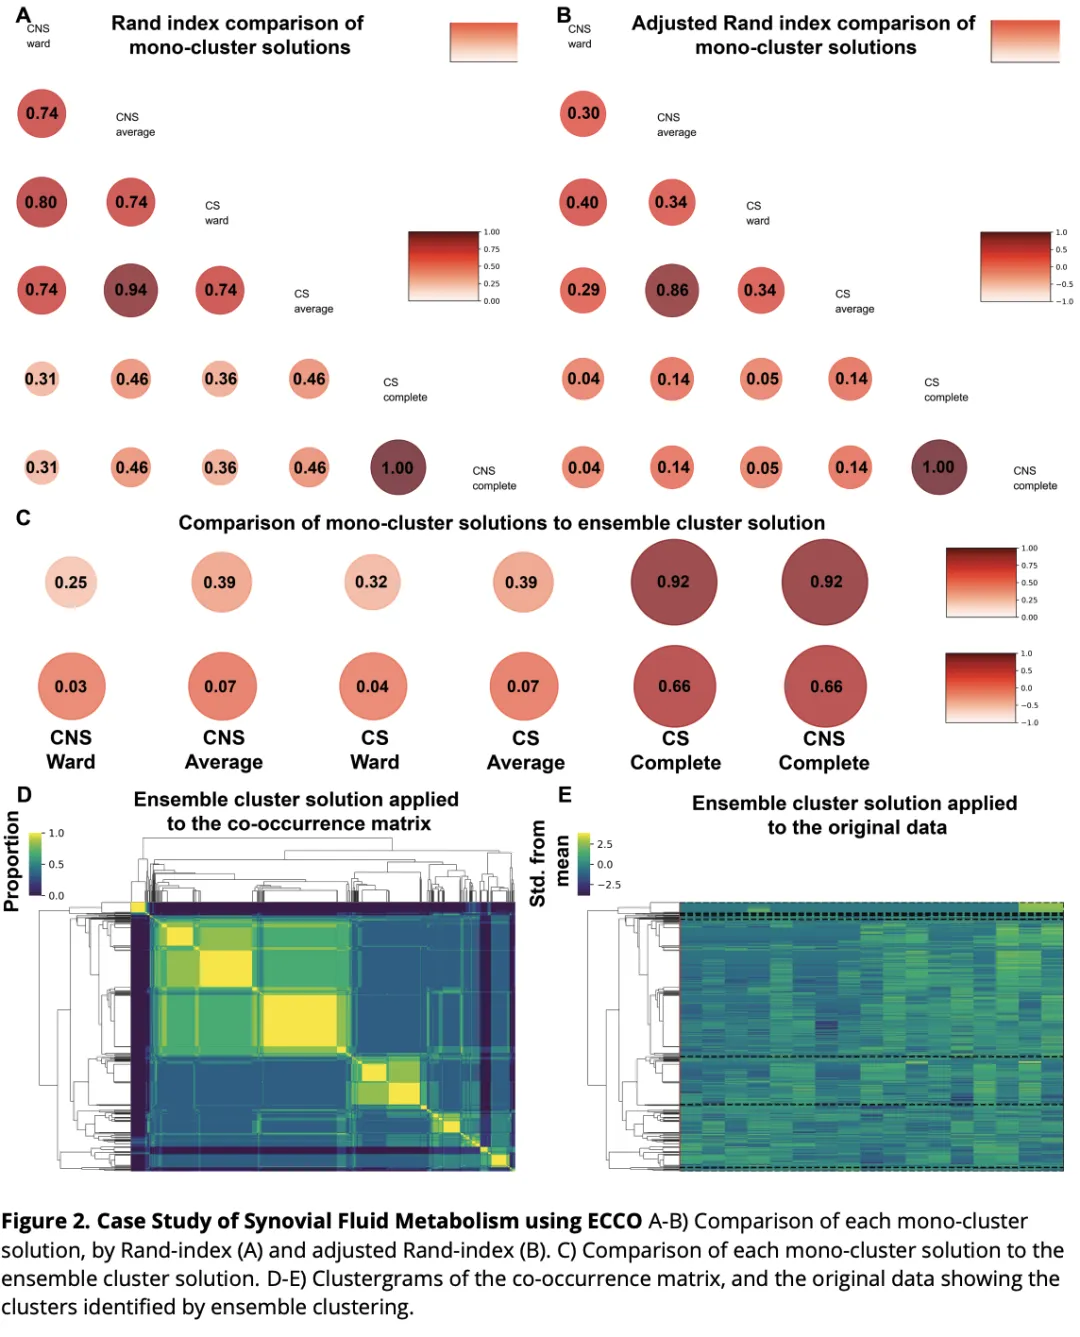
为了验证 ECCO 的实际效果,作者使用了一组已发表的膝关节滑液代谢组学数据集进行案例分析(共包含 1361 个通过过滤的代谢物特征,本处聚焦于 17 例晚期骨关节炎患者样本) 。在配备 M1 Pro 芯片的 MacBook Pro 上开启 6 个线程,整个 ECCO 流程仅耗时 50 秒 便完成了全部计算并自动保存了 Figure 2 中的图表。
(1) Figure 2A & 2B:单聚类方案的 Rand 与 Adjusted Rand 指数比较
Figure 2A(Rand 指数):值在 0.31 到 1 之间变动 ,说明各单聚类方案对代谢物的划分存在明显差异(从极小一致到完全一致) 。
Figure 2B(Adjusted Rand 指数):校正了随机相遇概率后,值在 0.04 到 1 之间 。所有值均大于 0,说明各方案的契合度均高于随机预期,表现出了高度的“聚类方案多样性”(Cluster diversity),而这正是提高组合聚类性能的关键基础 。
(2) Figure 2C:单聚类方案与最终组合聚类方案(Ensemble)的比较
(3) Figure 2D:最终组合聚类的共现矩阵图 (Clustergram of Co-occurrence)
(4) Figure 2E:映射回原始表达数据的组合聚类图
三、总结与未来展望
作为一款开源、免代码的分析工具,ECCO 成功打破了高阶生信算法与临床/生物学实验科学家之间的壁垒 。
当然,作者也客观指出了系统目前的几点限制,并给出了明确的后续更新计划 :
ECCO 代码及程序已完全开源,研究人员可直接从 GitHub 下载对应系统的可执行文件(目前最新版本 v1.0.3),快速提升自己组学数据的聚类可靠性 。
文章链接:
https://www.biorxiv.org/content/10.1101/2022.11.03.515009v2
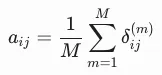

 10个月宝宝每天需要喝多少奶粉?