前面几章,我们已经把一条很重要的线慢慢串起来了。
会读 JSON 了。 会用正则提取关键信息了。 会处理时间了。 会排序、去重、统计了。 还会把脏数据清洗得更整洁了。
到这里,你会发现,很多真实问题已经不再是学不会语法,而是拿到一堆原始文本之后,不知道怎么下手。
而日志,恰好就是这种问题里最典型的一种。
你做网站,会有访问日志。 你写后端,会有运行日志。 你做自动化脚本,会有执行日志。 你处理服务器问题,会看到报错日志。 你做数据清洗,也可能会给自己留一份处理日志。
日志表面上看,就是一行一行普通文本。 可真正做项目的人都知道,日志里藏着大量有价值的信息。
哪一刻出了错。 哪种错误出现最多。 哪个接口最慢。 哪个用户操作异常。 某个任务到底有没有执行成功。 程序卡住之前,最后一步做了什么。
所以这一章很重要。
它教的不是单纯读文本文件。 而是更贴近真实工作的能力:
怎么从杂乱日志里,把真正有用的信息提取出来。
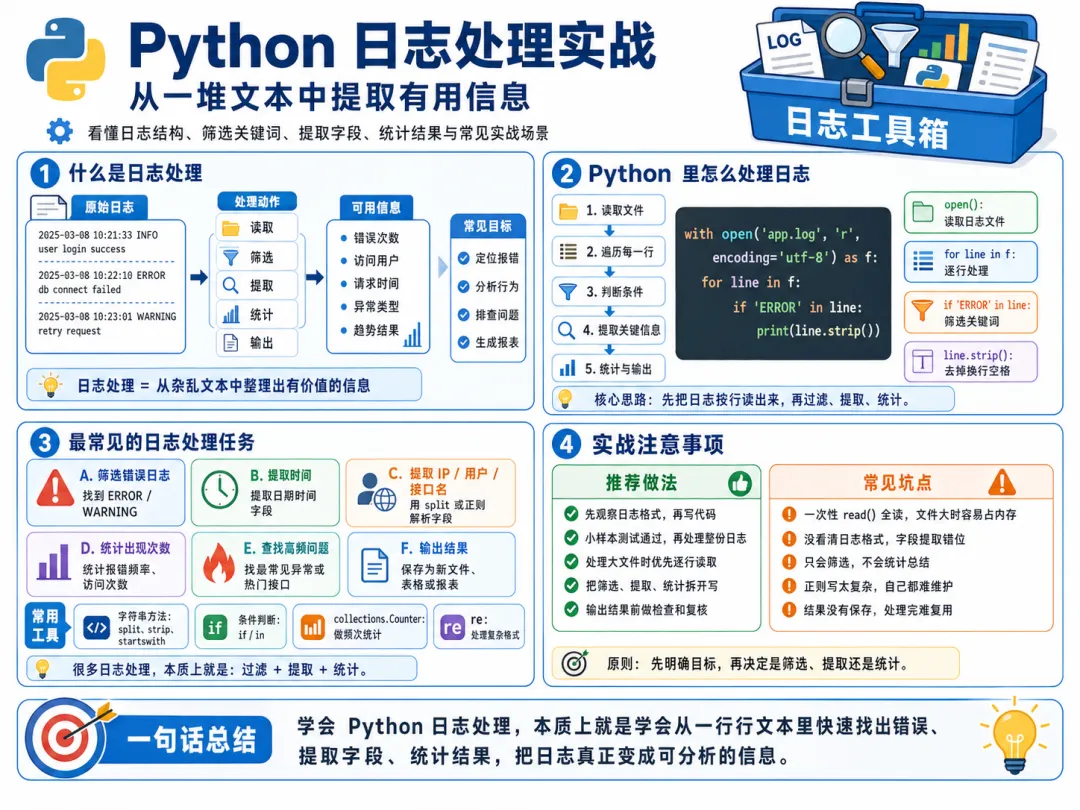
一、什么是日志,为什么程序离不开它
先别把日志想得特别玄。
你可以把日志理解成: 程序在运行过程中留下的文字记录。
就像一个人做事会写工作记录一样,程序也需要记录自己做了什么、什么时候做的、结果怎么样。
例如下面这种内容,就是很常见的日志风格:
2026-03-2909:00:01 INFO 用户登录成功 user_id=10012026-03-2909:01:15 WARNING 请求耗时过长 api=/order/list2026-03-2909:02:30 ERROR 数据库连接失败 db=mysql2026-03-2909:03:20 INFO 定时任务执行完成 task=backup
你一眼就能看出,这里面至少有这些信息:
时间 日志级别 事件描述 补充字段
这就是日志的价值。
它不是写给用户看的。 它主要是写给开发者、运维人员、排查问题的人看的。
程序平时运行得好好的,你可能不觉得它有多重要。 可一旦系统出问题,日志往往是第一现场。
所以很多时候,日志不是可有可无的附加品。 它是程序排查问题、分析行为、定位异常的重要依据。
二、为什么日志处理会成为一种实战能力
很多新手第一次接触日志,会觉得这不就是读文件吗。
其实远不止。
因为日志最大的特点就是:
量大 杂乱 重复 信息藏在文本里 并且不一定完全规整
比如你可能拿到一个几万行的日志文件。 如果靠肉眼去找错误,很快就会看花。
再比如,你想知道昨天一共报了多少次错,哪类错误最多,最早的一次错误出现在几点,哪些请求超时最严重。 这些事情用肉眼几乎没法高效完成。
所以日志处理真正考验的,不是会不会打开文件。 而是你能不能把文本里的信息批量提取、筛选、统计、整理出来。
说白了,日志处理就是数据处理能力的一次综合实战。
前面学的字符串、正则、时间、统计、清洗,在这里会同时派上用场。
三、先看一个最常见的日志长什么样
虽然不同项目日志格式会不一样,但很多日志大致都有类似结构:
时间 日志级别 具体内容
比如:
2026-03-2910:15:23 INFO 用户登录成功2026-03-2910:16:01 ERROR 支付接口调用失败2026-03-2910:16:45 WARNING 订单查询耗时过长
你可以先把它粗略拆成三部分来看:
前面是时间 中间是级别 后面是描述
其中最常见的日志级别通常有:
INFO 表示普通信息WARNING 表示警告,但未必致命ERROR 表示错误 有些项目里还会有 DEBUG、CRITICAL 等级别
所以日志处理的第一步,往往不是马上写代码。 而是先观察格式。
你得先看明白,一行日志大概由哪些部分组成,哪些部分是你关心的,哪些只是背景信息。
这一步特别重要。
很多人拿到日志就急着上正则,结果写了半天规则,发现连日志结构都没看明白。 所以越是文本处理,越要先观察,再动手。
四、处理日志之前,第一件事是先把文件读进来
这一点你已经很熟悉了。
假设我们有一个日志文件 app.log,内容如下:
2026-03-2910:15:23 INFO 用户登录成功 user_id=10012026-03-2910:16:01 ERROR 支付接口调用失败 order_id=50012026-03-2910:16:45 WARNING 订单查询耗时过长 api=/order/list2026-03-2910:17:10 INFO 用户退出登录 user_id=1001
最基础的读取方式就是:
with open("app.log", "r", encoding="utf-8") as f: content = f.read()print(content)
如果你是想一行一行处理,更常见的方式是:
with open("app.log", "r", encoding="utf-8") as f: lines = f.readlines()for line in lines: print(line.strip())
或者写得更直接一点:
with open("app.log", "r", encoding="utf-8") as f:for line in f: print(line.strip())
对于日志这种“一行就是一条记录”的文本,按行处理通常比整段处理更自然。
因为很多分析动作,本来就是围绕“每一条日志”展开的。
五、为什么日志特别适合按行处理
这个习惯非常值得养成。
日志不像一篇文章,它通常是天然分行的。 每一行基本就是一条独立记录。
例如:
2026-03-2910:15:23 INFO 用户登录成功 user_id=10012026-03-2910:16:01 ERROR 支付接口调用失败 order_id=50012026-03-2910:16:45 WARNING 订单查询耗时过长 api=/order/list
如果你把整段文本混在一起看,处理起来反而容易乱。 而按行处理时,你的思路会很清晰:
读到一行 判断是不是我要的 提取关键信息 放进结果集 继续下一行
这就像流水线一样。
所以日志处理里,一个非常重要的默认思维就是:
先把日志当成一条条记录,而不是一整坨文本。
这个习惯会让你后面写筛选、提取、统计都顺手很多。
六、日志处理最常见的第一个需求:先把错误日志筛出来
现实里,很多人第一次处理日志,不是想分析全部内容。 而是最简单也最急迫的需求:
把出错的那部分先找出来。
比如你有一份上万行日志,现在最关心的是所有 ERROR 级别的记录。 这时可以直接写:
with open("app.log", "r", encoding="utf-8") as f:for line in f:if"ERROR"in line: print(line.strip())
这段代码非常朴素,但特别实用。
它体现了一个很重要的原则:
日志分析不一定一上来就要复杂规则。 很多时候,先筛出重点内容,已经能解决大半问题。
比如:
先找所有 ERROR先找所有 WARNING先找某个接口名 先找某个用户 ID 先找某个关键词
这些其实都是日志处理中最常见的第一步。
不要小看这种基础筛选。 很多真实工作里,第一轮排查问题,真就是这么开始的。
七、进一步一点:把错误日志保存下来
很多时候,我们不只是想打印出来,而是想把筛选结果单独保存成一个文件,方便后续分析。
例如把所有错误日志保存到 error.log:
with open("app.log", "r", encoding="utf-8") as f, open("error.log", "w", encoding="utf-8") as out:for line in f:if"ERROR"in line: out.write(line)
这样,你就得到了一份只包含错误记录的新日志文件。
这个做法特别常见。
比如原始日志太大,不方便发给别人。 比如你只想拿错误部分给同事排查。 比如你后面要针对错误日志继续统计。
这一步虽然简单,但已经很接近真实日志处理工作了:
先过滤 再抽取 再单独保存
这其实就是一种非常典型的数据预处理流程。
八、只会关键词筛选还不够,因为我们还想提取结构化信息
前面我们做的是“筛出来”。 但很多时候,光筛出来还不够。
比如下面这条日志:
2026-03-2910:16:01 ERROR 支付接口调用失败 order_id=5001
如果你只是打印这一整行,当然能看。 但如果你真正想做分析,你更希望拿到的是:
时间:2026-03-29 10:16:01 级别:ERROR 消息:支付接口调用失败 订单号:5001
一旦这些信息被拆出来,你后面就能做更多事:
统计某天错误次数 按时间排序 统计每种错误类型 找出涉及哪些订单 把结果存进表格或数据库
所以日志处理真正有价值的地方,往往在于:
把文本日志,逐步转成结构化数据。
九、最简单的日志拆分方式:先用 split 处理规则明显的日志
如果日志格式比较规整,其实不一定非要一上来就用正则。
比如日志格式始终像这样:
2026-03-2910:16:01 ERROR 支付接口调用失败
你先试着按空格拆分,就能得到不少信息。
line = "2026-03-29 10:16:01 ERROR 支付接口调用失败"parts = line.split()print(parts)
输出会是:
['2026-03-29', '10:16:01', 'ERROR', '支付接口调用失败']
这时你就能很直接地拿到:
date = parts[0]time = parts[1]level = parts[2]message = " ".join(parts[3:])
这种写法非常适合日志格式简单、字段位置稳定的场景。
所以你要记住:
文本处理不是逢日志必正则。 能用简单方法解决时,先用简单方法。
这是很重要的实战思维。
十、但很多日志并没那么规矩,这时候正则就派上用场了
真实项目里,日志格式经常更复杂一些。
例如:
2026-03-2910:16:01 ERROR 支付接口调用失败 order_id=50012026-03-2910:16:45 WARNING 订单查询耗时过长 api=/order/list2026-03-2910:17:20 INFO 用户登录成功 user_id=1001
这类日志里,前半部分相对稳定,后半部分字段不一定完全固定。 这时候正则会非常适合。
比如先把时间和级别提出来:
import reline = "2026-03-29 10:16:01 ERROR 支付接口调用失败 order_id=5001"match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})\s+(INFO|WARNING|ERROR)\s+(.*)", line)if match: print("时间:", match.group(1)) print("级别:", match.group(2)) print("内容:", match.group(3))
输出大致是:
时间: 2026-03-2910:16:01级别: ERROR内容: 支付接口调用失败 order_id=5001
这一步非常关键。
因为它说明一件事:
日志虽然原本是文本,但你完全可以通过规则,把它逐步拆成更容易处理的部分。
这就是日志分析的核心起点。
十一、进一步提取日志里的具体字段
刚才我们已经把整行拆成了时间、级别、内容。 那如果我们还想从内容里继续提取字段怎么办
比如这条:
支付接口调用失败 order_id=5001
我们还想拿到订单号 5001。
这时可以继续用正则:
import remessage = "支付接口调用失败 order_id=5001"match = re.search(r"order_id=(\d+)", message)if match: print(match.group(1))
输出:
5001
同理,你也可以提取:
user_id=1001api=/order/listcost=2.35sip=192.168.1.10
你会发现,日志处理非常像“多层提取”:
先按行读 再拆整行 再从局部字段里挖出更细的信息
这和前面学的正则提取手机号、日期、邮箱,其实是一个思路。
十二、先做一个小案例:统计错误日志一共有多少条
假设日志文件内容如下:
2026-03-2910:15:23 INFO 用户登录成功2026-03-2910:16:01 ERROR 支付接口调用失败2026-03-2910:16:45 WARNING 订单查询耗时过长2026-03-2910:17:10 ERROR 数据库连接失败2026-03-2910:18:00 INFO 用户退出登录
你想统计一共有多少条错误日志。
代码其实很直接:
count = 0with open("app.log", "r", encoding="utf-8") as f:for line in f:if"ERROR"in line: count += 1print("错误日志数量:", count)
输出:
错误日志数量: 2
这个例子虽然简单,但它已经体现了日志处理最朴素的实用价值:
从一堆肉眼难以快速统计的文本里,提炼出明确结论。
很多自动化脚本,最开始就是从这种小需求长出来的。
十三、再进一步:统计每种日志级别分别出现多少次
这就比单纯统计错误数更完整一些了。
我们想知道:
INFO 出现多少次WARNING 出现多少次ERROR 出现多少次
这时候很适合用前一章学过的 Counter。
from collections import Counterlevels = []with open("app.log", "r", encoding="utf-8") as f:for line in f: parts = line.split()if len(parts) >= 3: level = parts[2] levels.append(level)result = Counter(levels)print(result)
输出大致会是:
Counter({'INFO': 2, 'ERROR': 2, 'WARNING': 1})
你看,前面学过的统计能力,在这里马上就接上了。
这也是为什么我前面一直强调: 不要把知识点孤立看。
字符串处理、列表、字典、正则、Counter,这些东西单独看可能都不算复杂。 但一旦组合起来,就能开始解决真实问题。
十四、日志处理里最常见的需求之一:找出出现最多的错误类型
这比统计 ERROR 总数更进一步。
很多时候,大家关心的不只是“有多少错”,而是:
到底哪种错最常见
比如错误日志可能有这些:
2026-03-2910:16:01 ERROR 支付接口调用失败2026-03-2910:17:10 ERROR 数据库连接失败2026-03-2910:18:05 ERROR 支付接口调用失败2026-03-2910:19:20 ERROR 支付接口调用失败
你想知道哪个错误最频繁,就可以先把错误消息提取出来,再计数。
from collections import Countererrors = []with open("app.log", "r", encoding="utf-8") as f:for line in f:if"ERROR"in line: parts = line.split() message = " ".join(parts[3:]) errors.append(message)result = Counter(errors)print(result)print("最常见错误:", result.most_common(1))
输出可能是:
Counter({'支付接口调用失败': 3, '数据库连接失败': 1})最常见错误: [('支付接口调用失败', 3)]
这就已经很像一个小型日志分析报告了。
十五、很多日志分析问题,真正难点不在统计,而在清洗
比如你想统计错误类型,但日志内容可能是:
支付接口调用失败 order_id=5001支付接口调用失败 order_id=5002支付接口调用失败 order_id=5003
如果你直接整行计数,那它们会被当成三种不同错误。 但从业务角度看,它们其实是同一类问题。
所以你要做的,不只是统计。 而是先把可变部分去掉。
这时候正则清洗就很有用了:
import refrom collections import Countererrors = []with open("app.log", "r", encoding="utf-8") as f:for line in f:if"ERROR"in line: parts = line.split() message = " ".join(parts[3:]) message = re.sub(r"order_id=\d+", "", message).strip() errors.append(message)result = Counter(errors)print(result)
这样,即使订单号不同,也会被归到同一个错误类别里。
你会发现,这一章和前面的“函数式清洗数据”也接上了。
日志分析不是只会读和数。 很多时候,得先把日志内容标准化,统计才有意义。
十六、日志里最重要的字段之一,往往是时间
因为很多分析都和时间有关。
比如:
某种错误是几点开始出现的 某个时间段错误暴涨 某个任务多久执行一次 某一天的错误量是不是比前一天更多 一条请求从开始到结束耗时多久
所以日志处理里,时间字段通常非常关键。
例如从日志里提取时间:
import reline = "2026-03-29 10:16:01 ERROR 支付接口调用失败"match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})", line)if match: print(match.group(1))
拿到时间字符串后,你还可以继续转成 datetime 对象:
from datetime import datetimetime_text = "2026-03-29 10:16:01"dt = datetime.strptime(time_text, "%Y-%m-%d %H:%M:%S")print(dt)
一旦变成时间对象,你后面就能做真正的时间比较和统计了。
十七、一个很实用的场景:筛选某个时间段的日志
假设你只想看上午 10 点到 11 点之间的错误日志。
这时候,时间解析就非常有用了。
from datetime import datetimeimport restart = datetime.strptime("2026-03-29 10:00:00", "%Y-%m-%d %H:%M:%S")end = datetime.strptime("2026-03-29 11:00:00", "%Y-%m-%d %H:%M:%S")with open("app.log", "r", encoding="utf-8") as f:for line in f: match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})", line)if match: log_time = datetime.strptime(match.group(1), "%Y-%m-%d %H:%M:%S")if start <= log_time <= end and"ERROR"in line: print(line.strip())
这类需求在排查线上问题时特别常见。
因为很多问题往往不是全天都发生,而是某一小段时间突然暴增。 所以时间筛选,是日志处理中非常高频的一类操作。
十八、日志里经常还藏着请求耗时、接口名、用户 ID 这类信息
比如一条日志:
2026-03-2910:16:45 WARNING 请求耗时过长 api=/order/list cost=2.35s
如果你只把它当普通文本看,就很浪费。 因为里面至少还有两个很有分析价值的字段:
接口:/order/list耗时:2.35s
我们可以用正则把它提出来:
import reline = "2026-03-29 10:16:45 WARNING 请求耗时过长 api=/order/list cost=2.35s"api_match = re.search(r"api=([^\s]+)", line)cost_match = re.search(r"cost=([\d.]+)s", line)if api_match: print("接口:", api_match.group(1))if cost_match: print("耗时:", cost_match.group(1))
输出:
接口: /order/list耗时: 2.35
一旦这些字段被提取出来,你就可以进一步做:
统计哪个接口最慢 筛选耗时超过 2 秒的请求 按接口分类统计平均耗时
这时候日志文本就已经开始往“可分析的数据”转变了。
十九、做一个更真实一点的小案例:找出所有耗时超过 2 秒的请求
这是非常典型的日志分析需求。
假设日志里有这些内容:
2026-03-2910:16:45 WARNING 请求耗时过长 api=/order/list cost=2.35s2026-03-2910:17:10 INFO 请求正常 api=/user/info cost=0.35s2026-03-2910:17:50 WARNING 请求耗时过长 api=/pay/create cost=3.20s
现在我们要把耗时超过 2 秒的接口筛出来。
import rewith open("app.log", "r", encoding="utf-8") as f:for line in f: api_match = re.search(r"api=([^\s]+)", line) cost_match = re.search(r"cost=([\d.]+)s", line)if api_match and cost_match: api = api_match.group(1) cost = float(cost_match.group(1))if cost > 2: print(f"慢请求:{api},耗时 {cost} 秒")
这段代码已经很像实际排查性能问题的脚本了。
你会发现,它背后其实只是在做几件事:
读日志 提字段 转类型 做判断 输出结果
说到底,还是数据处理。
二十、日志处理里,函数式思维同样非常有用
前一章我们讲过,把清洗动作拆成函数。 这一章同样适用。
例如你可以把“解析一行日志”单独封装成函数:
import redefparse_log_line(line): match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})\s+(INFO|WARNING|ERROR)\s+(.*)", line.strip())ifnot match:returnNonereturn {"time": match.group(1),"level": match.group(2),"message": match.group(3) }
测试一下:
line = "2026-03-29 10:16:01 ERROR 支付接口调用失败 order_id=5001"print(parse_log_line(line))
输出:
{'time': '2026-03-29 10:16:01','level': 'ERROR','message': '支付接口调用失败 order_id=5001'}
这样一来,后面整份日志处理就会清楚很多。
你不再每次都在主循环里重复写正则。 而是把“如何解析一行日志”这件事,交给一个单独函数。
这就是结构化思维的价值。
二十一、再进一步:把日志中更细的字段也封装出来
例如我们希望一条日志最终被整理成这样:
{"time": "2026-03-29 10:16:01","level": "ERROR","message": "支付接口调用失败","order_id": "5001"}
可以进一步写解析函数:
import redefparse_log_line(line): match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})\s+(INFO|WARNING|ERROR)\s+(.*)", line.strip())ifnot match:returnNone time_text = match.group(1) level = match.group(2) raw_message = match.group(3) order_match = re.search(r"order_id=(\d+)", raw_message) order_id = order_match.group(1) if order_match elseNone message = re.sub(r"order_id=\d+", "", raw_message).strip()return {"time": time_text,"level": level,"message": message,"order_id": order_id }
这就更像项目代码了。
因为日志原来只是普通字符串。 现在它已经变成了一个结构化字典。 后面你再统计、筛选、排序,就会容易很多。
二十二、把整份日志转成列表后,后面事情就顺了
例如我们先把每一行都解析成字典,放进一个列表里:
logs = []with open("app.log", "r", encoding="utf-8") as f:for line in f: parsed = parse_log_line(line)if parsed: logs.append(parsed)print(logs)
这时候,logs 可能会变成这样:
[ {"time": "2026-03-29 10:15:23", "level": "INFO", "message": "用户登录成功", "order_id": None}, {"time": "2026-03-29 10:16:01", "level": "ERROR", "message": "支付接口调用失败", "order_id": "5001"}]
看到这里你应该会有一个明显感受:
日志原本难处理,是因为它只是文本。 一旦转成列表加字典,整个世界都清楚了。
你可以按级别筛选,可以按时间排序,可以统计错误类型,可以导出表格。 这就是“把文本变成结构化数据”的力量。
二十三、做一个完整一点的小案例:统计错误类型、错误次数、最早时间
我们来写一个更像实战的小脚本。
假设日志格式如下:
2026-03-2910:16:01 ERROR 支付接口调用失败 order_id=50012026-03-2910:17:10 ERROR 数据库连接失败 db=mysql2026-03-2910:18:05 ERROR 支付接口调用失败 order_id=50022026-03-2910:19:20 ERROR 支付接口调用失败 order_id=50032026-03-2910:20:00 INFO 用户登录成功 user_id=1001
我们想要得到这些结果:
错误总数 每种错误分别出现几次 第一条错误发生在什么时候
代码可以这样写:
import refrom collections import Counterfrom datetime import datetimedefparse_error_message(message): message = re.sub(r"order_id=\d+", "", message) message = re.sub(r"db=\w+", "", message)return message.strip()error_messages = []error_times = []with open("app.log", "r", encoding="utf-8") as f:for line in f: match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})\s+(INFO|WARNING|ERROR)\s+(.*)", line.strip())ifnot match:continue time_text = match.group(1) level = match.group(2) message = match.group(3)if level == "ERROR": clean_message = parse_error_message(message) error_messages.append(clean_message) dt = datetime.strptime(time_text, "%Y-%m-%d %H:%M:%S") error_times.append(dt)print("错误总数:", len(error_messages))print("错误统计:", Counter(error_messages))if error_times: print("第一条错误时间:", min(error_times))
这段代码已经非常接近日常日志分析脚本的样子了。
二十四、日志处理里还有一种很常见的需求:找某个用户做了什么
比如有些日志里会记录 user_id=1001。 这时候你可能想查:
这个用户今天都干了哪些操作 他在报错前做了什么 他是不是频繁请求某个接口
例如筛出某个用户的日志:
target_user = "1001"with open("app.log", "r", encoding="utf-8") as f:for line in f:iff"user_id={target_user}"in line: print(line.strip())
如果你愿意再往前走一步,也可以先提取所有用户 ID,再统计最活跃的用户。
你会发现,日志文本虽然表面普通,但实际上已经很像数据库里的记录了。 只不过它还没被正式整理出来而已。
而日志处理的过程,本质上就是在做这件事: 把文本里的行为记录,整理成可分析的数据。
二十五、日志处理特别适合和前面学过的知识联动
这一章其实就是前面很多知识点的一次综合应用。
字符串方法,用来做基础切分和清洗。 正则表达式,用来提取时间、级别、订单号、接口名、耗时。 时间处理,用来筛选某个时间段、计算先后顺序。 排序、去重、统计,用来总结日志规律。 函数式清洗思路,用来把解析逻辑写得更清晰。
所以如果你发现这一章有点像“综合题”,那是正常的。 因为真实工作里,本来就很少只考一个孤立知识点。
很多有价值的脚本,都是几种基础能力组合出来的。
而日志处理,恰好就是非常典型的组合型场景。
二十六、真实日志和练习日志最大的区别是什么
练习题里的日志通常都很干净。 格式统一,字段整齐,没有异常行。
但真实日志未必。
你可能会遇到:
空行 格式不完整的行 级别缺失 某些字段有时有,有时没有 时间格式偶尔不一致 消息内容里带额外空格或符号
所以写日志处理脚本时,一个特别重要的习惯就是:
不要默认每一行都完美。 要给异常情况留余地。
比如解析失败时直接跳过:
parsed = parse_log_line(line)if parsed isNone:continue
比如提取某个字段时,先判断匹配是否存在:
match = re.search(r"user_id=(\d+)", line)if match: user_id = match.group(1)else: user_id = None
这种“写得稳一点”的意识,和单纯会语法,是两回事。
二十七、给初学者一个非常实用的日志处理套路
以后你只要拿到一份日志,基本都可以按这个顺序想:
先观察格式。 看每一行大概由哪些部分组成。
再做基础筛选。 比如先找 ERROR,先找某个关键词。
然后提取结构。 把时间、级别、内容、附加字段拆出来。
接着清洗标准化。 去掉不重要的可变字段,让同类日志归到一起。
最后再统计和分析。 看数量、频次、时间分布、异常模式。
你按这个套路去处理,思路通常不会太乱。
最怕的是一上来就想一步到位,结果规则还没看清,代码已经写乱了。
二十八、这一章真正重要的,不只是会处理日志,而是会从文本里挖信息
你可以把日志看成一种特别典型的文本数据。 它比普通文章更规整,但又没有表格那么整洁。
所以学日志处理,本质上是在训练一种非常实用的能力:
面对一堆文本,能不能把里面有价值的信息提出来,并整理成可分析的结果。
这不只对日志有用。
以后你处理聊天记录、爬虫原始文本、服务器输出、命令行结果、系统导出文件,很多时候都在做类似的事。
所以这一章表面讲的是日志。 更深一层,讲的是文本信息提取和结构化分析能力。
这是非常有实战价值的一步。
本章小结
日志本质上是程序运行过程留下的文本记录。 它通常包含时间、级别、事件描述,以及各种补充字段。
日志处理的核心,不是把文件读出来就结束。 而是要把日志从一堆原始文本,逐步变成可筛选、可统计、可分析的结构化信息。
这一章你要重点掌握这些思路:
先按行处理日志。 先做关键词筛选,比如先找 ERROR。 能用 split() 解决的场景,不必一上来就用正则。 格式复杂时,用正则提取时间、级别、接口、用户 ID、耗时等字段。 把可变部分清洗掉,再做统计,结果会更可靠。 尽量把解析逻辑封装成函数,让代码更清楚、更像正式项目。
当你真正理解这一点,日志对你来说就不再只是“程序吐出来的一堆字”。 它会慢慢变成一份可以被提炼、被分析、被利用的数据来源。
课后练习
第一,准备一份简单日志文件,统计其中 ERROR 一共出现多少次。
第二,把日志中的 INFO、WARNING、ERROR 级别分别统计出来。
第三,写一个正则,把每行日志里的时间、级别、内容拆出来。
第四,从日志中提取所有 user_id 或 order_id,整理成列表。
第五,把错误日志的可变字段去掉后,再统计哪种错误最常见。
第六,筛选某个时间段内的日志,看看这段时间里到底发生了什么。
 10个月宝宝每天需要喝多少奶粉?