Python 单细胞分析进阶:详细理解 AnnData 数据结构
单细胞 Python 分析系列第 4 篇前面我们已经学习了 Python 基础语法、条件语句、循环语句、函数以及 pandas 数据框操作。从这一篇开始,我们正式进入 Python 单细胞分析中最重要的数据对象:AnnData。
很多同学刚开始学习 Scanpy 时,最容易卡在这些名字上:
adata.Xadata.obsadata.varadata.layersadata.rawadata.obsmadata.varmadata.unsadata.obspadata.varp
这些名字看起来比较抽象,但只要记住一个核心思想,后面就会清楚很多:
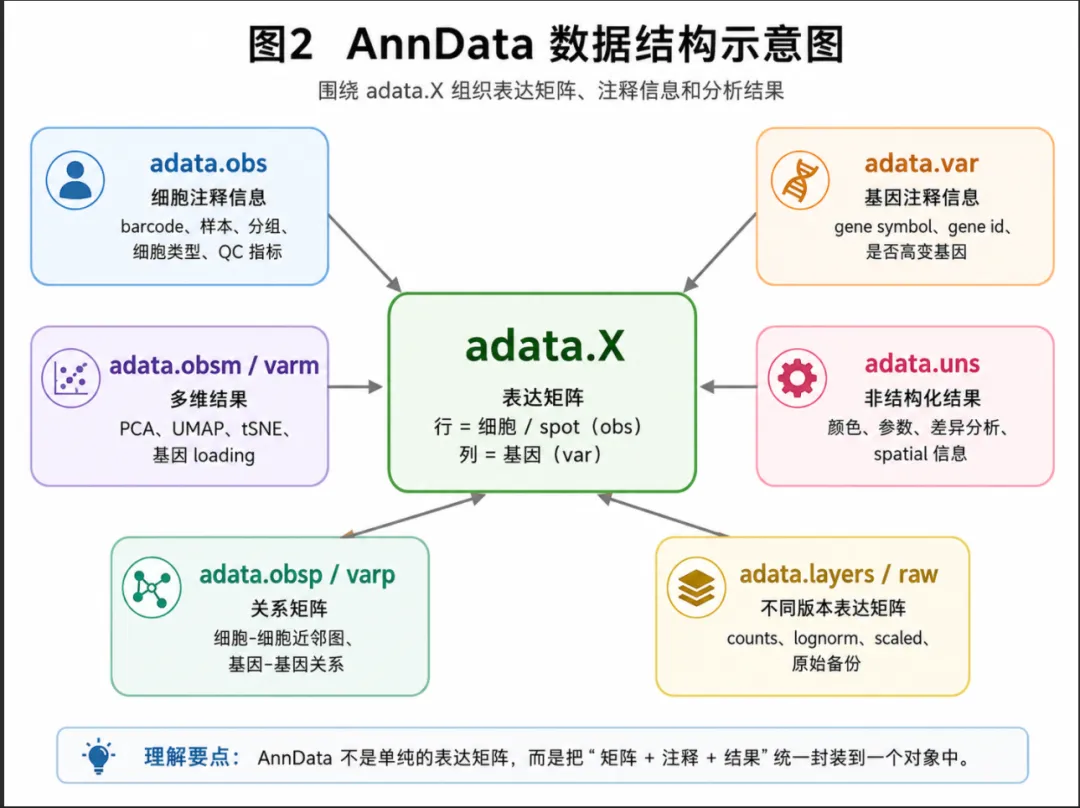
AnnData 不是一个简单的表达矩阵,而是一个用来统一保存表达矩阵、细胞注释、基因注释和分析结果的对象。
如果说 R 语言中 Seurat 对象是单细胞分析的核心,那么在 Python 生态中,AnnData 就是 Scanpy 分析流程中最核心的数据结构。
本文学习目标
读完这一篇,你应该能够理解:
1. 为什么 Python 单细胞分析需要 AnnData;
2. `adata.X`、`adata.obs`、`adata.var` 分别保存什么;
3. `layers`、`raw`、`obsm`、`uns`、`obsp` 这些结构分别有什么用途;
4. 单样本单细胞基础分析流程中,每一步会改变 AnnData 的哪个槽位;
5. 初学者在使用 AnnData 时最容易踩哪些坑。
01 为什么需要 AnnData?
单细胞数据并不只是一个表达矩阵。
一个完整的单细胞分析对象,通常至少包括:
- 每个细胞的 barcode、样本来源、分组、细胞类型等注释信息;
- 每个基因的 gene symbol、gene id、高变基因标记等信息;
如果把这些信息全部分开保存,分析过程会非常混乱。
例如,你可能需要同时维护:
表达矩阵.csv细胞注释.csv基因注释.csvUMAP坐标.csv聚类结果.csv差异基因结果.csv
这样做不仅容易出错,也很难保证不同文件中的细胞顺序、基因顺序完全一致。
因此,AnnData 的作用就是:
把单细胞分析中产生的各种信息,统一装进一个对象里。
这样后续做质控、降维、聚类、可视化和保存结果时,都可以围绕一个对象完成。
02 什么是类和对象?
在 Python 中,很多分析结果不是普通的数据框,而是一个“对象”。
例如:
import scanpy as scadata = sc.read_h5ad(”learndata.h5ad”)adata
这里的 adata 就是一个 AnnData 对象。
它有点类似于 R 语言中的 Seurat 对象,也可以粗略理解为 R 中的 S4 对象。这个对象里面不仅有表达矩阵,还有细胞信息、基因信息、降维结果和分析结果。
可以简单理解为:
AnnData 对象 = 表达矩阵 + 细胞信息 + 基因信息 + 分析结果
查看对象时,通常会看到类似结果:
AnnData object with n_obs × n_vars = 3000 × 20000 obs: ... var: ... uns: ... obsm: ... layers: ... obsp: ...
其中:
n_obs = observation,观察值数量,通常是细胞数或空间 spot 数n_vars = variable,变量数量,通常是基因数
对于单细胞 RNA-seq:
对于空间转录组 Visium 数据:
03 Python 单细胞分析生态:Scverse
Python 单细胞分析常用的是Scverse生态。
可以简单类比:
R 语言单细胞生态:Seurat / BioconductorPython 单细胞生态:Scanpy / AnnData / Scverse
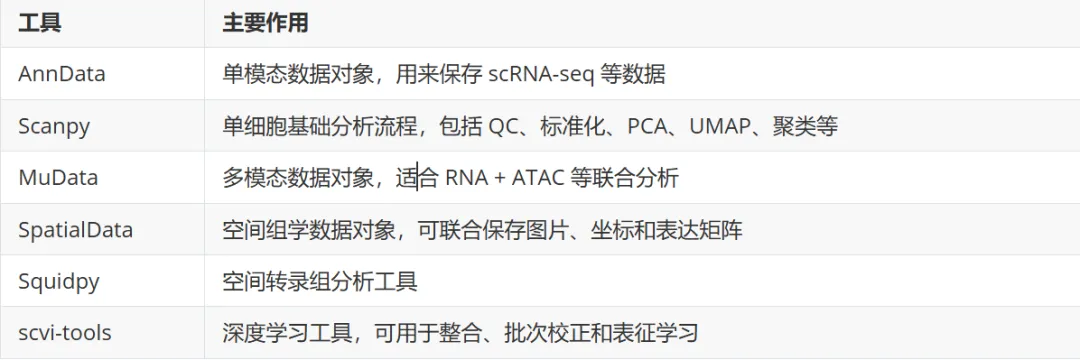
常见工具包括:
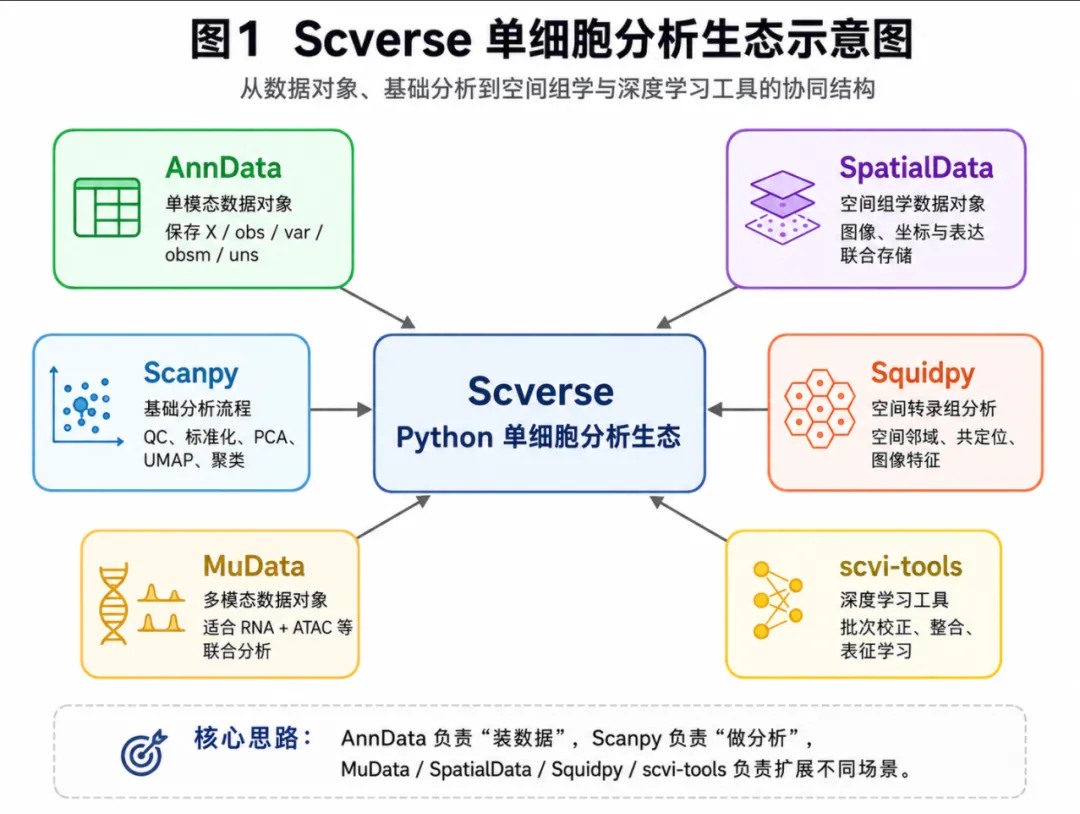
图 1 可以帮助大家建立一个整体认识:
AnnData 负责“装数据”,Scanpy 负责“做分析”,MuData / SpatialData / Squidpy / scvi-tools 负责扩展不同应用场景。
04 AnnData 的整体结构
AnnData 全称是:
也就是“带注释的数据”。
它最核心的结构可以理解为:
adata.X 表达矩阵adata.obs 细胞注释信息adata.var 基因注释信息adata.layers 不同版本表达矩阵adata.raw 原始表达备份adata.obsm 细胞层面的多维结果adata.varm 基因层面的多维结果adata.uns 非结构化结果adata.obsp 细胞-细胞关系矩阵adata.varp 基因-基因关系矩阵
可以把 AnnData 想象成一个整理好的“数据收纳箱”。不同的信息放在不同的槽位中,后续分析和可视化时,Scanpy 会自动从这些槽位中读取对应内容。
05 准备环境和读取数据
本篇使用 Scanpy 作为示例。
import scanpy as scimport anndata as adimport pandas as pdimport numpy as npimport matplotlib.pyplot as plt
读取 .h5ad 文件:
adata = sc.read_h5ad(”learndata.h5ad”)adata
读取后建议先运行:
adata.var_names_make_unique()
这一步的作用是让基因名唯一,避免后续分析中因为重复基因名产生报错或 warning。
如果你读取的是 10X mtx 格式,可以使用:
adata = sc.read_10x_mtx( ”filtered_feature_bc_matrix/”, var_names=”gene_symbols”, cache=True)adata.var_names_make_unique()adata
如果你读取的是 10X h5 格式,可以使用:
adata = sc.read_10x_h5(”filtered_feature_bc_matrix.h5”)adata.var_names_make_unique()adata
06 adata.X:表达矩阵
adata.X 是 AnnData 中最核心的部分,用来保存表达矩阵。
查看表达矩阵维度:
AnnData 中表达矩阵的方向是:
也就是:
这一点非常重要。很多 R 语言分析中,我们更常见的是:
所以在 Python 单细胞分析中,一定要注意矩阵方向。
可以查看对象中的细胞数和基因数:
也可以查看细胞名和基因名:
adata.obs_namesadata.var_names
07 稀疏矩阵和普通矩阵
单细胞表达矩阵中有大量 0 值,因此通常用稀疏矩阵保存。
查看:
如果显示类似:
Compressed Sparse Row sparse matrix
说明 adata.X 是稀疏矩阵。
如果想转成普通矩阵,可以使用:
dense_matrix = adata.X.toarray()
如果想转成 pandas 数据框:
expr_df = adata.to_df()expr_df.head()
但是要注意:真实单细胞数据往往很大,直接转成普通矩阵可能会占用大量内存。
不建议随便对大对象运行:
更推荐只提取少量基因:
adata[:, [”Dusp3”, ”Dusp5”]].to_df()
如果是人类数据,基因名通常是大写:
adata[:, [”DUSP3”, ”DUSP5”]].to_df()
08 adata.obs:细胞注释信息
adata.obs 相当于 Seurat 对象中的 metadata。
查看:
查看有哪些列:
常见内容包括:
样本来源实验分组细胞类型n_countsn_genes线粒体比例聚类编号批次信息
例如计算质控指标:
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], inplace=True)
运行后,adata.obs 中会增加:
n_genes_by_countstotal_countstotal_counts_mtpct_counts_mt
这些都是每个细胞的质控信息。
09 在 adata.obs 中添加新信息
adata.obs 本质上是一个 pandas DataFrame,因此可以像操作普通数据框一样添加新列。
例如标记线粒体比例较高的细胞:
adata.obs[”high_mt”] = adata.obs[”pct_counts_mt”] > 20
也可以添加分组信息:
adata.obs[”group”] = ”sample1”
如果有多个样本,可以根据样本名映射分组:
adata.obs[”group”] = adata.obs[”sample”].map({ ”sample1”: ”Control”, ”sample2”: ”Disease”})
查看细胞名字:
通常 adata.obs_names 就是每个细胞的 barcode。
10 adata.var:基因注释信息
adata.var 保存的是基因层面的信息。
查看:
查看基因名:
查看有哪些基因注释列:
常见内容包括:
gene_idsfeature_typeshighly_variablemeansdispersionsmt
比如下面这句:
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)
就是在 adata.var 中添加一列,标记哪些基因是线粒体基因。
对于人类数据,线粒体基因通常是大写:
adata.var[”mt”] = adata.var_names.str.startswith(”MT-”)
对于小鼠数据,线粒体基因通常是小写:
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)
11 修改基因索引时要谨慎
有些数据读取后,adata.var_names 是 gene symbol,例如:
而 adata.var["gene_ids"] 是 Ensembl ID,例如:
如果确实想把基因名改成 Ensembl ID,建议先保存原来的 gene symbol:
adata.var[”gene_symbol”] = adata.var_namesadata.var_names = adata.var[”gene_ids”]
但是对于初学者,我更建议保留 gene symbol 作为 var_names。因为后面画图时使用 gene symbol 更直观:
sc.pl.umap(adata, color=”Dusp5”)
12 adata.layers:保存不同版本的表达矩阵
adata.layers 非常重要。
在分析过程中,表达矩阵会经历多个版本:
原始 counts归一化数据log-normalized 数据scale 后的数据
如果所有步骤都覆盖到 adata.X 中,后面很容易不知道当前的 adata.X 到底是什么。
因此,推荐使用 layers 保存不同版本的数据。
在归一化之前保存原始 counts:
adata.layers[”counts”] = adata.X.copy()
归一化和 log 转换:
sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()
查看 layers:
使用某一个 layer 画图:
sc.pl.matrixplot( adata, var_names=[”Dusp3”, ”Dusp5”], groupby=”clusters”, layer=”lognorm”)
这里建议大家养成一个习惯:
不要随便覆盖 adata.X,关键步骤前先保存到 layers。
13 adata.raw:保存原始表达备份
除了 layers,AnnData 还有一个常用结构叫 raw。
一般可以在筛选高变基因之前保存:
它的作用是保留一份原始表达信息。例如后面只保留了高变基因,但画图时还想查看其他基因,就可以从 adata.raw 中调用。
需要注意:adata.raw 通常只是用于保存表达备份,不建议在整个流程中反复修改。
14 adata.obsm:存储降维坐标
adata.obsm 用来存储每个细胞对应的多维信息。
查看:
常见内容包括:
例如 PCA 结果:
UMAP 结果通常保存在:
所以当我们运行:
Scanpy 实际上是把 UMAP 坐标保存到了:
画图时:
sc.pl.umap(adata, color=”clusters”)
本质上就是从 adata.obsm["X_umap"] 中取坐标。
如果是空间转录组,空间坐标通常保存在:
15 adata.varm:存储基因层面的多维信息
adata.varm 和 obsm 类似,但它是针对基因的。
例如 PCA 中每个基因对主成分的贡献,也就是 loading,可能会保存在:
查看:
对于初学者来说,varm 使用频率没有 obsm 高,但需要知道它保存的是基因层面的多维结果。
16 adata.uns:存储非结构化信息
adata.uns 是一个字典结构,用来保存各种非结构化结果。
查看:
或者:
注意这里要加括号。
常见内容包括:
neighborsumapleidenrank_genes_groupslog1pspatial
例如运行聚类:
sc.tl.leiden(adata, key_added=”clusters”)
聚类结果会保存在:
而聚类颜色等信息可能保存在:
adata.uns[”clusters_colors”]
运行差异分析:
sc.tl.rank_genes_groups( adata, groupby=”clusters”, method=”wilcoxon”)
差异分析结果会保存在:
adata.uns[”rank_genes_groups”]
提取差异基因结果:
deg = sc.get.rank_genes_groups_df( adata, group=None)deg.head()
17 adata.obsp:细胞之间的关系矩阵
adata.obsp 用来存储细胞和细胞之间的关系矩阵。
查看:
当我们运行:
Scanpy 会构建细胞之间的近邻图,结果通常保存在:
adata.obsp[”distances”]adata.obsp[”connectivities”]
其中:
distances:细胞之间的距离connectivities:细胞之间的连接强度
后面的 UMAP 和 Leiden 聚类都依赖这个近邻图。
也就是说,Scanpy 基础流程一般是:
PCA → neighbors → UMAP / Leiden
18 adata.varp:基因之间的关系矩阵
adata.varp 和 obsp 类似,但它保存的是基因与基因之间的关系。
例如:
在基础单细胞分析中,varp 不一定经常使用,但在基因网络分析、共表达分析中可能会用到。
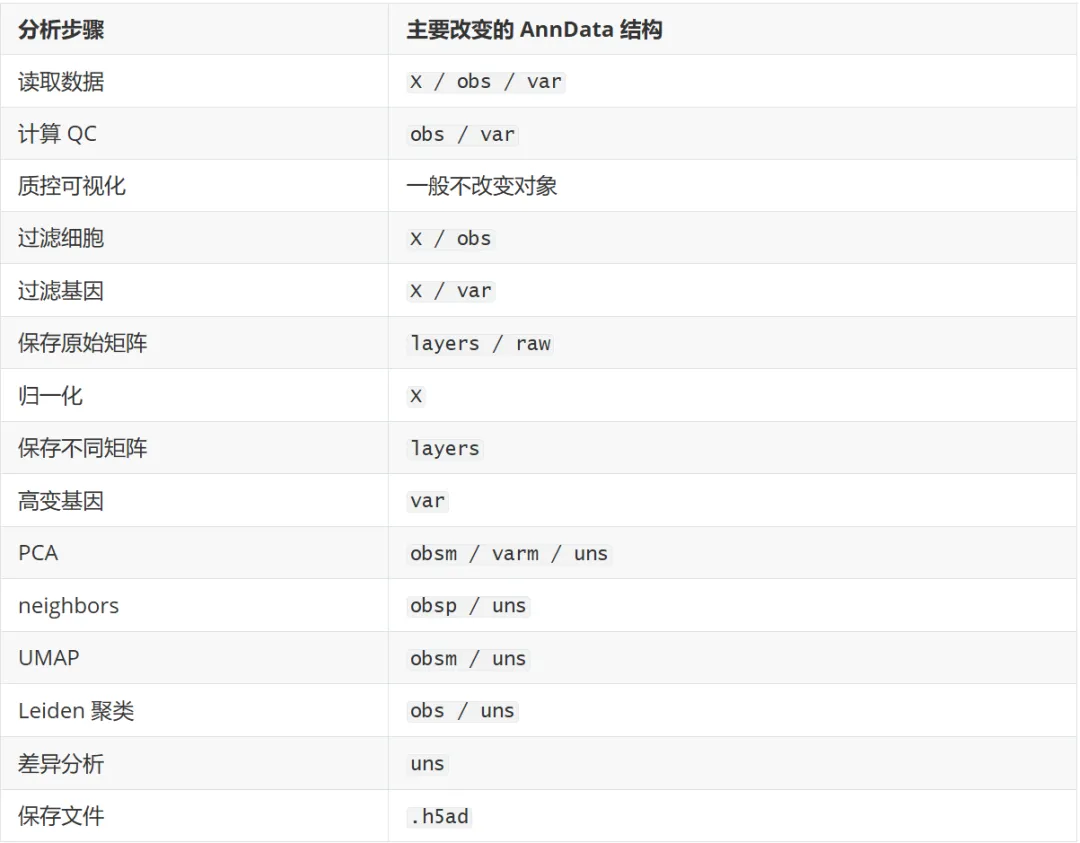
19 结合单样本分析流程理解 AnnData 变化
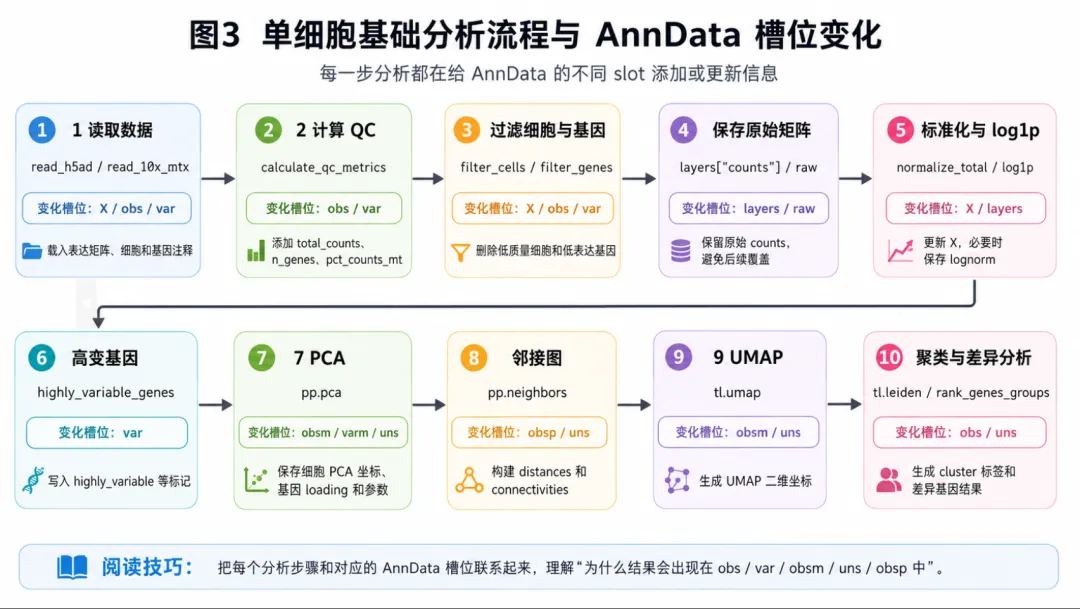
理解 AnnData 最好的方法,就是把它和单细胞分析流程结合起来。
下面用一个基础单样本流程,把 AnnData 每一步发生了什么讲清楚。
19.1 读取数据
adata = sc.read_h5ad(”learndata.h5ad”)adata.var_names_make_unique()adata
此时主要有:
adata.X:表达矩阵adata.obs:细胞信息adata.var:基因信息
19.2 计算质控指标
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], inplace=True)
运行后,adata.obs 会增加质控指标:
total_countsn_genes_by_countspct_counts_mt
这一步主要改变的是:
19.3 质控可视化
质控指标计算完成后,可以先画图观察数据分布:
fig, axs = plt.subplots(1, 4, figsize=(15, 4))axs[0].hist(adata.obs[”total_counts”], bins=50)axs[0].set_title(”total_counts”)axs[1].hist(adata.obs[”total_counts”][adata.obs[”total_counts”] < 10000], bins=40)axs[1].set_title(”total_counts < 10000”)axs[2].hist(adata.obs[”n_genes_by_counts”], bins=60)axs[2].set_title(”n_genes_by_counts”)axs[3].hist(adata.obs[”pct_counts_mt”], bins=60)axs[3].set_title(”pct_counts_mt”)plt.tight_layout()plt.show()
这一步不会改变 AnnData 的主要结构,只是帮助我们确定后面的过滤阈值。
19.4 质控过滤
sc.pp.filter_cells(adata, min_counts=5000)sc.pp.filter_cells(adata, max_counts=35000)adata = adata[adata.obs[”pct_counts_mt”] < 20].copy()
这一步会减少细胞数量,也就是:
adata.n_obs 变少adata.X 行数变少adata.obs 行数变少
过滤基因:
sc.pp.filter_genes(adata, min_cells=10)
这一步会减少基因数量,也就是:
adata.n_vars 变少adata.X 列数变少adata.var 行数变少
查看过滤后的细胞数量:
print(f”#cells after filter: {adata.n_obs}”)
19.5 保存原始 counts
在归一化之前,建议保存原始矩阵:
adata.layers[”counts”] = adata.X.copy()
此时:
adata.layers[”counts”] 保存原始 counts
19.6 归一化和 log 转换
sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()
这一步会修改:
因此保存到 layers["lognorm"] 是一个好习惯。
19.7 高变基因
sc.pp.highly_variable_genes( adata, flavor=”seurat”, n_top_genes=2000)
这一步主要在 adata.var 中增加:
highly_variablemeansdispersionsdispersions_norm
可以查看高变基因:
adata.var[adata.var[”highly_variable”]].head()
也可以画高变基因图:
sc.pl.highly_variable_genes(adata)
19.8 PCA 降维
运行后,结果通常保存到:
adata.obsm[”X_pca”]adata.varm[”PCs”]adata.uns[”pca”]
也就是说:
细胞的 PCA 坐标 → obsm基因的 PCA loading → varmPCA 参数和方差信息 → uns
可以查看 PCA 结果:
adata.obsm[”X_pca”].shape
19.9 构建邻接图
运行后,会生成:
adata.obsp[”distances”]adata.obsp[”connectivities”]adata.uns[”neighbors”]
这一步是后续 UMAP 和聚类的基础。
19.10 UMAP 降维
运行后,UMAP 坐标保存在:
画图:
sc.pl.umap( adata, color=[”total_counts”, ”n_genes_by_counts”])
19.11 Leiden 聚类
sc.tl.leiden( adata, key_added=”clusters”)
运行后,聚类结果保存在:
画图:
sc.pl.umap( adata, color=[”clusters”])
这时 adata.obs 中就有了每个细胞所属的 cluster。
19.12 marker 基因识别
基础聚类完成后,可以寻找每个 cluster 的 marker 基因:
sc.tl.rank_genes_groups( adata, groupby=”clusters”, method=”wilcoxon”)
结果会保存到:
adata.uns[”rank_genes_groups”]
提取成数据框:
markers = sc.get.rank_genes_groups_df( adata, group=None)markers.head()
保存结果:
markers.to_csv(”cluster_markers.csv”, index=False)
19.13 保存分析结果
adata.write_h5ad(”single_sample_processed.h5ad”)
下次可以直接读取:
adata = sc.read_h5ad(”single_sample_processed.h5ad”)
20 一个总结表:每一步改变了什么?
21 完整单样本基础流程代码
下面放一份相对完整的单样本基础流程代码,适合作为后续练习模板。
import scanpy as scimport pandas as pdimport numpy as npimport matplotlib.pyplot as plt# 1. 读取数据adata = sc.read_h5ad(”learndata.h5ad”)adata.var_names_make_unique()# 2. 标记线粒体基因# 小鼠数据通常是 mt-,人类数据通常是 MT-adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)# 3. 计算 QC 指标sc.pp.calculate_qc_metrics( adata, qc_vars=[”mt”], inplace=True)# 4. 查看对象print(adata)print(adata.obs.head())print(adata.var.head())# 5. 质控过滤sc.pp.filter_cells(adata, min_counts=5000)sc.pp.filter_cells(adata, max_counts=35000)adata = adata[adata.obs[”pct_counts_mt”] < 20].copy()sc.pp.filter_genes(adata, min_cells=10)print(f”#cells after filter: {adata.n_obs}”)print(f”#genes after filter: {adata.n_vars}”)# 6. 保存原始 countsadata.layers[”counts”] = adata.X.copy()# 7. 标准化和 log 转换sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()# 8. 高变基因sc.pp.highly_variable_genes( adata, flavor=”seurat”, n_top_genes=2000)# 9. PCA / 邻接图 / UMAP / 聚类sc.pp.pca(adata)sc.pp.neighbors(adata)sc.tl.umap(adata)sc.tl.leiden(adata, key_added=”clusters”)# 10. 可视化sc.pl.umap( adata, color=[”total_counts”, ”n_genes_by_counts”, ”pct_counts_mt”, ”clusters”], wspace=0.4)# 11. marker 基因sc.tl.rank_genes_groups( adata, groupby=”clusters”, method=”wilcoxon”)markers = sc.get.rank_genes_groups_df( adata, group=None)markers.to_csv(”cluster_markers.csv”, index=False)# 12. 保存对象adata.write_h5ad(”single_sample_processed.h5ad”)
22 初学者最容易踩的坑
22.1 重复基因名
很多公开数据中可能存在重复基因名。读取数据后建议先运行:
adata.var_names_make_unique()
否则后续分析可能会出现 warning 或报错。
22.2 把 .copy 写成 .copy()
错误写法:
正确写法:
少了括号,adata1 不是复制出来的新对象,而是一个方法本身。
22.3 切片后忘记 .copy()
AnnData 中切片后得到的对象可能只是 view,不是真正独立的 copy。
不推荐:
adata_sub = adata[adata.obs[”pct_counts_mt”] < 20]
推荐:
adata_sub = adata[adata.obs[”pct_counts_mt”] < 20].copy()
尤其是后面要修改 adata_sub.obs 或 adata_sub.X 时,建议一定加 .copy()。
22.4 不清楚当前 adata.X 是什么
分析流程中,adata.X 经常会被修改。因此建议在关键步骤保存不同版本:
adata.layers[”counts”] = adata.X.copy()sc.pp.normalize_total(adata, target_sum=1e4)sc.pp.log1p(adata)adata.layers[”lognorm”] = adata.X.copy()
这样后面需要原始 counts 或 lognorm 数据时,就不会混乱。
22.5 线粒体基因大小写写错
人类数据:
adata.var[”mt”] = adata.var_names.str.startswith(”MT-”)
小鼠数据:
adata.var[”mt”] = adata.var_names.str.startswith(”mt-”)
如果大小写写错,pct_counts_mt 可能全部为 0 或计算异常。
22.6 随意把大矩阵转成普通矩阵
不推荐对大数据直接运行:
因为这样可能会占用大量内存。
更推荐:
adata[:, [”Dusp3”, ”Dusp5”]].to_df()
23 保存和读取 h5ad 文件
分析完成后,可以保存:
adata.write_h5ad(”single_sample_processed.h5ad”)
下次直接读取:
adata = sc.read_h5ad(”single_sample_processed.h5ad”)
.h5ad 的好处是可以把 AnnData 对象中的大多数内容一起保存,包括:
表达矩阵细胞注释基因注释降维结果聚类结果邻接图差异分析结果
所以它非常适合作为 Python 单细胞分析的中间结果文件。
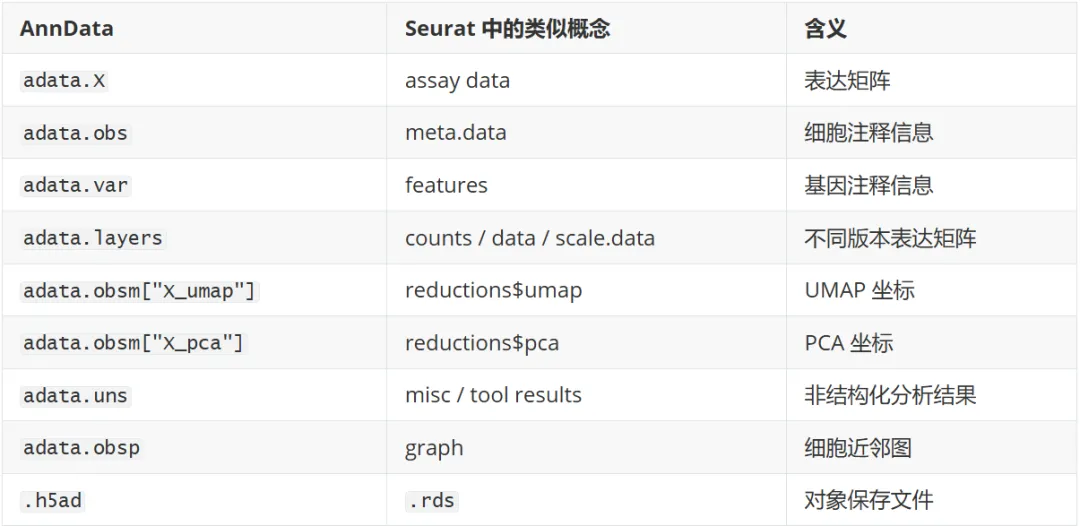
24 AnnData 和 Seurat 对象的简单类比
对于熟悉 Seurat 的同学,可以用下面这个表帮助理解:
这个类比并不是完全一一对应,但对于初学者理解 AnnData 很有帮助。
25 本篇小结
这一篇主要介绍了 Python 单细胞分析中最核心的数据结构:AnnData。
可以用一句话总结:
AnnData 是 Python 单细胞分析中用来统一存储表达矩阵、细胞注释、基因注释和分析结果的核心对象。
其中最重要的结构包括:
adata.X 表达矩阵adata.obs 细胞信息adata.var 基因信息adata.layers 多版本表达矩阵adata.obsm 细胞降维结果adata.varm 基因多维结果adata.uns 非结构化分析结果adata.obsp 细胞关系矩阵adata.varp 基因关系矩阵adata.raw 原始表达备份
对于初学者来说,建议重点掌握:
X、obs、var、layers、obsm、uns、obsp
这几个结构理解清楚之后,再看 Scanpy 的单细胞分析流程就会容易很多。
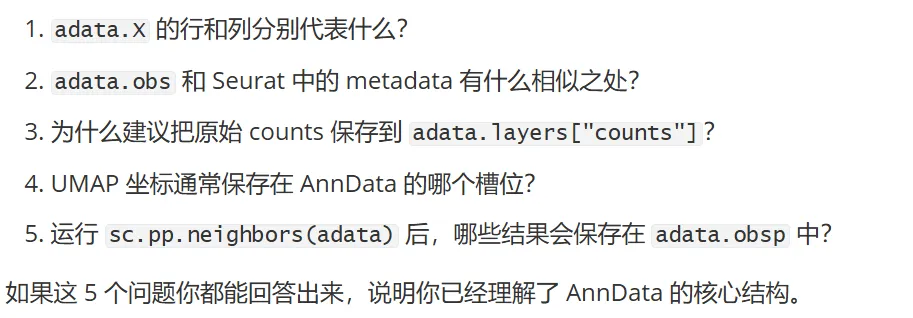
26 学习五问
最后留 5 个问题,帮助大家检查自己是否真正理解了 AnnData:
如果这 5 个问题你都能回答出来,说明你已经理解了 AnnData 的核心结构。
27 下期预告
下一篇我们可以继续介绍:
不同格式单细胞数据的读取方式,以及单细胞基础分析 pipeline。
包括:
10X mtx 文件filtered_feature_bc_matrix.h5h5ad 文件loom 文件csv / tsv 表达矩阵空间转录组 Visium 数据
然后进入完整的单样本基础分析流程:
读取数据质控过滤标准化高变基因PCA邻接图UMAP聚类marker 基因识别细胞类型注释
如果你已经读到这里,说明你已经正式从 Python 基础迈入单细胞分析的核心阶段了。
本篇关键词:Python 单细胞分析、Scanpy、AnnData、adata.X、adata.obs、adata.var、layers、obsm、uns、obsp。
 10个月宝宝每天需要喝多少奶粉?