大家好,我是木木。
今天给大家分享一个DataFrame 校验的 Python 库,pandera。
pandera
pandera 专门处理表格数据校验,最典型的对象是 pandas DataFrame。很多数据任务失败并不是算法问题,而是列名变了、空值混进来、分数越界、分组汇总异常。pandera 把这些规则写成 schema,让 ETL、特征工程、报表生成和数据接口在入口处就能发现问题,而不是等到下游模型或图表报出更难排查的错误。
项目地址:https://github.com/pandera-dev/pandera
官方文档:https://pandera.readthedocs.io
三大特点
列级规则
Column、Field 和 Check 能直接表达类型、范围、空值和字符串约束。
批量错误
lazy=True 可以一次性收集多个失败点,适合数据质量报告。
表级检查
不仅看单列,也能检查跨列、分组和整表统计约束。
最佳实践
安装方式:pip install pandera pandas。建议先从关键数据集的输入边界开始加 schema,再逐步覆盖中间产物。
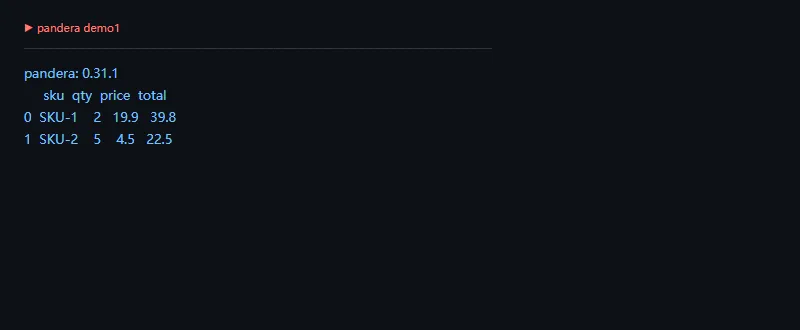
第一段代码解决的问题是:为销售明细表声明列类型和数值边界,校验通过后再继续计算。
fromimportlib.metadataimportversionimportpandasaspdimportpandera.pandasaspafrompandera.typingimportSeriesclassSalesSchema(pa.DataFrameModel):sku:Series[str]=pa.Field(str_startswith="SKU-")qty:Series[int]=pa.Field(ge=1)price:Series[float]=pa.Field(gt=0)df=pd.DataFrame({"sku":["SKU-1","SKU-2"],"qty":[2,5],"price":[19.9,4.5]})validated=SalesSchema.validate(df)print("pandera:",version("pandera"))print(validated.assign(total=validated.qty*validated.price))
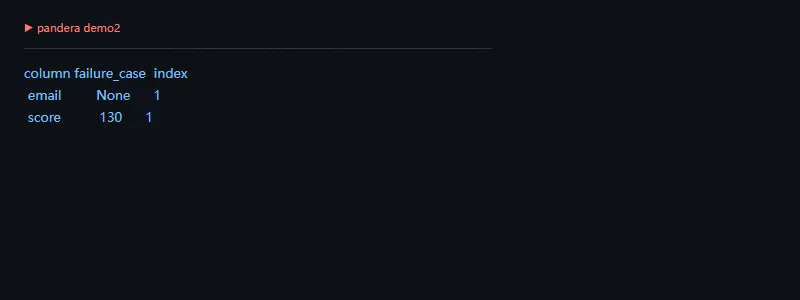
第二段代码解决的问题是:一次性找出多个脏数据点,适合在数据质量检查里输出报告。
importpandasaspdimportpandera.pandasaspaschema=pa.DataFrameSchema({"email":pa.Column(str,nullable=False),"score":pa.Column(int,checks=pa.Check.between(0,100)),})df=pd.DataFrame({"email":["a@example.com",None],"score":[98,130]})try:schema.validate(df,lazy=True)exceptpa.errors.SchemaErrorsasexc:cols=["column","failure_case","index"]print(exc.failure_cases[cols].to_string(index=False))
环境与版本信息
本文示例使用 Python 3.11.0、pandera 0.31.1、pandas 2.3.3。示例在本地 DataFrame 上运行。
高级功能
pandera 的价值在于把数据质量从口头约定变成代码。列级 schema 适合防守字段漂移,表级 check 适合防守统计异常,两者一起用才能覆盖真实数据管道里的大部分事故。
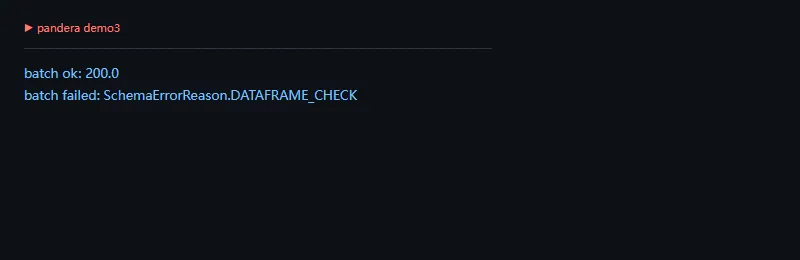
进阶示例解决的问题是:检查整张表的分组约束,避免只做单列规则导致异常批次漏网。
importpandasaspdimportpandera.pandasaspaschema=pa.DataFrameSchema({"team":pa.Column(str),"revenue":pa.Column(float,checks=pa.Check.ge(0)),},checks=pa.Check(lambdadf:df.groupby("team")["revenue"].sum().max()<1000,error="single team revenue too high"))fordfin[pd.DataFrame({"team":["A","B"],"revenue":[120.0,80.0]}),pd.DataFrame({"team":["A","A"],"revenue":[700.0,500.0]})]:try:schema.validate(df)print("batch ok:",df["revenue"].sum())exceptpa.errors.SchemaErrorasexc:print("batch failed:",exc.reason_code)
适用场景
适合 ETL、数据分析脚本、特征工程、批量报表、DataFrame API 入参和训练数据入口。
不适用场景
不适合单个 JSON 对象校验、强领域模型建模,或对极致性能要求高且数据量巨大到无法承受额外校验的热路径。
上线检查
- 在生产任务里记录 failure_cases,方便回溯数据源。
总结
pandera 适合把 DataFrame 从“看起来没问题”变成“经过规则确认”。数据链路越长,它越有价值。
 10个月宝宝每天需要喝多少奶粉?