8 个真正能减少重复代码的 Python 标准库
- 2026-10-11 06:51:00
去年底写过一篇《别再重复造轮子了!Python 这 10 个内置模块真能造》(dis、singledispatch、ast、atexit 等冷门模块巡礼)。那篇侧重"你可能不知道的冷门模块"。今天这篇换一个切口:只讲你会在本周代码里遇到的样板消除器。8 个模块,全是 Python 3.10+ 标准库自带,零依赖,直接 import。验证依据为 cpython 源码和 Python 3.12 官方文档。
每个模块一个 before/after 对比,附上最容易被踩的坑——什么时候不该用它。
01dataclasses — 你的数据类为什么还在手写 __init__
消灭了什么:__init__、__repr__、__eq__ 的手写。
# Before — 15 行样板class Task:def __init__(self, title, assignee, done=False):self.title = titleself.assignee = assigneeself.done = donedef __repr__(self):return f"Task(title={self.title!r}, assignee={self.assignee!r}, done={self.done!r})"def __eq__(self, other):if not isinstance(other, Task): return NotImplementedreturn (self.title, self.assignee, self.done) == (other.title, other.assignee, other.done)# After — 4 行from dataclasses import dataclass@dataclass(frozen=True, slots=True)class Task: title: str assignee: str done: bool = Falseslots=True(3.10+)额外减少 20–35% 内存占用。frozen=True 让实例不可变——配置对象、模型对象的天然选择。
不该用的场景:需要自定义 __init__ 做复杂参数校验或类型转换时,直接写普通类更清晰。dataclasses 的职责是"存数据",不是"做逻辑"。
02functools.cache — 重复计算缓存一行搞定
消灭了什么:手写 dict 缓存 + key 管理。
# Before — 手动缓存_fib_cache = {0: 0, 1: 1}def fib(n):if n not in _fib_cache: _fib_cache[n] = fib(n - 1) + fib(n - 2)return _fib_cache[n]# After — 一行装饰器from functools import cache@cachedef fib(n):if n < 2: return nreturn fib(n - 1) + fib(n - 2)@cache(3.9+)是 @lru_cache(maxsize=None) 的简化版,内部用 dict 存结果,适合纯函数且参数空间有限的场景。注意它不保证线程安全——多线程并发写同一个 @cache 函数时可能出现竞态条件(cpython 只在 maxsize>0 时持有 LRU 链表的锁,maxsize=None 时 dict.setdefault 不加锁)。同一个 functools 里还有 partial(预填函数参数)、@wraps(保留装饰器里的原始函数签名)、reduce(序列累积)。
不该用的场景:函数有副作用(写文件、调 API、读数据库),或者参数空间无界——缓存无限增长会吃满内存。此时换 @lru_cache(maxsize=256) 加个上限。
03itertools — 你还在一层层嵌套 for 吗
消灭了什么:2–3 层嵌套 for + 手动 append。
# Before — 6 行嵌套pairs = []for color in ["red", "blue", "green"]:for size in ["S", "M", "L"]: pairs.append((color, size))# After — 1 行from itertools import productpairs = list(product(["red", "blue", "green"], ["S", "M", "L"]))关键在"惰性"——product 返回迭代器不创建中间列表,内存 O(1) 而非 O(n)。上面的代码包在 list() 里是为了展示结果——实际使用时如果不需要全部组合,不要转 list(),保持惰性才能省内存。chain 展平多层可迭代对象,combinations 生成组合,groupby 按键分组。
不该用的场景(踩坑率最高):groupby 要求输入预先按 key 排序,否则静默丢数据。
04collections — defaultdict 消灭"if key not in dict"
消灭了什么:每次访问 dict 前的防御检查。
# Before — 每次都得检查counts = {}for word in words:if word not in counts: counts[word] = 0 counts[word] += 1# Afterfrom collections import defaultdictcounts = defaultdict(int)for word in words: counts[word] += 1Counter(words) 比 defaultdict(int) 更终极——一行搞定计数。deque(maxlen=n) 是固定窗口 FIFO 队列,namedtuple 是轻量不可变数据容器。
不该用的场景:defaultdict 访问不存在的 key 时会自动创建并插入,这是副作用。在需要严格 key 校验的场景(比如读取配置时不应接受非预期 key),用普通 dict + .get() 更安全。
05pathlib — 别再 os.path.join 了
消灭了什么:os.path.join() 的字符串拼接地狱。
# Before — 跨平台易错import ospath = os.path.join("data", "logs", "app.log")with open(path) as f: ...# After — / 运算符 + 对象方法from pathlib import Pathpath = Path("data") / "logs" / "app.log"text = path.read_text(encoding="utf-8")files = list(Path("logs").glob("*.log"))/ 运算符(__truediv__ 重载)比字符串拼接直观得多。glob() 返回生成器,read_text()/write_text() 一行搞定读写。
不该用的场景:与 C 扩展交互时,大部分期望 str 而非 Path 对象,需显式 str(path)。WindowsPath 和 PosixPath 跨平台行为有细微差异。
06enum — 用类型安全替代魔法字符串
消灭了什么:散落各处的字符串常量。
# Before — 拼写错误只能在运行时发现def handle(status):if status == "pending": ...elif status == "running": ...elif status == "done": ...# After — IDE 补全 + mypy 在编译期拦住from enum import Enum, autoclass Status(Enum): PENDING = auto() RUNNING = auto() DONE = auto()def handle(status: Status):if status == Status.PENDING: ...auto() 消除手动编号,StrEnum(3.11+)让枚举值自动兼容字符串接口。
不该用的场景:枚举值需要运行时动态注册(比如插件系统从配置文件加载状态),enum 的静态特性反而是限制。
07contextlib — 上下文管理不需要写类
消灭了什么:为了一行 with 写完整的 __enter__ / __exit__ 类。
# Before — 10 行类class timer:def __enter__(self):self.start = perf_counter()return selfdef __exit__(self, *args):self.elapsed = perf_counter() - self.start# After — 生成器函数from contextlib import contextmanagerfrom time import perf_counter@contextmanagerdef timer(): start = perf_counter()yieldprint(f"elapsed: {perf_counter() - start:.3f}s")contextlib.suppress(ValueError) 一行消掉 try: ... except ValueError: pass 的空异常处理块。
不该用的场景:上下文逻辑复杂到需要多个 yield 或异常恢复分支时,老老实实写类。@contextmanager 只能 yield 一次,切分支不是它的强项。
08textwrap — 多行字符串别再手调缩进了
消灭了什么:多行字符串前面那个对齐噩梦。
# Before — 手动调缩进,一改内容就歪def help():return "Usage: mytool [OPTIONS]\n\n" \"Options:\n" \" -h, --help Show this message\n" \" -v, --verbose Verbose output"# After — dedent 自动移除公共前导空白from textwrap import dedentdef help():return dedent("""\ Usage: mytool [OPTIONS] Options: -h, --help Show this message -v, --verbose Verbose output""")嵌在函数里的多行字符串不用再为了对齐缩进破坏可读性。textwrap.shorten("长文本", width=40, placeholder="...") 一行替代手动截断 + 拼接省略号。
不该用的场景:dedent 假设所有行共享相同的前导空白模式——如果多行字符串内部缩进不一致(比如混合了 tab 和空格),结果不可预测。
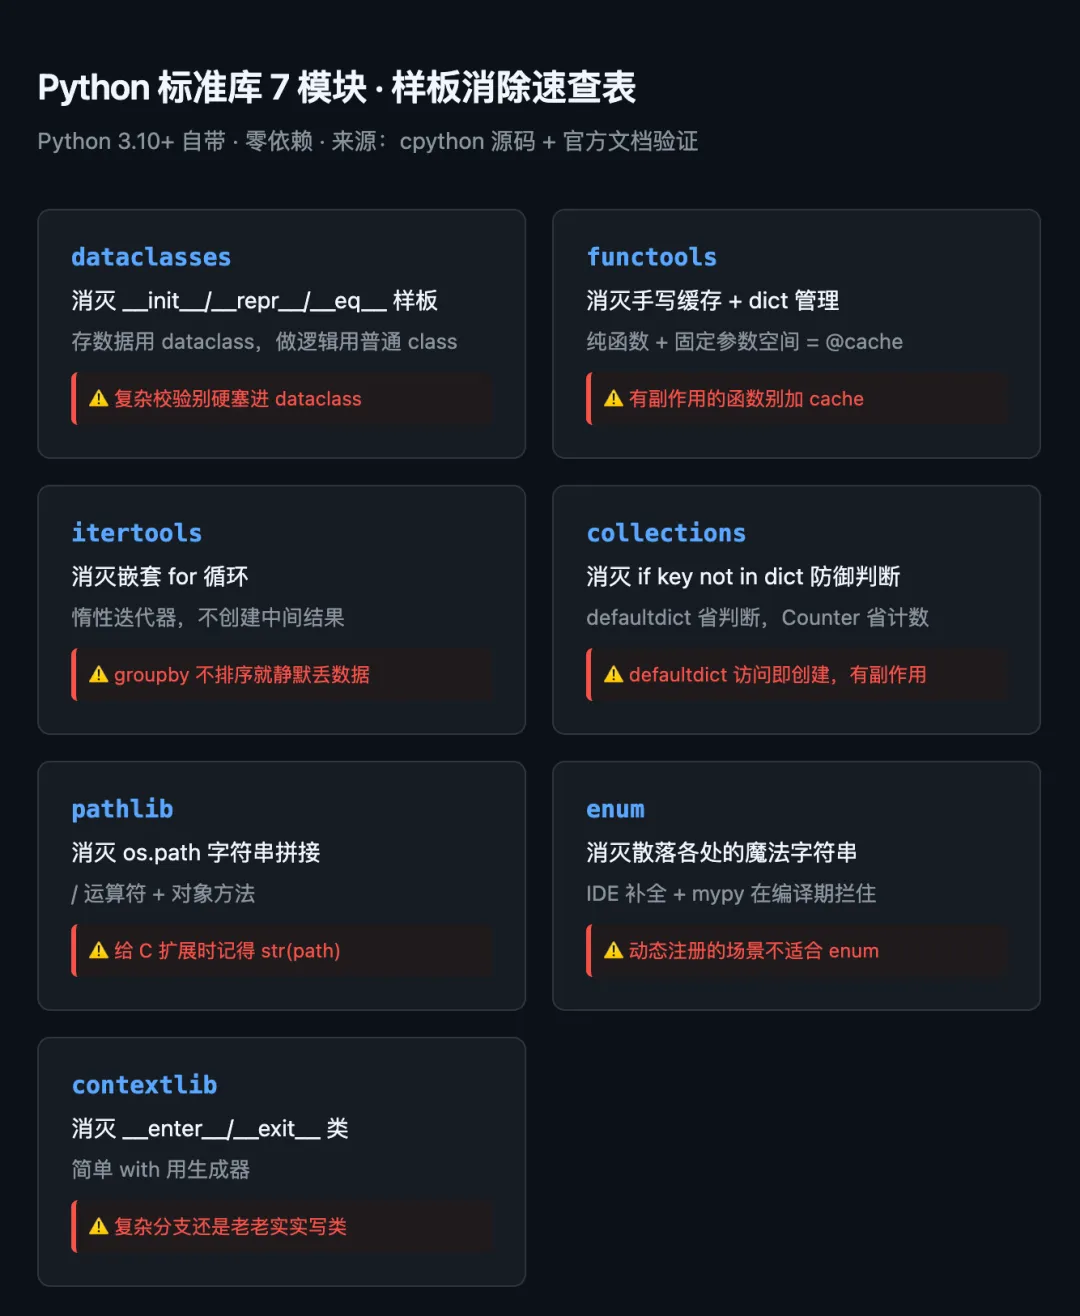
09写在最后:一图胜千言

随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Python List 列表元素替换终极攻略:精准替换、条件替换、批量替换、避坑大全
- Python中的装饰器是什么?
- Python开发从零开始-49.1-数据库操作
- Python 高频题:3 步判断一个数是不是质数
- Playwright Python 从零到实战 · 04
- PHP 开发者 AI 进阶路线图
- 全网 Linux 命令总结,建议收藏!
- RK3506嵌入式Linux定制开发(二):安装虚拟机vmware Player
- 11 款带有微软签名的老旧 Linux UEFI Shim 可被攻击者用于绕过安全启动
- 【幽灵漏洞】Linux核心7.1修补长达15年的漏洞GhostLock