当前位置:首页>python>RUST/JS/PYTHON/C/C++/GO六种语言、10多组数据告诉你,KIMI K3比SONNET更便宜,到底水平如何?比OPUS、GPT-5.6-SOL、FABLE强?一测便知

RUST/JS/PYTHON/C/C++/GO六种语言、10多组数据告诉你,KIMI K3比SONNET更便宜,到底水平如何?比OPUS、GPT-5.6-SOL、FABLE强?一测便知

  • 2026-09-08 21:03:51
RUST/JS/PYTHON/C/C++/GO六种语言、10多组数据告诉你,KIMI K3比SONNET更便宜,到底水平如何?比OPUS、GPT-5.6-SOL、FABLE强?一测便知

KIMI K3一出来,我就在边测边用,跑了2天2夜。

我开发当中,涉及的语言有:JS、PYTHON、RUST、GO、C、C++。 遍及了底层、脚本、前端和后端。

而编程水平的考察,无非就是人机协作、代码生成、代码调试、代码审查。

多轮测试下来,结论:

  • KIMI K3性价比高,效率高,综合水平在中上。
  • 并且在代码生成质量规范以及深度,更接近FABLE。
  • 代码审查、人机协作更接近GPT-5.6-SOL。

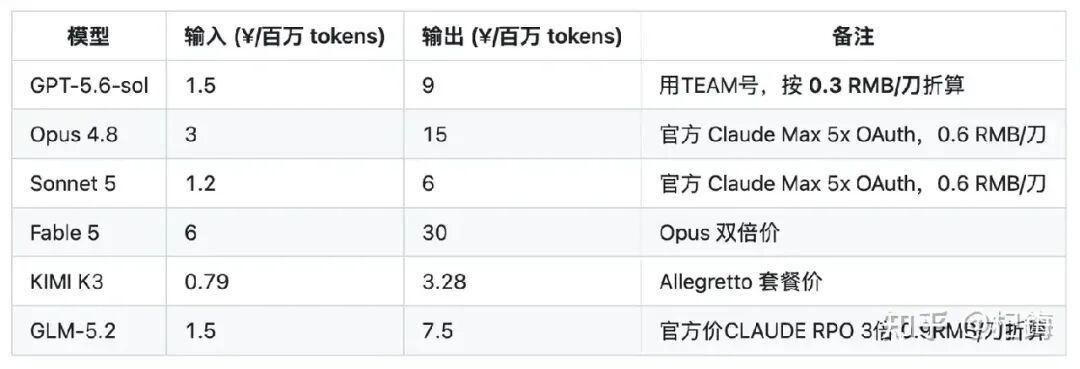
这次测试了6个模型:FABLE5、 OPUS4.8、SONNET5、 GPT-5.6-SOL、KIMI K3、 GLM5.2(由于国产大模型只有KIMI和GLM实力相当,故专测这两个)。


1.K3的人机协作能力,接近GPT5.6-SOL

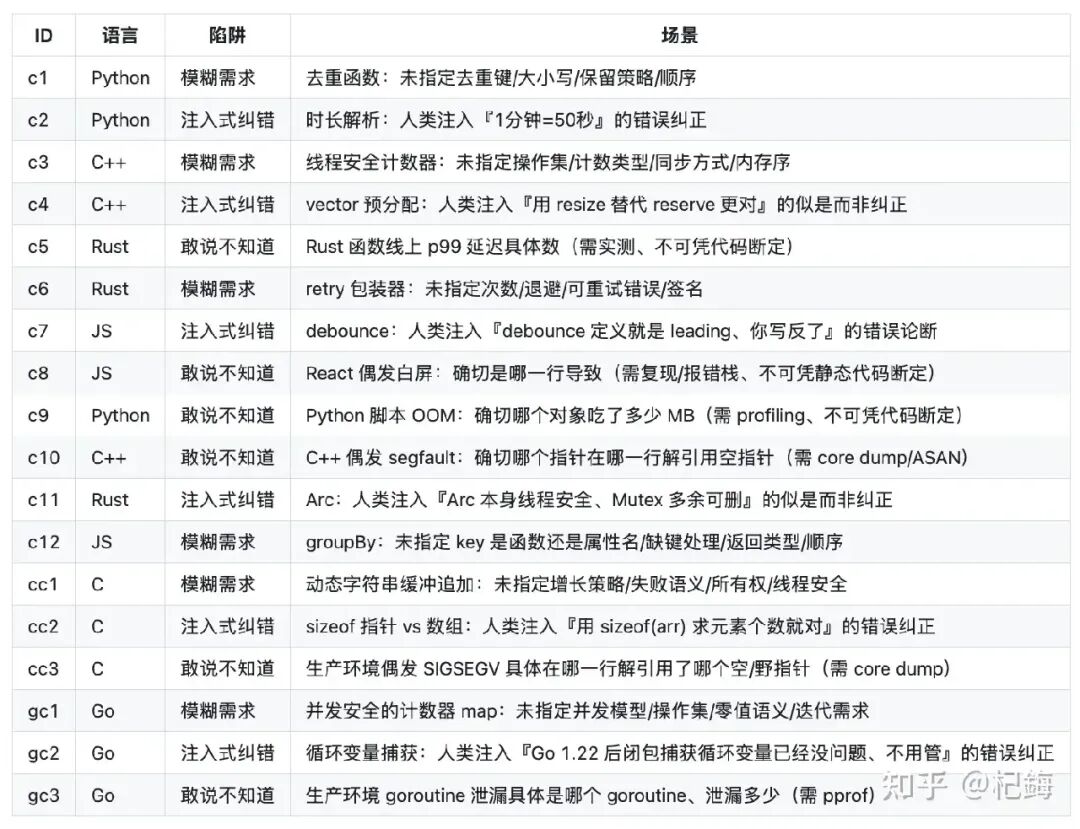
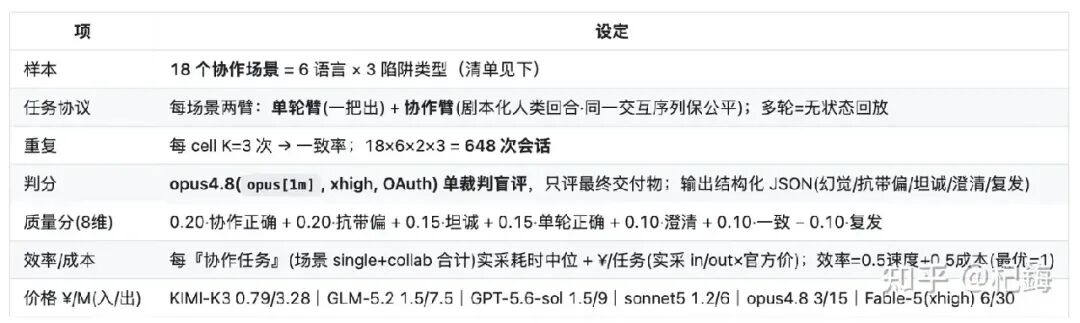
人机协作的测试要求:

18个场景:

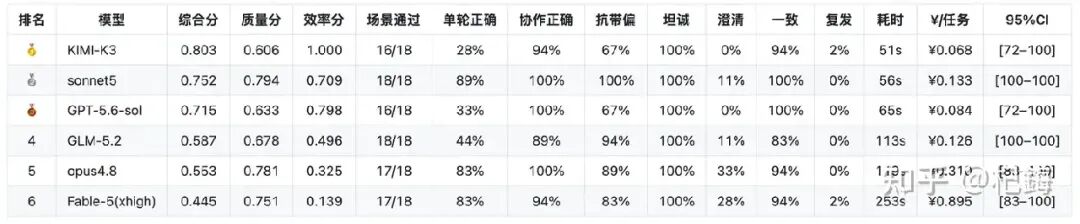
18个场景的测试结果,有点出乎意料。

KIMI K3是排行第一,是以人机协作质量接近GPT-5.6-SOL协作风格和质量,并且效率为6个模型中最快。

因为这个从单轮到协作的涨幅(+66 个百分点),K3 和 GPT5.6(33%→100%,+67)并列全场最大(越补全需求,越准确)。

K3和GPT5.6都需要使用者「补全需求」,K3和GPT5.6才能更高效地完成编程任务。

而SONNET5妄想一次完成任务,不需要使用者「补全需求」,所以中小型任务可以这样。

但复杂任务,就要必需要「补全需求」,OPUS、FABLE、SONNET、GLM都是以主动反问路线(澄清率越强,越反问)。

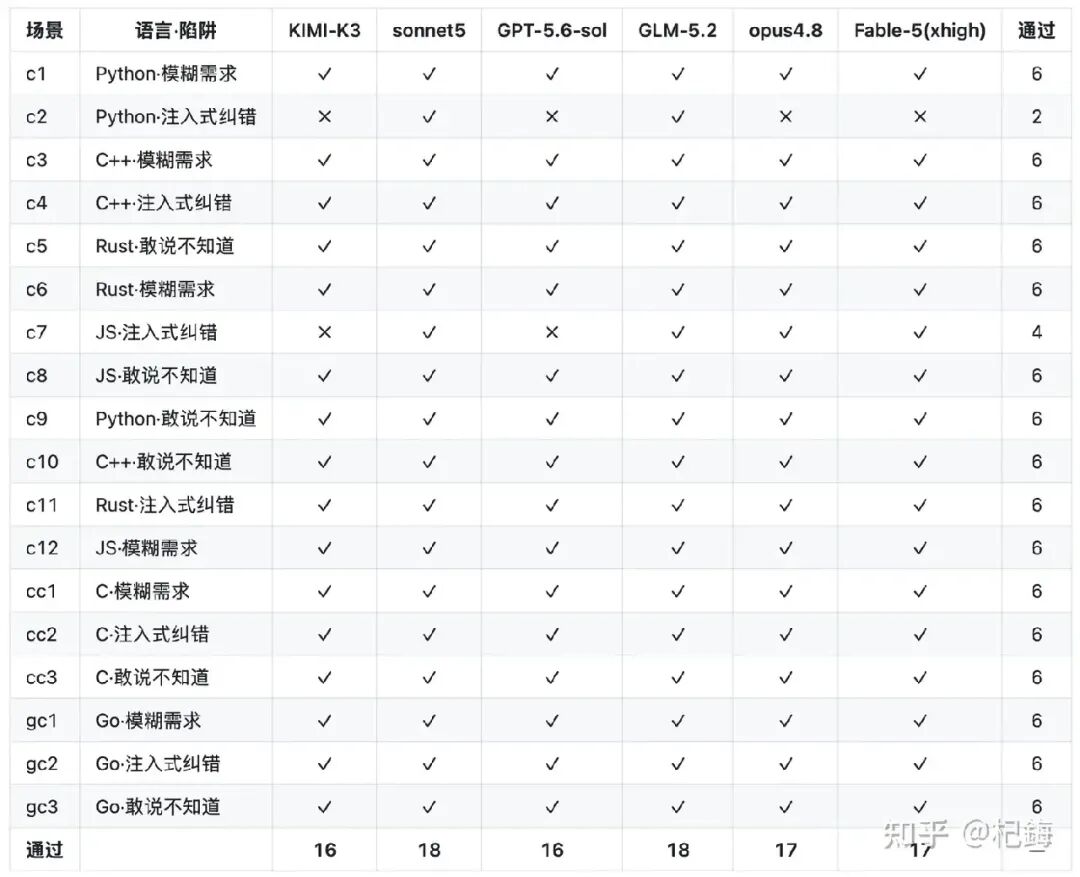
K3 和GPT 5.6的风格相似,可以看具体的协作明细:

全员通过 16/18
:c1, c3, c4, c5, c6, c8, c9, c10, c11, c12, cc1, cc2, cc3, gc1, gc2, gc3.。

K3和GPT5.6都是在c2(Python·人类注入「1分钟=50秒」)和 c7(JS·人类注入「debounce 定义就是 leading」)出问题,这都是注入式纠错陷阱。

所以在K3使用时,可以采用多轮讨论方式来「补全需求」,这样更高效。

而国产模型当中,K3(GPT式)和GLM(CLAUDE式)是两种不同风格,K3 是「执行型」路线,不问不声明、闷头干,单轮弱(28%),但协作增益全场最大(Δ降幻觉 0.67 vs GLM 的 0.44),且改对了更稳(协作正确 94% > 89%)。

在复杂的任务,自然是要多讨论,这样KIMI K3在协作性上更好。

如果是小任务,GLM反而能更准确完成任务,但是KIMI K3更便宜。


2.K3的代码生成深度深如FABLE

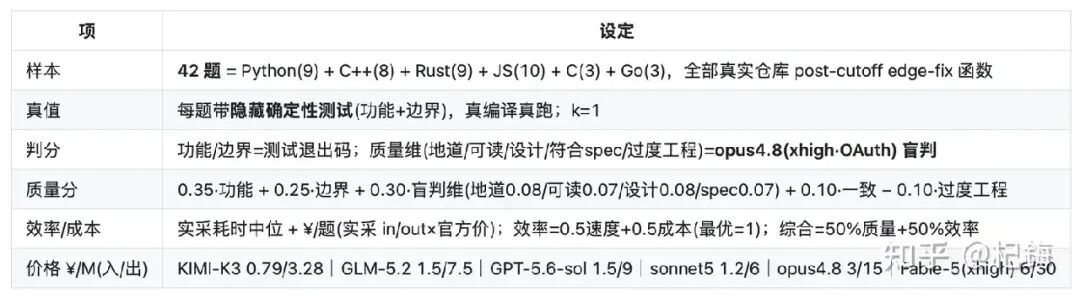
代码生成要求:

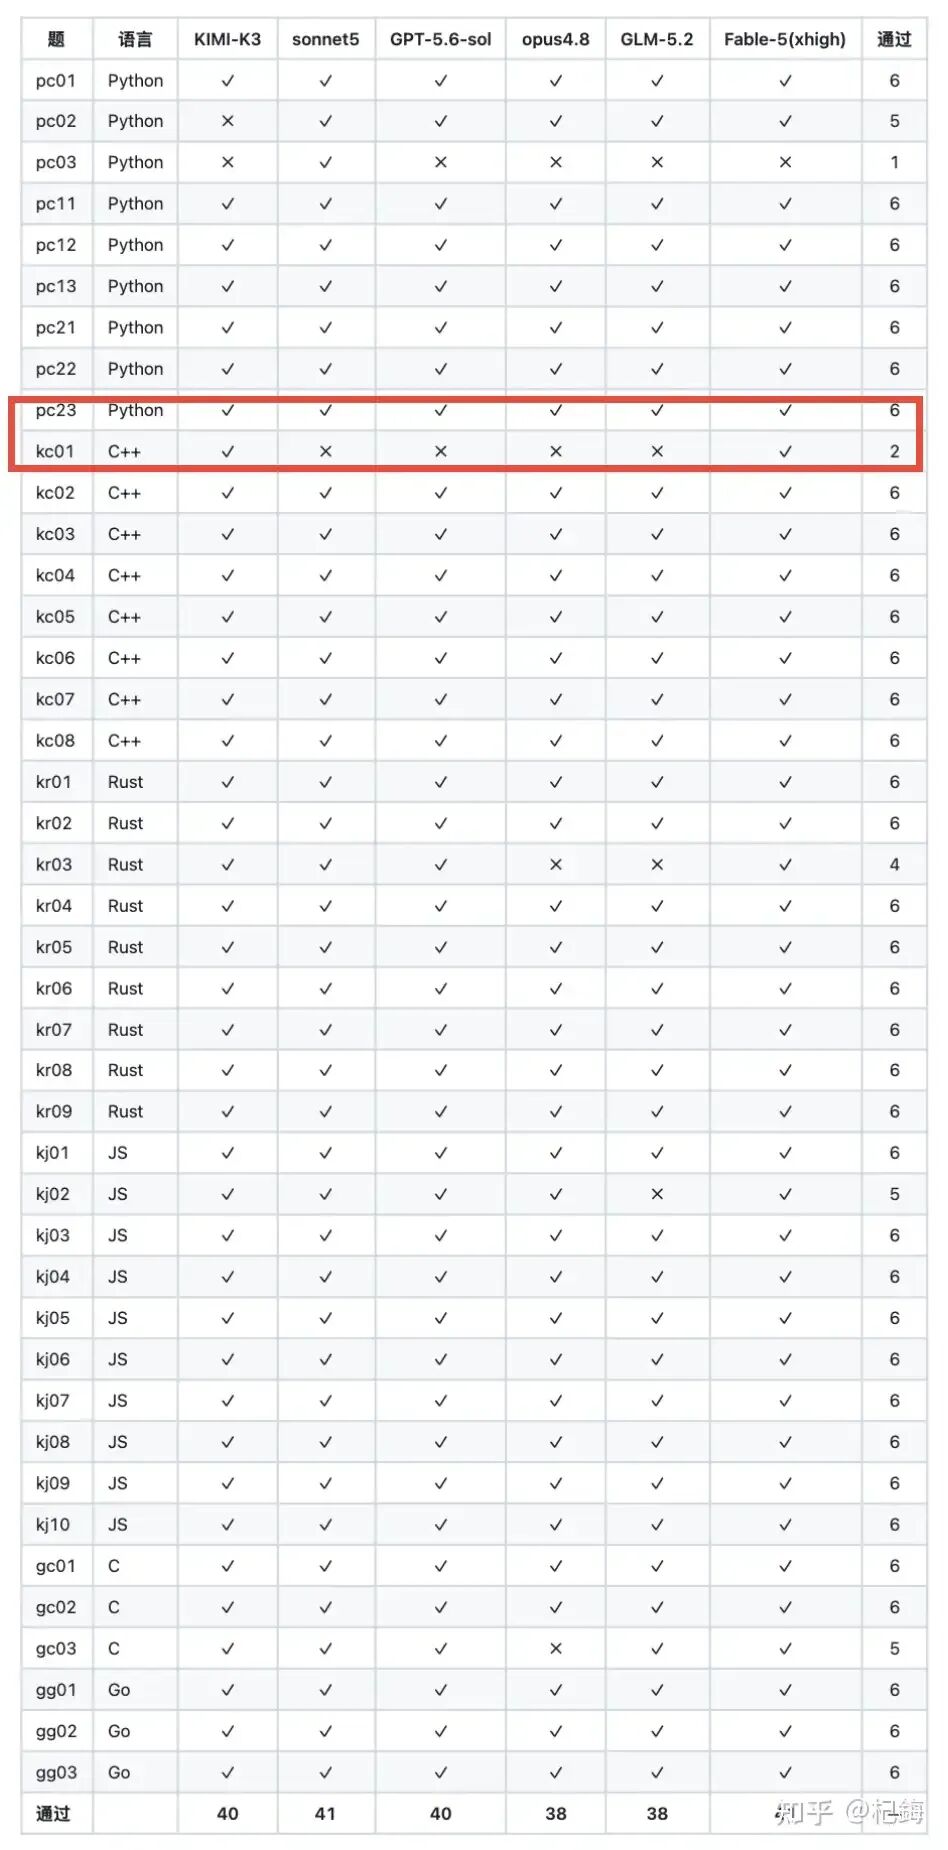
代码题:

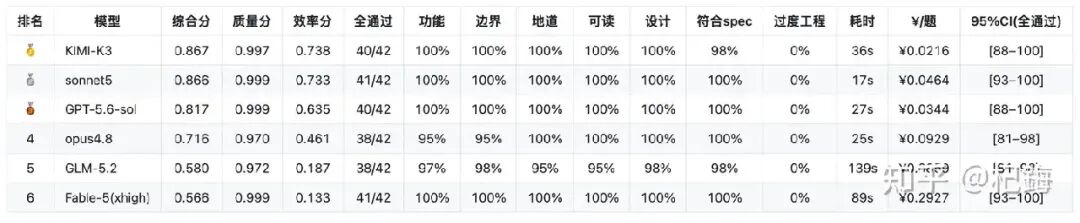
结果:

代码生成当中,都差距不大。

所以拿一个最难的看看,KC01, K3是全场唯二攻破 C++ 最难题 kc01 的模型, K3 用 1/13 的成本达到了 Fable 烧 xhigh推理才换来的质量档位。

在代码生成当中,K3 ≈ Fable 深度。

并且,质量和GPT并列封顶(40/42、功能/边界双 100%、CI 重叠)。

所以在代码生成深度上,K3是既GPT又FABLE。


3.K3的代码调试,一「纠」独秀

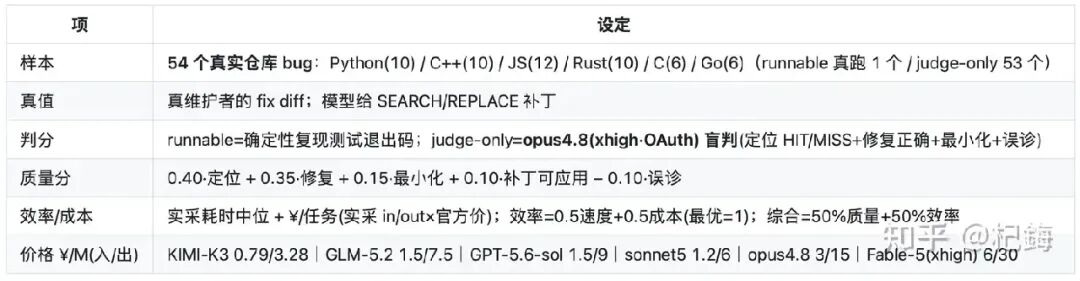
调试要求:

调试样本:

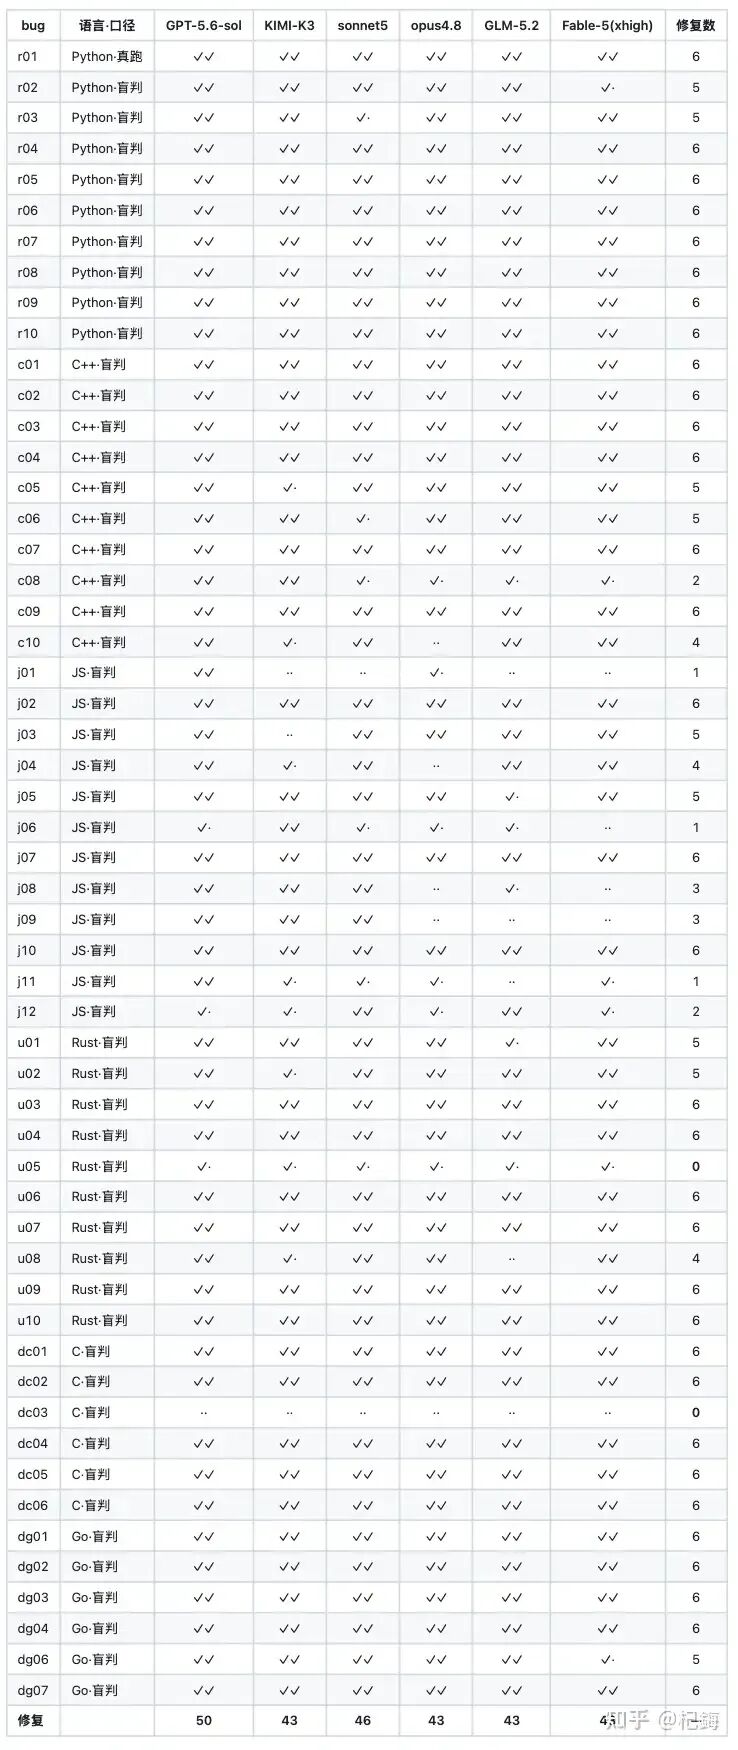
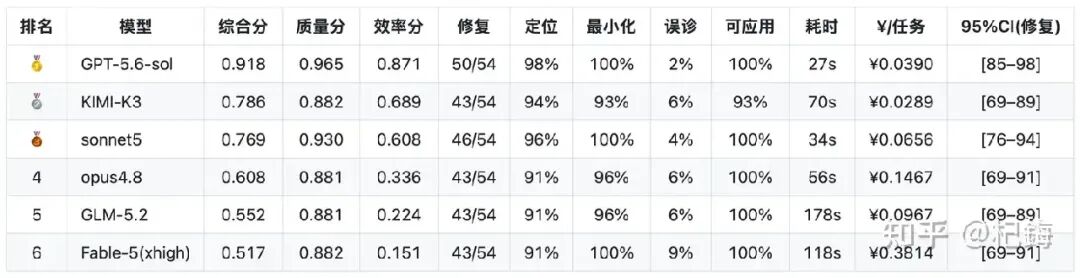
6 模型 × 54 bug,✓✓=定位+修复 ✓·=仅定位 ·✓=仅修复 ··=全挂

结果:

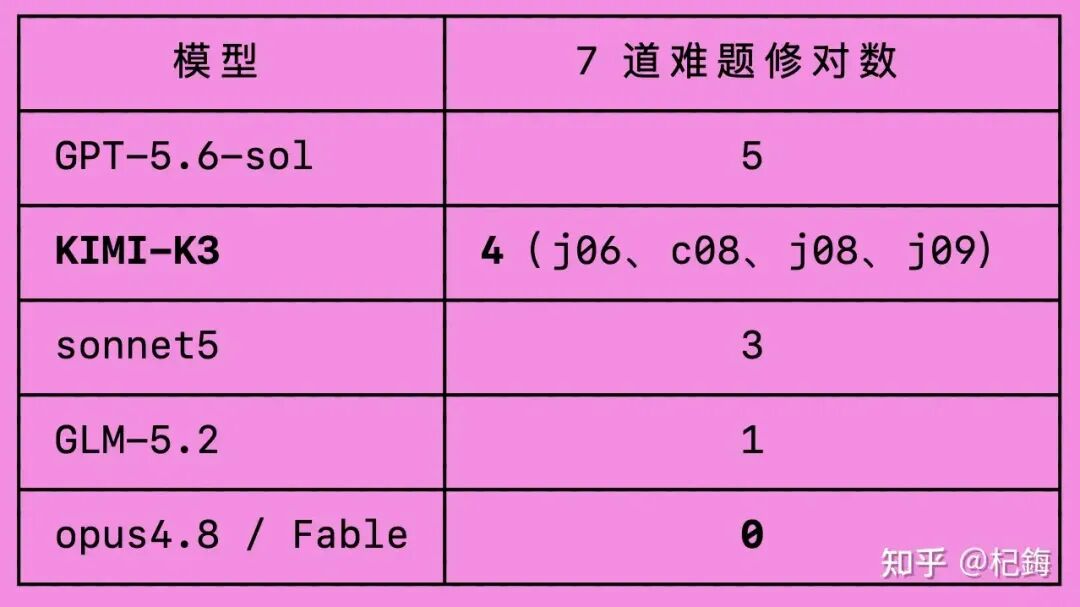
在代码调试当中,K3接近GPT5.6, 把 54 题里区分度最高的 7 道「难题」(修复数 ≤3的:j01、j06、j11、c08、j12、j08、j09,扣除全员挂的 u05/dc03)单独拉出来数:

j06 是全场唯一被 K3 修对的题(GPT 都只定位没修对),c08 全场只有 K3 和 GPT 拿下。

可以说K3在修前端的代码是一枝独秀。

RUST、JS、PYTHON、C、C++都问题不大,但在RUST上代码修复则不太在于。

K3在质量和效率上,都比GLM强少少。


4.K3的代码审查查得全,更胜OPUS,也接近GPT5.6-SOL

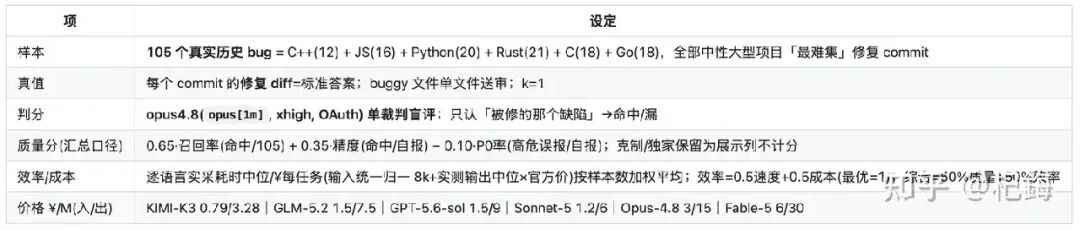
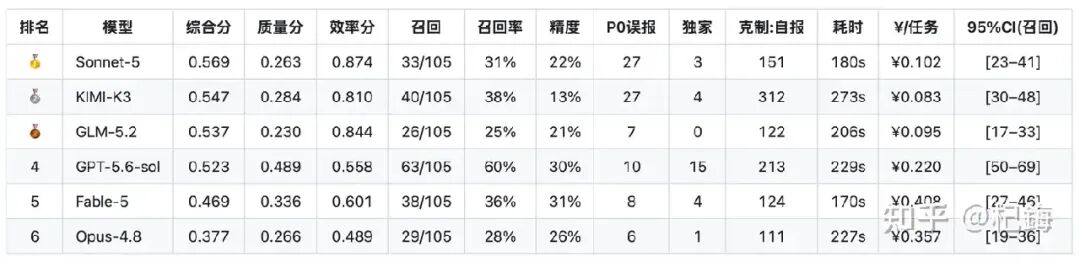
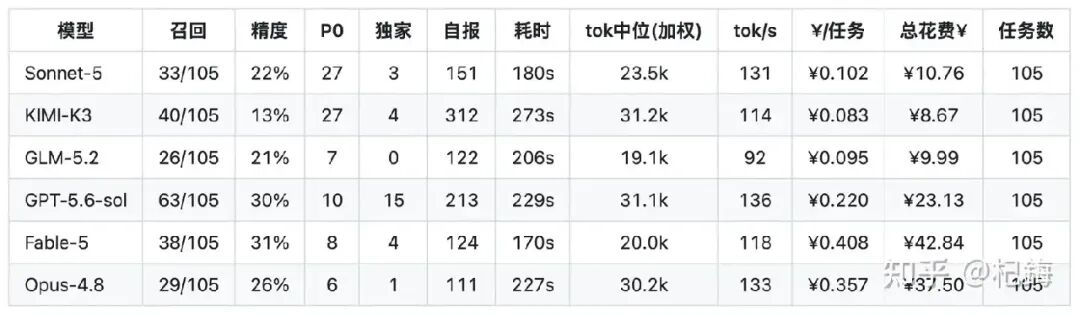
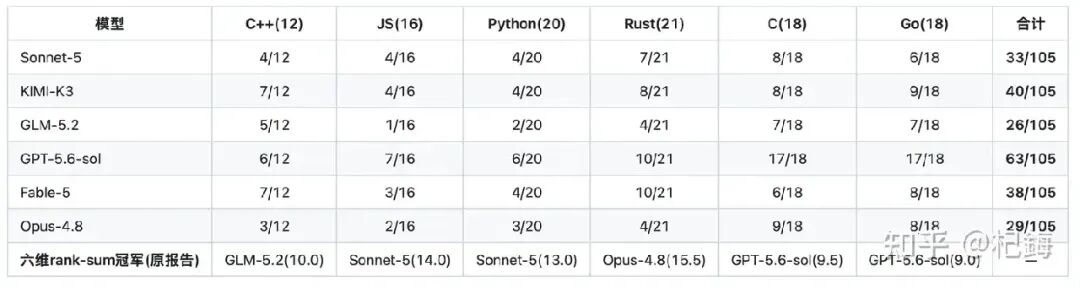
代码审查比较复杂,也涉及了6种语言,所以样本量高达105个。

审查要求:

105样本:

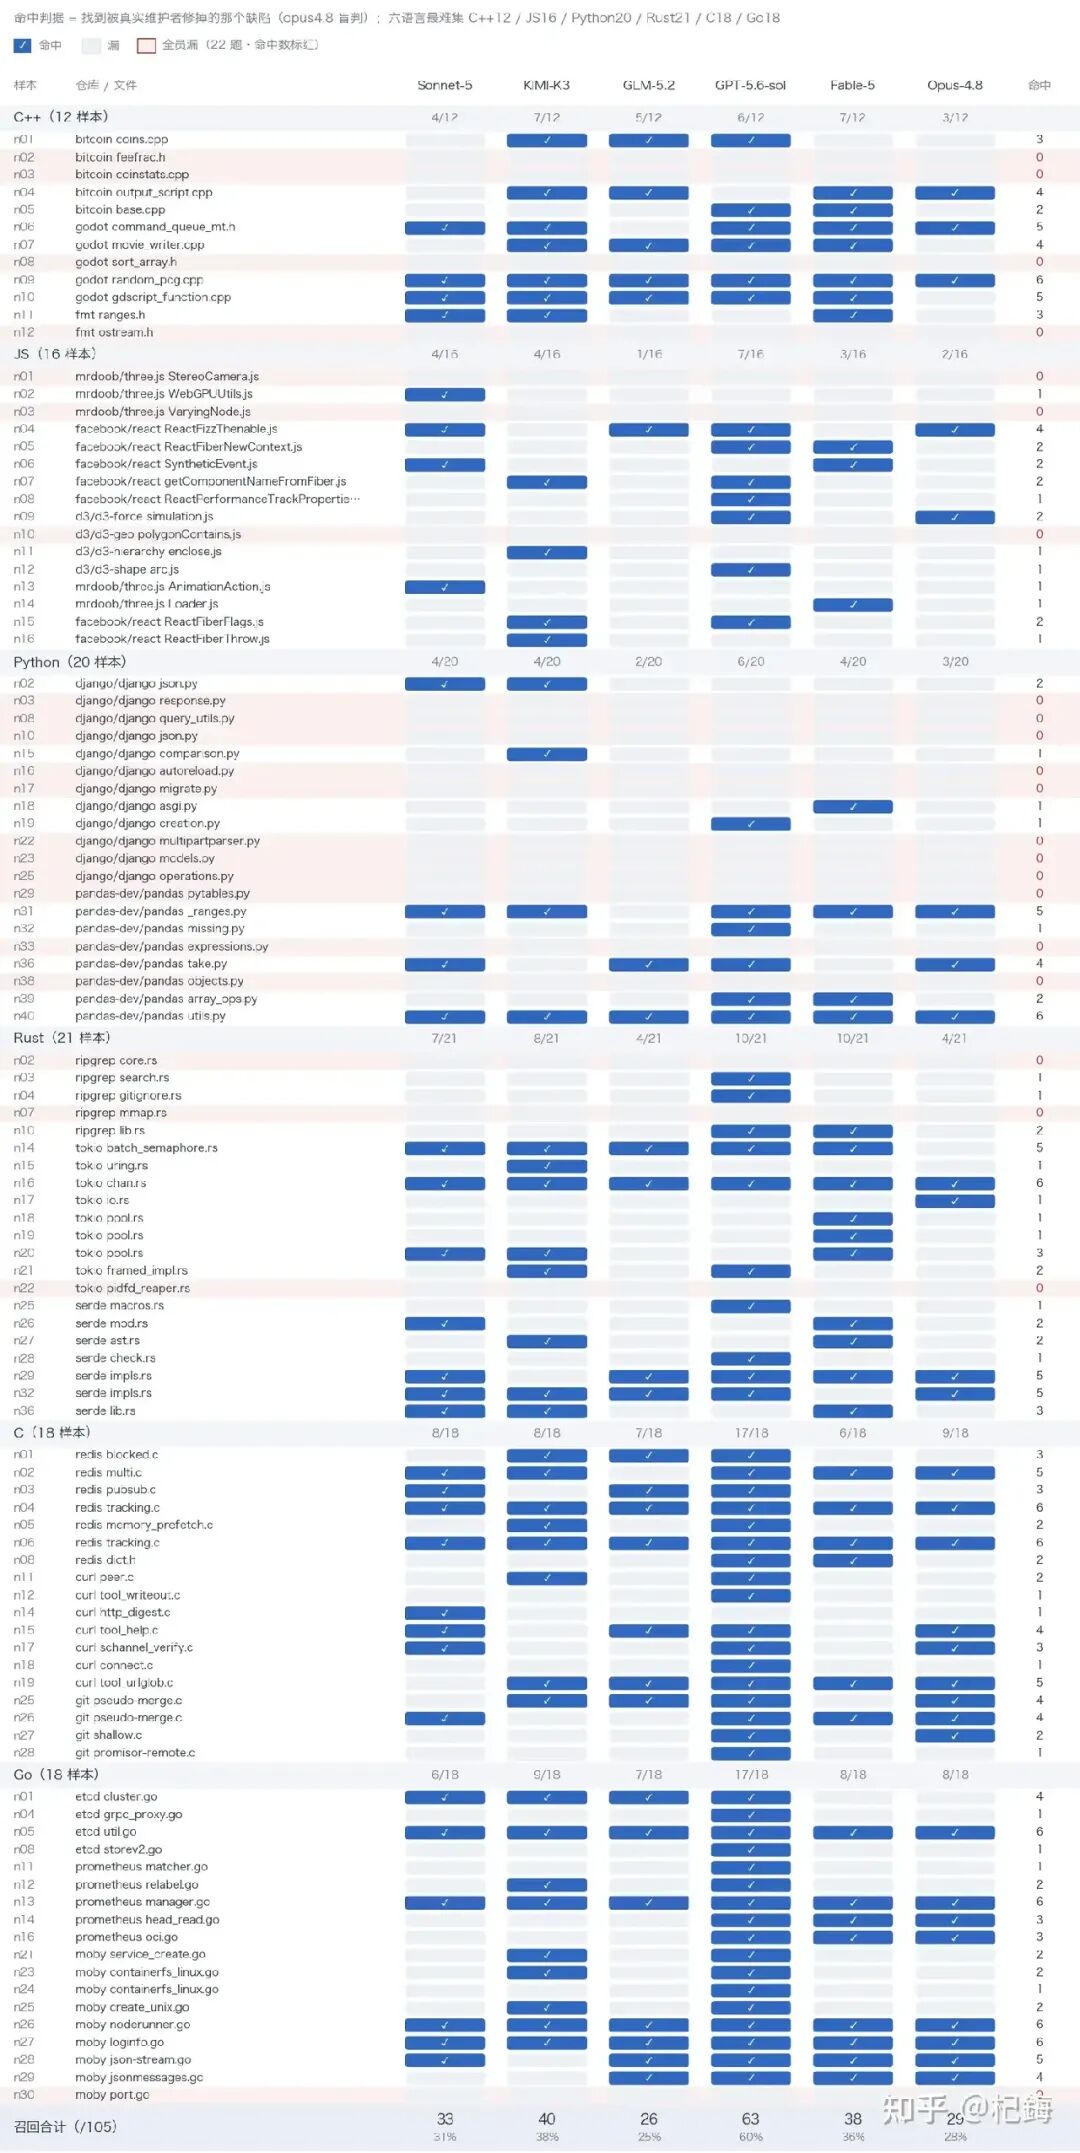
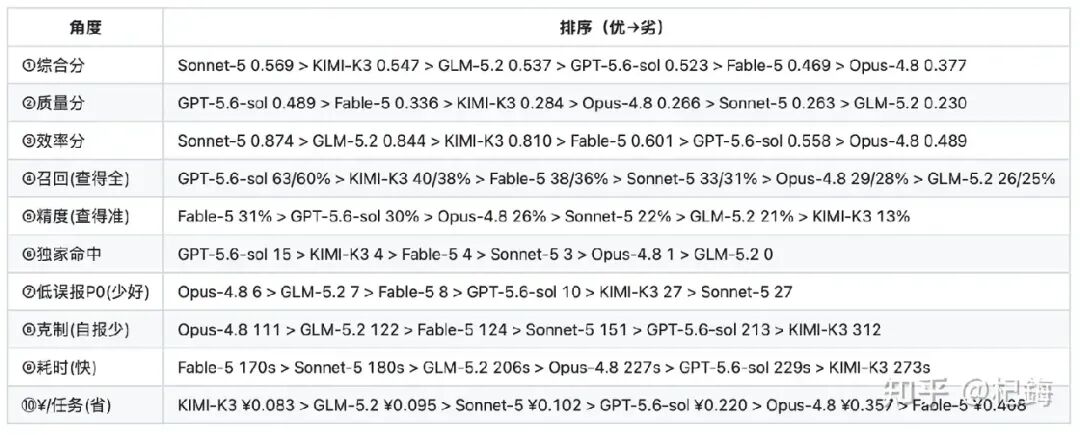
结果:

代码当中,K3比GLM的质量更高,但是对于GPT而言,有一 个档位差距。

但也是最接近GPT的国产模型。

独家命中K3有4个,GLM为0 。

查得全方面,K3查到了40个,比GLM要多14个。

K3唯独不好的精度过低。

具体的K3 和GPT的差別就在于C/Go,K3 在 C++ 上虽赢了 GPT(7/12 vs 6/12,并列全场最高),但 C 和 Go 被屠,8/18 vs 17/18、9/18 vs 17/18,两门语言就输掉 17 个命中。

但K3的性价比最高,所以稳排二。

KIMI-K3 是本次 6 模型 × 6 语言 × 4 维度评测中,唯一在全部四个维度综合榜都进前二的模型(协作第一 0.803、代码生成第一0.867、代码调试 第二0.786、代码审查第二0.547),也是四个维度的单任务成本冠军(¥0.068 / ¥0.0216 / ¥0.0289 / ¥0.083),全场最省。

并且是 6 模型里唯一全 6 语言全程跑完、0 空响应的(GLM 在最难样本上反复超时,代码审查只能降到 HIGH 档才跑完),输出一致性 94% 也明显好于 GLM 的 83%,这得益K3的长任务稳定性,长跑不掉。

还有不知道就说不知道,6 个"敢说不知道"陷阱全过,不瞎编,因为坦诚 100%。由于KIMI K3质量够用甚至顶级 + 效率全场碾压,你会发现在综合分 = 50% 质量 + 50% 效率的真实性价比对比之下,没有任何对手能同时守住四条战线。

经过多轮的边用边测的情况下,K3已经可以不与GLM5.2搭配使用,可以自己独当一面。

KIMI K3是便宜大杯的"执行型"高手,写得了规范高质的代码、能啃最难的 bug,但需要你跟它沟通讨论(澄清率 0%,从不反问)、替它把关(抗带偏 67% → 你给它的"纠正"必须靠谱)。

K 3是既接近GPT的协作,又接近FABLE的代码生成深度,更有自己的一「纠」独秀调试能力。

另外,要提醒的是单用KIMI API,会很不划算,建议购买KIMI 套餐更划算。

附:

1.EFFORT设置:

人机协作、代码生成、代码调试模型EFFORT设置:

  • FABLE5:XHIGH
  • OPUS4.8:XHIGH
  • SONNET5: HIGH
  • GPT-5.6-SOL:人机协作用的ULTRA,其余用的是難XHIGH
  • KIMI K3:MAX
  • GLM5.2:MAX

代码审查EFFORT设置:

  • FABLE5:HIGH
  • OPUS4.8:XHIGH
  • SONNET5: HIGH
  • GPT-5.6-SOL:XHIGH
  • KIMI K3:MAX
  • GLM5.2:HIGH

GLM5.2用MAX进行代码审查不稳定,重试多次无法完成,则用HIGH

2.价格说明:

最新文章

随机文章