新人公众号制作实属不易😭
希望有所收获的宝子们多多支持
↓ ↓ ↓ ↓ 后续会更新更多干货内容
Python 基础知识:字典——别再靠位置猜数据
数据越来越多时,你还记得“第三项”代表什么吗?
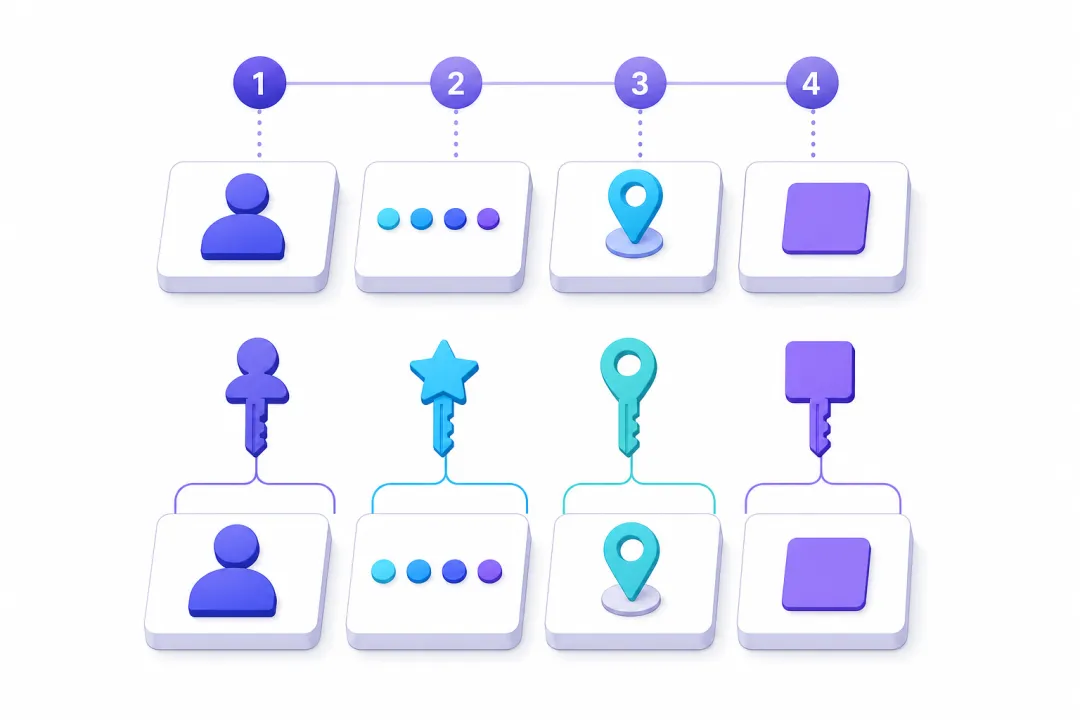
假设要保存一位学生的姓名、年龄和成绩。如果写成列表,必须额外记住索引 0、1、2 分别代表什么。字段继续增加后,“靠位置猜数据”很容易拿错值。
Python 的字典 dict提供了更清晰的方式:不再问“第几项”,而是通过具有含义的键找到对应的值。
这篇文章会从创建、访问和增删改查讲起,再进入遍历、推导式、嵌套结构、复制、合并和词频统计等真实用法。
一、字典是什么?
字典是一种使用键值对管理数据的映射类型。每个键对应一个值,基本写法是 {key: value}。
1student = {
2"name": "Austin",
3"age": 18,
4"score": 95,
5}
6
7print(student["name"])
8print(student["score"])
Austin
95
冒号左侧是键 key,用于标识数据;右侧是值 value,保存具体内容。多个键值对之间使用逗号分隔。
二、创建字典与键值规则
1. 使用花括号
1empty = {}
2profile = {
3"name": "小明",
4"age": 18,
5"skills": ["Python", "Excel"],
6}
7
8print(type(empty))
空花括号 {} 创建的是空字典,而不是空集合。空集合需要写成 set()。
2. 使用 dict()
1user = dict(name="Austin", age=18)
2pairs = dict([("name", "Austin"), ("score", 95)])
3
4print(user)
5print(pairs)
使用关键字参数时,键必须能写成合法的 Python 标识符;使用数字、含空格字符串或元组等其他键时,可以传入键值对序列。
规则 | 说明 | 示例 |
键必须唯一 | 重复键最终只保留一个值 | {"a": 1, "a": 2} 得到 {"a": 2} |
键必须可哈希 | 常用字符串、数字和符合条件的元组 | 列表不能作为键 |
值没有唯一限制 | 可以重复,也可以是任意对象 | 多个键可以同时对应 0 |
保留插入顺序 | Python 3.7 起语言规范保证遍历顺序 | 后添加的键出现在后面 |
键的选择 键应稳定、唯一且具有明确含义。姓名可能重复,不一定适合作为学生数据的唯一键;学号通常更合适。 |
三、访问字典:方括号还是 get()?
使用方括号可以严格访问一个必须存在的键:
1student = {"name": "Austin", "score": 95}
2
3print(student["name"])
4print(student["score"])
如果键不存在,方括号会抛出 KeyError:
1print(student["age"])
KeyError: 'age'
键可能缺失时,可以使用 get():
1student = {"name": "Austin", "score": 95}
2
3print(student.get("age"))
4print(student.get("age", 0))
5print(student.get("name"))
None
0
Austin
方式 | 键存在 | 键不存在 | 适合场景 |
data[key] | 返回值 | 抛出 KeyError | 键在程序逻辑上必须存在 |
data.get(key) | 返回值 | 返回 None | 键可能缺失,且 None 可代表缺失 |
data.get(key, default) | 返回值 | 返回指定默认值 | 需要继续计算或显示默认文本 |
默认值陷阱 get() 返回 None 可能表示键不存在,也可能表示键存在但值本来就是 None。需要严格区分时,使用 key in data 判断。 |
四、添加、修改与批量更新
字典添加和修改使用同一种写法:键不存在就添加,键已经存在就覆盖旧值。
1student = {"name": "Austin"}
2
3student["score"] = 95
4student["score"] = 98
5
6print(student)
{'name': 'Austin', 'score': 98}
update() 可以一次更新多个键值对:
1student = {"name": "Austin", "score": 95}
2
3student.update({"score": 98, "city": "Singapore"})
4student.update(age=18)
5
6print(student)
遇到已有键会覆盖旧值,遇到新键会添加。如果只想在键缺失时填入默认值,可以使用 setdefault():
1settings = {"theme": "dark"}
2
3print(settings.setdefault("theme", "light"))
4print(settings.setdefault("language", "zh"))
5print(settings)
setdefault(key, default) 在键存在时返回原值,不会覆盖;键不存在时才添加默认值并返回它。
五、删除键值对与成员判断
方式 | 作用 | 返回值或风险 |
del data[key] | 删除指定键 | 无返回值;键不存在时抛出 KeyError |
data.pop(key) | 删除指定键 | 返回被删值;可以提供默认值 |
data.popitem() | 删除最后插入的键值对 | 返回 (key, value);空字典会报错 |
data.clear() | 清空字典 | 返回 None |
1student = {"name": "Austin", "score": 95, "city": "SG"}
2
3city = student.pop("city")
4missing = student.pop("age", None)
5del student["score"]
6
7print(city, missing, student)
成员判断有一个高频规则:in 默认检查键,不检查值。
1student = {"name": "Austin", "score": 95}
2
3print("name"in student)
4print(95in student)
5print(95in student.values())
6print(("score", 95) in student.items())
True
False
True
True
六、遍历 keys()、values() 与 items()
方法 | 得到的内容 | 典型遍历 |
keys() | 键视图 | for key in data.keys() |
values() | 值视图 | for value in data.values() |
items() | (key, value) 视图 | for key, value in data.items() |
1student = {"name": "Austin", "score": 95}
2
3for key in student:
4print(key)
5
6for value in student.values():
7print(value)
8
9for key, value in student.items():
10print(key, value)
直接遍历字典等价于遍历键。需要同时获得键和值时,items() 配合元组解包最清晰。
视图不是快照 keys()、values() 和 items() 返回的视图会反映字典后续变化。确实需要独立列表时,可以显式写成 list(data.keys())。 |
七、字典推导式与嵌套字典
字典推导式适合从已有数据生成新的键值映射:
1squares = {number: number ** 2for number inrange(1, 6)}
2
3prices = {"apple": 5, "banana": 3, "pear": 6}
4expensive = {
5name: price
6for name, price in prices.items()
7if price >= 5
8}
9
10print(squares)
11print(expensive)
基本格式是 {key_expression: value_expression for ... if ...}。逻辑包含多步操作或复杂条件时,普通循环通常更容易阅读。
多个学生资料可以使用学号作为外层键,再用内层字典保存每位学生的属性:
1students = {
2"S001": {"name": "小明", "score": 88},
3"S002": {"name": "小红", "score": 95},
4}
5
6print(students["S001"]["name"])
7
8for student_id, info in students.items():
9print(student_id, info["name"], info["score"])
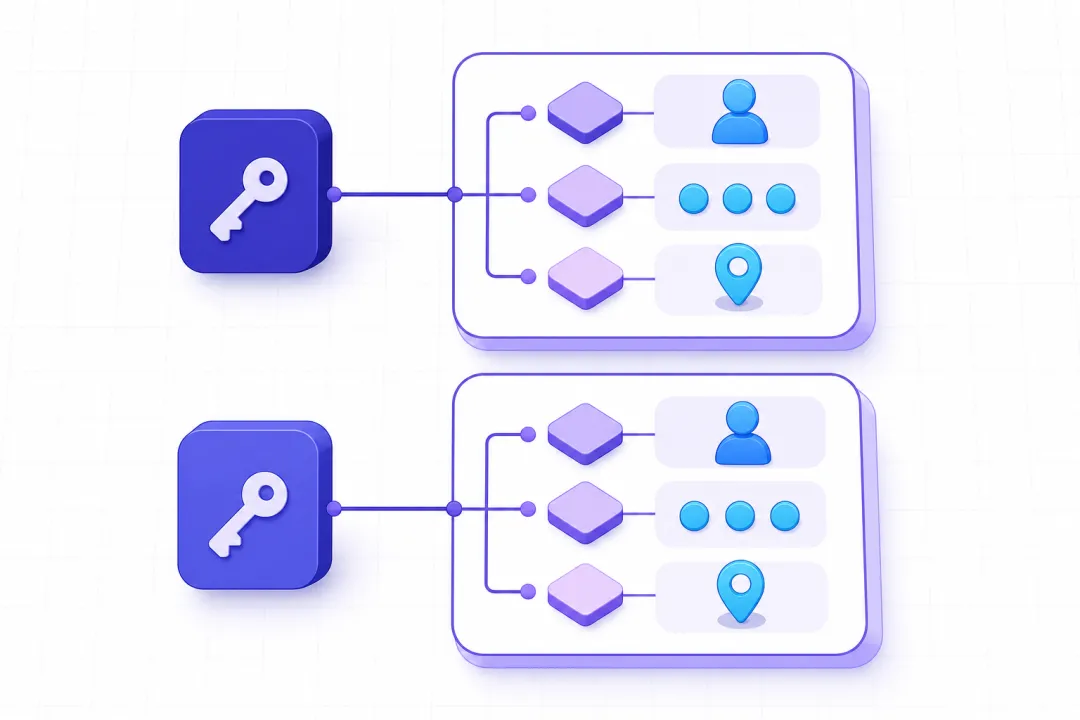
读取嵌套数据时,要逐层确认键是否存在。如果输入数据并不可控,可以结合 get() 和合理默认值,避免某一层缺失导致 KeyError。
八、复制、合并与共享默认值
copy() 创建的是浅拷贝。普通一层字典的外层已经独立:
1original = {"name": "Austin", "score": 95}
2copied = original.copy()
3
4copied["score"] = 100
5
6print(original["score"])
7print(copied["score"])
但嵌套的可变对象仍可能被共享:
1original = {"scores": [88, 95]}
2copied = original.copy()
3
4copied["scores"].append(100)
5
6print(original)
需要完全独立的嵌套结构时,可以根据实际需求使用 copy.deepcopy()。
Python 3.9 起支持使用 | 合并字典:
1base = {"theme": "light", "language": "zh"}
2custom = {"theme": "dark", "font_size": 14}
3
4merged = base | custom
5print(merged)
重复键使用右侧字典的值。| 生成新字典,|= 原地更新左侧字典;较旧版本可以使用 copy() 配合 update()。
fromkeys() 使用可变默认值时要格外小心:
1data = dict.fromkeys(("a", "b"), [])
2data["a"].append(1)
3
4print(data)
{'a': [1], 'b': [1]}
共享对象陷阱 dict.fromkeys(keys, mutable_object) 会让所有键指向同一个默认对象。如果每个键都需要独立列表,应使用 {key: [] for key in keys} 逐个创建。 |
九、按值排序字典内容
需要按成绩从高到低输出时,可以对 items() 返回的键值对排序:
1scores = {"小明": 88, "小红": 95, "小刚": 76}
2
3ranking = sorted(
4scores.items(),
5key=lambda item: item[1],
6reverse=True,
7)
8
9for name, score in ranking:
10print(name, score)
sorted() 返回排好序的列表,不改变原字典。key=lambda item: item[1] 表示使用每个 (key, value) 中的值作为排序依据。
十、综合案例:词频统计
现在用字典解决一个真实问题:统计一段文本中每个单词出现了多少次。
1text = "python is simple and python is useful"
2counts = {}
3
4for word in text.split():
5counts[word] = counts.get(word, 0) + 1
6
7for word, count in counts.items():
8print(word, count)
python 2
is 2
simple 1
and 1
useful 1
counts.get(word, 0) 解决了“第一次遇到单词时,字典还没有这个键”的问题:旧值不存在就从 0 开始,存在就在原数量上加 1。
进一步思考 真实文本还需要处理大小写、标点和空字符串。先掌握字典计数主线,再逐步加入文本清洗,比一开始把所有问题挤在一段代码里更容易调试。 |
十一、常见错误速查
问题 | 错误示例 | 原因与修正 |
访问缺失键 | data[key] | 键可能缺失时用 get() 或先判断 in |
把值当成成员检查 | 95 in student | 默认检查键;检查值使用 student.values() |
使用不可哈希键 | {[1, 2]: "x"} | 列表不能作为键;改用字符串、数字或合适元组 |
遍历时改变字典大小 | for key in data: del data[key] | 构造待删键列表,或遍历 list(data) |
误以为浅拷贝完全独立 | copied = original.copy() | 嵌套可变对象可能共享;按需使用深拷贝 |
fromkeys() 共享可变默认值 | dict.fromkeys(keys, []) | 改用字典推导式创建独立对象 |
忽略合并时的覆盖 | 合并 left 和 right | 重复键使用右侧值;合并前明确优先级 |
遇到字典错误时,可以先问三个问题:我检查的是键还是值?这个键是否一定存在?数据中是否包含嵌套的可变对象?
本期总结
这一期,我们从字典的键值结构出发,学习了创建、严格访问与安全访问、增删改查、成员判断、视图遍历、推导式、嵌套数据、复制、合并与词频统计。
真正需要记住的主线是:字典用具有含义的键组织和查找值。设计字典时,比记住所有方法更重要的是提前想清楚:什么应该作为唯一、稳定的键?哪些字段可能缺失?缺失时应该报错,还是使用默认值?
建议你亲手完成一个简单通讯录或词频统计程序,再故意查询一个不存在的键,分别观察方括号和 get() 的结果。
END
今天的分享就到这里,感谢你耐心读到最后。希望这篇文章能帮助你建立字典的完整使用思路,不再靠位置猜数据,而是用清晰的键准确组织信息。我们下一期再见!
最后也想听听你的意见:下一期你希望看到哪个 Python 基础知识点? 欢迎在推文下方投票,或者在评论区留言告诉我。
 10个月宝宝每天需要喝多少奶粉?