一、需求:
一次数据库网关压测报告自动化实践:从 80+ 个 JTL 文件到客户级性能分析报告
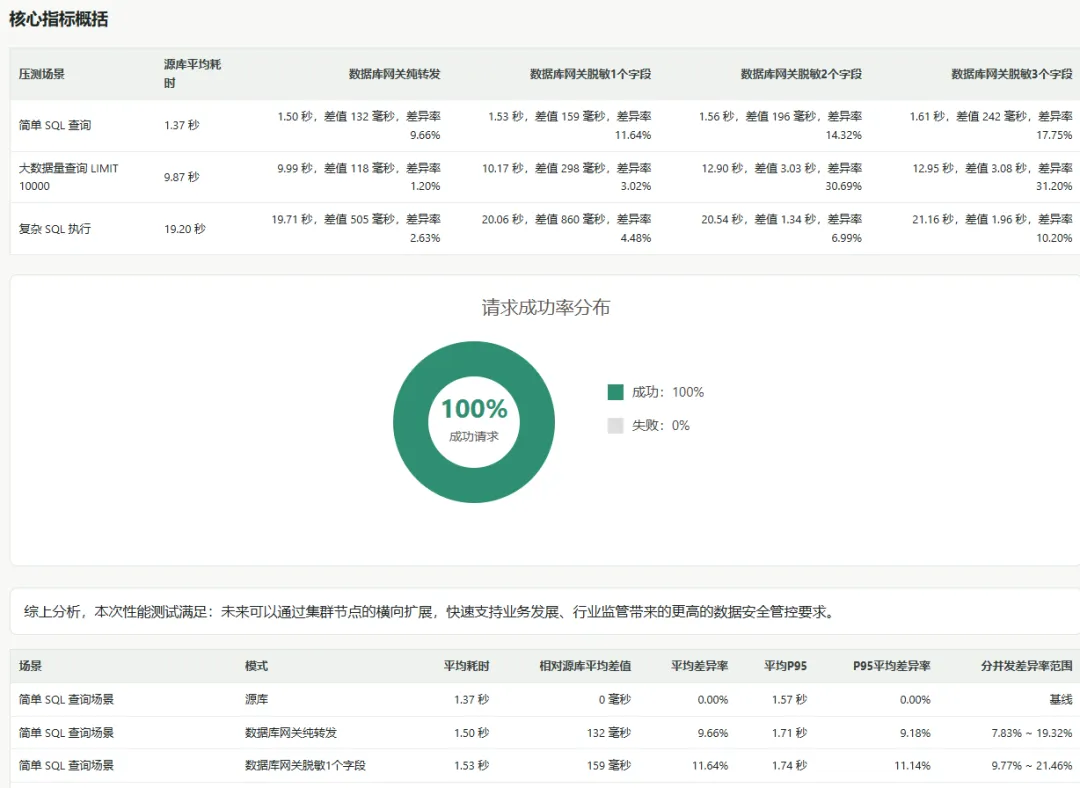
报告效果图:
在一次数据库安全网关性能验证中,我遇到了一个非常典型但又很容易耗费时间的问题:
> JMeter 压测已经完成,但产生了大量 `.jtl` 结果文件。
> 如果逐个打开、逐个统计、逐个对比,不仅效率低,而且很容易出错。
这次测试目标是对比:
- 源库直连- 数据库网关纯转发- 数据库网关开启字段脱敏- 不同并发梯度下的响应耗时、P95、P99、吞吐率和稳定性
最终,我将整个分析过程自动化,实现了从 JTL 文件批量解析,到指标统计、图表生成、客户版 HTML报告输出的一整套流程。
二、背景:为什么需要自动化分析 JMeter JTL?
在数据库网关类产品压测中,通常不会只测一个场景。
本次验证覆盖了多个维度:
| 测试维度 | 说明 ||---|---|| 源库直连 | 应用直接访问数据库,作为基线 || 数据库网关纯转发 | 请求经过数据库网关,但不启用脱敏策略 || 数据库网关脱敏 1 个字段 | 启用单字段脱敏策略 || 数据库网关脱敏 2 个字段 | 启用双字段脱敏策略 || 数据库网关脱敏 3 个字段 | 启用多字段脱敏策略 || 并发梯度 | 从低并发逐步提升到高并发 || SQL 类型 | 简单查询、大数据量查询、复杂 SQL 查询 |
JMeter 每个压测任务都会生成一个 `.jtl` 文件。
当场景和并发组合增多后,JTL 文件数量很快就会变成几十个甚至上百个。
如果手工处理,会遇到几个问题:
1. 每个文件都要单独打开统计。2. 平均耗时、P95、P99 需要重复计算。3. 同并发下源库和网关结果需要人工匹配。4. 报告里的表格、图表、结论容易出现口径不一致。5. 客户版报告还需要隐藏敏感数据,不能直接暴露原始压测细节。
所以,这类工作非常适合脚本化。
三、测试场景设计
本次压测主要分为三类 SQL 场景。
1. 简单 SQL 查询
用于验证普通查询经过数据库网关后的基础链路开销。
select person_id, customer_name, id_no, part_nofrom xxx.profile_infolimit 100;
2. 大数据量查询
用于验证大结果集返回时,数据库网关在纯转发和脱敏场景下的处理能力。
SELECT person_id, card_number, mobile, customer_name, birth_date, age, gender, points, salary, email_address, address, last_purchase_channel, create_timeFROM xxx.customer_infoLIMIT 10000;
3. 复杂 SQL 查询
用于验证多表关联、聚合计算、条件过滤场景下的网关性能表现。
SELECT a.person_id AS id, b.id_no, a.gender, min(a.points) AS points, max(a.salary) AS salary, sum(CASE WHEN a.gender = '0' THEN 1 ELSE 0 END) AS male_num, sum(CASE WHEN a.gender = '1' THEN 1 ELSE 0 END) AS female_numFROM xxx.customer_info aJOIN xxx.profile_info b ON a.person_id = b.person_idWHERE extract(year FROM date(a.birth_date)) >= extract(year FROM date(now())) - 66 AND extract(year FROM date(a.birth_date)) <= extract(year FROM date(now())) - 27 AND a.card_number LIKE '15%'GROUP BY 1,2,3LIMIT 100;
四、核心指标说明
为了让报告既能给技术人员看,也能给非技术客户看,我在报告中加入了术语解释。
| |
|---|
| 数据库网关代理,位于应用和数据库之间,用于访问转发、数据脱敏、审计和安全管控 |
| |
| |
| 对敏感字段进行保护处理,例如身份证、手机号、姓名等 |
| |
| |
| |
| |
| |
五、自动化分析思路
整个脚本的处理流程如下:
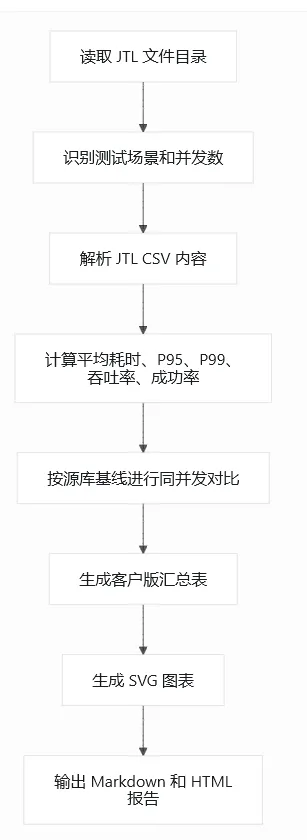 编辑
自动化脚本主要解决了四件事:
批量解析 JMeter .jtl 文件。自动按场景、并发、模式进行归类。自动计算核心性能指标。自动生成客户可读的报告和图表。
六、报告展示效果
最终报告包括:
总结结论专业术语说明核心指标概括成功率图表各场景平均响应时间趋势图分场景详细数据表系统资源观察压测 SQL 脚本
七、关键实现点
1. JTL 文件解析
JMeter 的 JTL 文件本质上是 CSV,常见字段包括:
timeStamp, elapsed, label, responseCode, success, Latency, Connect
脚本会重点读取:
elapsed success timeStamp Latency Connect
并据此计算:
样本数成功率平均响应时间P90 / P95 / P99吞吐率
2. 同并发基线对比
对比时必须保证口径一致:
同一个 SQL 场景、同一个并发数下,源库结果作为基线。
差异率计算公式:
差异率 = (数据库网关场景耗时 - 源库耗时) / 源库耗时 × 100%
例如:
源库平均耗时 = 10 秒
数据库网关脱敏平均耗时 = 10.3 秒
差值 = 0.3 秒
差异率 = 0.3 / 10 × 100% = 3%
八、遇到的问题
问题 1:HTML 发给客户后图表不显示
最开始 HTML 报告里的图表是这样引用的:
<imgsrc="jmeter_success_rate_pie.svg">
本地打开没有问题,但如果只把 HTML 文件发给客户,SVG 文件没有一起发送,客户打开后图表就会丢失。
最终改成:
<divclass="chart-wrap"> <svg>...</svg></div>
也就是将 SVG 图表直接内嵌到 HTML 里。
这样客户只需要一个 HTML 文件,就能完整看到表格和图表。
问题 2:客户不理解 P95 / P99 / 吞吐率
技术报告如果只写指标,很容易让非技术客户看不懂。
所以我在报告前面加入“专业术语说明”,让客户先理解术语,再看数据。
九、最终效果
通过这次自动化处理,整个报告生成流程从“人工逐个文件处理”变成了“一键生成”。
最终输出包括:
十、总结
这次实践最大的价值,不只是生成了一份报告,而是把一次性分析过程沉淀成了可复用工具。
后续如果再有类似压测,只需要:
1.把 JTL 文件放到指定目录。2.配置场景名称和文件命名规则。3.执行脚本。4.自动生成客户版报告。
这类自动化脚本非常适合数据库网关、数据安全、SQL 审计、脱敏代理、数据库中间件等产品的性能验证场景。综上分析,本次性能测试满足:未来可以通过集群节点的横向扩展,快速支持业务发展、行业监管带来的更高的数据安全管控要求。
十一、总结
完整 Python 脚本我已经整理成可复用版本,包含:
JTL 批量解析性能指标计算源库基线对比HTML 报告生成SVG 图表内嵌
如果你也在做 JMeter 压测分析、数据库网关性能验证、脱敏代理性能测试,可以关注我。关注后可获取完整源码和使用说明。