兄弟们,搞ML的谁没被CUDA折磨过?写一个融合softmax,手撕shared memory、寄存器映射、warp调度,写完三天过去了,性能还没cuBLAS一半。TileLang这玩意儿就一句话:你在Python里写“块级别”的数学,编译器自己把线程、流水、向量化、MMA指令全给你撸出来。最终性能能贴脸cuBLAS,还不用碰一行C++。
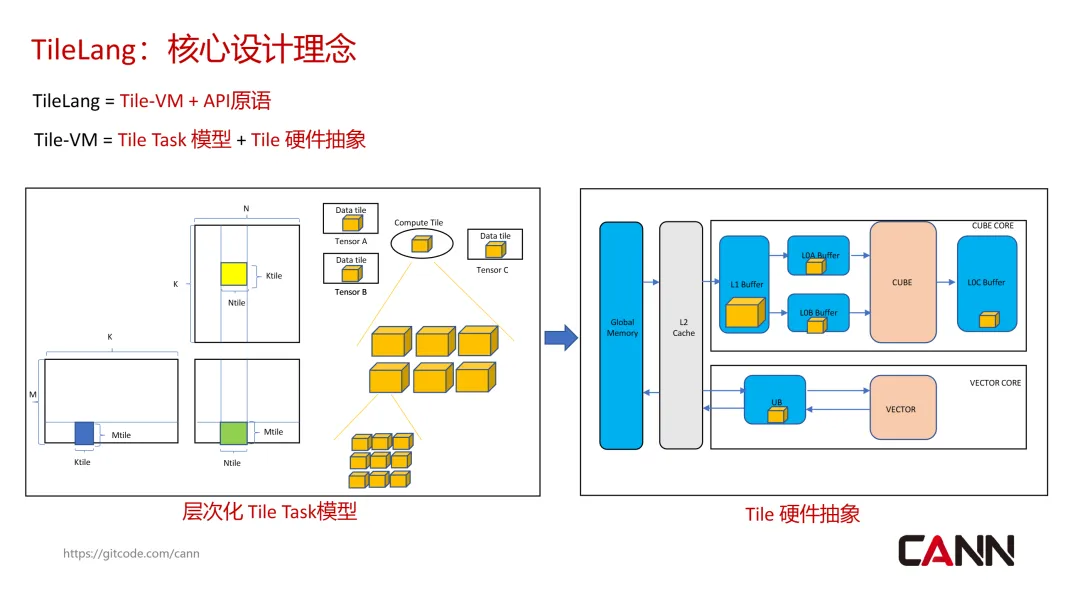
tilelang ascend:让ai算子开发更简单!
🚨 TileLang到底是个啥?为啥能治CUDA内卷?
TileLang是一套Python风格的领域专用语言(DSL),后端接的是TVM的代码生成体系。它不让你写"线程该咋分、内存咋排"这种细枝末节,只让你声明:
- 这块tile放shared memory(
T.alloc_shared); - 这块碎片丢寄存器当累加器(
T.alloc_fragment); - 这里直接调Tensor-Core的MMA(
T.gemm)。
剩下线程怎么绑、内存怎么coalescing、warp怎么调度,全是编译器的事。对常年被CUDA折磨的ML工程师来说,这就是"降维打击"——你只管数学形状,剩下的脏活编译器包圆。
⚡ 三件套:GEMM、融合Softmax、FlashAttention全给你安排上
教程里直接演示了三个最常见的硬骨头场景:
① Tensor-Core GEMM分块矩阵乘,配合block_M / block_N / block_K和流水线stage,把Tensor-Core算力榨干。
tensor core
② 融合Softmax(行级)用T.Parallel做行内并行、T.reduce做归约,把逐行归一化写成一个kernel,中间不落HBM。
③ FlashAttention把Attention切块、用流水线在shared memory里流过去,全程不存中间大矩阵——显存爆掉?不存在。
📊 性能对位:TileLang vs PyTorch vs cuBLAS
教程在Google Colab的T4上跑了一个4096×4096×4096的float16 GEMM,对比三种实现的吞吐量(相对位置,单位TFLOPS为相对值示例,真实数据请以本机实测为准):
一句话总结:写tile级别Python代码,输出接近手写CUDA的性能,省下来的时间够你再训三个模型。
Designing High-Performance GPU Kernels with TileLang
🛠️ 保姆级实操:30分钟从零跑通第一个Tensor-Core GEMM
环境清单:
- 一块NVIDIA GPU(Colab免费T4就够)
- Python 3.x,TVM会被TileLang自动拉下来
Step 1. 装包
pip install -q tilelang -f https://tile-ai.github.io/whl/nightly⚠️ 排雷:如果装稳定版挂了,脚本会自动切nightly,别慌。如果遇到CUDA_HOME没设的报错,import之前手动export:
export CUDA_HOME=/usr/local/cudaStep 2. 准备两个工具函数
bench用CUDA Event测中位延迟,check用相对Frobenius范数核对你的结果——没这俩你都不知道自己代码快不快、对不对。
Step 3. 写第一个kernel:向量加
def make_vector_add(N, block_N=256, dtype="float32"): @T.prim_func def main(A: T.Tensor((N,), dtype), B: T.Tensor((N,), dtype), C: T.Tensor((N,), dtype)): with T.Kernel(T.ceildiv(N, block_N), threads=256) as bx: for i in T.Parallel(block_N): C[bx * block_N + i] = A[bx * block_N + i] + B[bx * block_N + i] return main编译跑完,编译器已经替你把线程映射、内存对齐、CUDA指令全部生成了——不用你碰。
Step 4. 升级到Tensor-Core GEMM
上分块,用四个核心原语:
A_shared = T.alloc_shared((block_M, block_K), dtype)B_shared = T.alloc_shared((block_K, block_N), dtype)C_local = T.alloc_fragment((block_M, block_N), "float32")for ko in T.Pipelined(T.ceildiv(K, block_K), num_stages=num_stages): ... T.gemm(A_shared, B_shared, C_local)跑同款4096³的float16 GEMM,用block_M=128, block_N=128, block_K=32, num_stages=2,相对误差~1e-3,对比cuBLAS吃满Tensor-Core带宽。
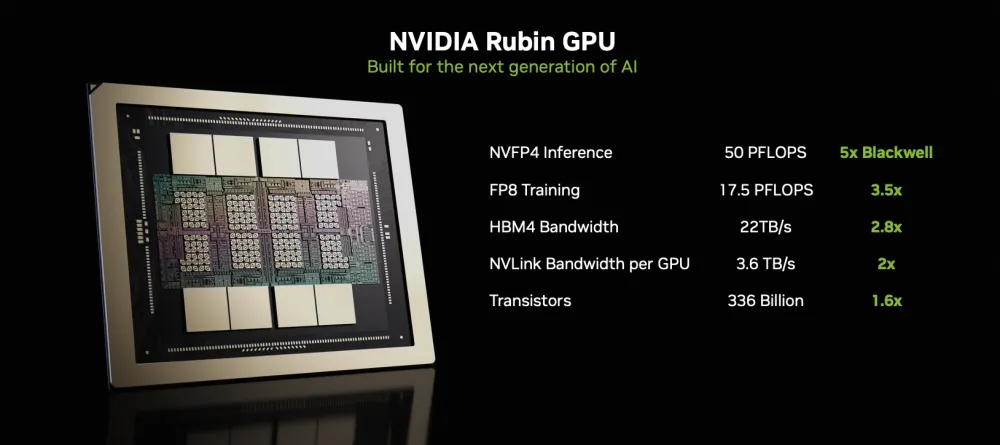
nvfp4 推理算力 50pflops·224个sm,第六代 tensor core第三代
Step 5. 开自动调优
别瞎试参数,让编译器帮你扫。TileLang会在你给定的范围里挑最优组合。教程给出的搜索空间:
| | |
|---|
block_M | | |
block_N | | |
block_K | | |
num_stages | | |
use_swizzle | | |
目标架构是T4(sm_75)、A100(sm_80)、L4(sm_89)。
💣 踩坑清单(教程亲历)
- 忘了设CUDA_HOME
- 小shared memory卡开num_stages=3:T4每block只有48KB,3级流水线+大tile直接爆,改回2。
- 不跑check:fast和wrong只差一个字母,float16必须用相对误差判断。
- 妄想秒cuBLAS:向量加法受限于带宽,TileLang和cuBLAS平手就是胜利,别上头。
🎯 谁该冲,谁快跑?
- ML工程师/研究员:想给自家模型撸融合算子、又不想碰CUDA C++——直接上手。
- 推理优化党:做fine-tuning卡在kernel?换TileLang写一个定制算子,省GPU小时费。
- 硬件性能党:想看看新GPU的Tensor-Core极限,但不想从零写CUTLASS——用它当脚手架。
- 想拿它做生产的
说白了,写Python、跑Tensor-Core、贴脸cuBLAS——TileLang把"GPU调优"从玄学变成了"配参数"。装包命令再甩一遍:
pip install -q tilelang -f https://tile-ai.github.io/whl/nightlyColab开起来,30分钟后你就拥有了第一个手搓的Tensor-Core kernel——还要啥手写CUDA?
 10个月宝宝每天需要喝多少奶粉?