一、开篇场景:紧急批量修复 SSH 配置
时间:2025 年 11 月的一个周五下午 4 点
人物:某互联网公司运维工程师小李
事件:安全团队扫描发现线上 200+ 台服务器的 SSH 配置存在弱加密算法(CVE-2025-XXXX),需要紧急批量修复。
传统方式:一台台登录服务器,手动修改 /etc/ssh/sshd_config,重启 sshd 服务,验证配置是否生效。
预计耗时:200 台 × 3 分钟 = 600 分钟 = 10 小时
小李的解决方案:用 Python + paramiko 写了个 50 行的脚本,并发连接 200 台服务器,15 分钟完成全部修复。
这就是 Python 运维自动化的威力! 本文将从参数、原理、代码、踩坑到 AI 辅助,带你系统掌握 paramiko 和 requests 的批量管理技巧。
二、核心概念讲解
知识点 1:paramiko — SSH 协议的 Python 实现
【概念】是什么
paramiko 是 Python 实现的 SSHv2 协议库,支持:
SSH 客户端(远程命令执行、文件传输)
SSH 服务器(较少用)
SFTP 客户端(安全文件传输)
【原理】为什么需要 paramiko?
原生 SSH 命令的局限:ssh user@host command 无法编程控制,难以处理复杂逻辑(如根据执行结果决定下一步操作)。
paramiko 的优势:
纯 Python 实现,跨平台
支持密码、密钥、双因子认证
可编程控制整个 SSH 会话
支持 SFTP,实现批量文件分发
底层原理:使用 Python 的 socket 建立 TCP 连接,实现 SSHv2 协议的握手、密钥交换、认证、加密、压缩,支持多种加密算法(AES、Blowfish、3DES 等)。
【实操】完整命令 + 注释(带执行结果示例)
📦 安装 paramiko
🐍 示例 1:SSH 远程执行命令
import paramikoimport time# 配置信息HOST = '192.168.1.100'USER = 'root'PASSWORD = 'your_password' # 生产环境建议用密钥认证# 创建 SSH 客户端client = paramiko.SSHClient()client.set_missing_host_key_policy(paramiko.AutoAddPolicy())try: print(f"[{time.strftime('%H:%M:%S')}] 正在连接 {HOST}...") client.connect(hostname=HOST, username=USER, password=PASSWORD, port=22, timeout=10) print(f"[成功] 已连接到 {HOST}") # 执行命令 stdin, stdout, stderr = client.exec_command('uptime && free -h', timeout=30) output = stdout.read().decode('utf-8') error = stderr.read().decode('utf-8') if output: print(f"\n[输出]\n{output}") if error: print(f"\n[错误]\n{error}")except paramiko.AuthenticationException: print("[失败] 认证失败")except Exception as e: print(f"[失败] {e}")finally: client.close()f"\n[{time.strftime('%H:%M:%S')}] 连接已关闭"
📤 示例 2:SFTP 批量上传文件
def upload_file(host, user, password, local_path, remote_path): client = paramiko.SSHClient() client.set_missing_host_key_policy(paramiko.AutoAddPolicy()) try: client.connect(host, username=user, password=password) sftp = client.open_sftp() print(f"正在上传 {local_path} → {host}:{remote_path}") sftp.put(local_path, remote_path) print("[成功] 文件已上传") sftp.close() finally: client.close()
【应用】典型使用场景
批量执行命令:检查磁盘使用率、收集日志、批量安装软件
批量分发配置文件:将 nginx.conf、ssh 配置等分发到大量服务器
批量收集日志:将每台服务器的日志集中拉取到控制机分析
⚠️ 踩坑提醒: 生产环境务必使用密钥认证,避免密码明文泄露。同时注意控制并发数,防止 SSH 连接数超限。
知识点 2:requests — HTTP 库的王者(及新一代 httpx)
【概念】是什么
requests 是 Python 最流行的 HTTP 库,用于调用 RESTful API、与 Web 服务交互(云服务 API、监控平台 API、CMDB API)、自动化测试。而 httpx 作为新一代 HTTP 客户端,支持 HTTP/2 和异步,正逐渐成为 requests 的强力竞争者。
【原理】为什么 requests 比原生 urllib 好用?
urllib 的痛点:API 繁琐、需要手动处理编码、不支持会话保持。
requests 的优势:人性化的 API、自动处理编码、重定向、Cookie,支持 Session 保持登录状态,内置 JSON 解析、文件上传、SSL 验证。
httpx 的亮点:完全兼容 requests 的 API,同时支持异步(async/await)和 HTTP/2,性能更优。
【实操】完整命令 + 注释
📦 安装 requests 和 httpx
pip install requests httpx
🌐 示例 1:调用 RESTful API 获取服务器信息(requests)
import requestsAPI_BASE = 'https://cmdb.example.com/api/v1'headers = {'Authorization': 'Token your_api_token'}response = requests.get(f'{API_BASE}/servers/', headers=headers, timeout=10)if response.status_code == 200: servers = response.json() print(f"共 {len(servers)} 台服务器")else: print(f"失败: HTTP {response.status_code}")
⚡ 示例 2:使用 httpx 异步并发请求(新一代)
import httpximport asyncioasync def fetch_servers(client, url): response = await client.get(url) return response.json()async def main(): async with httpx.AsyncClient() as client: tasks = [fetch_servers(client, 'https://api.example.com/v1/servers') for _ in range(10)] results = await asyncio.gather(*tasks) print(f"获取到 {len(results)} 个响应")asyncio.run(main())
【应用】典型使用场景
自动化部署:触发 Jenkins/GitLab CI 构建
云资源管理:调用 AWS/阿里云 API 启停实例
监控数据上报:推送自定义指标到 Prometheus Pushgateway
💡 最佳实践: 对于大量并发 API 调用,推荐使用 httpx 的异步模式,性能优于 requests + 多线程。同时务必设置超时(timeout)和重试策略。
知识点 3:并发编程 — 让批量操作飞起来
【概念】是什么
并发编程让 Python 同时处理多个任务,提升批量操作的效率。常用方案:
多线程(threading):适合 I/O 密集型任务(SSH、HTTP 请求)
多进程(multiprocessing):适合 CPU 密集型任务
异步 IO(asyncio):适合高并发场景(上万台服务器管理)
【原理】为什么需要并发?
串行执行的问题:100 台服务器 × 每台 3 秒 = 300 秒 = 5 分钟
并发执行的优势:20 个线程并发 × 每台 3 秒 = 15 秒(理论上)
Python 并发的局限与突破:GIL(全局解释器锁)限制了 CPU 密集型任务的并行,但 I/O 密集型任务在等待时会释放 GIL,因此多线程和异步非常适合网络运维场景。
【实操】完整命令 + 注释
🧵 使用 concurrent.futures 线程池(推荐)
import concurrent.futuresimport paramikodef run_command(server): client = paramiko.SSHClient() client.set_missing_host_key_policy(paramiko.AutoAddPolicy()) try: client.connect(server['host'], username=server['user'], password=server['password'], timeout=10) stdin, stdout, stderr = client.exec_command('uptime', timeout=30) return {'host': server['host'], 'output': stdout.read().decode()} finally: client.close()servers = [{'host': '192.168.1.100', 'user': 'root', 'password': 'pass'}] * 100with concurrent.futures.ThreadPoolExecutor(max_workers=20) as executor: results = executor.map(run_command, servers) for result in results: print(f"{result['host']}: {result['output']}")
⚡ asyncio + asyncssh 异步 SSH(高并发利器)
import asyncioimport asyncsshasync def run_ssh(host, user, password): async with asyncssh.connect(host, username=user, password=password) as conn: result = await conn.run('uptime', check=True) return host, result.stdoutasync def main(): hosts = ['192.168.1.100', '192.168.1.101'] # 可扩展至数千台 tasks = [run_ssh(host, 'root', 'pass') for host in hosts] results = await asyncio.gather(*tasks) for host, output in results: print(f"{host}: {output.strip()}")asyncio.run(main())
⚡ 性能对比: 对于 1000 台服务器,串行执行约需 50 分钟,多线程(20 线程)约需 3 分钟,asyncio 可压缩至 1 分钟以内。建议根据实际服务器数量和网络条件选择合适的并发模型。
三、AI 赋能网络自动化:效率提升 6–12 倍
AI 工具生态
| AI 工具 | 用途 | 适用场景 |
|---|
| GitHub Copilot | 代码补全、生成 | 编写 paramiko/requests 脚本 |
| ChatGPT / Claude | 代码生成、Debug | 学习 API 用法、排查错误 |
| Cursor / Windsurf | IDE 集成 AI | 重构批量管理脚本 |
| Tabnine | 代码补全 | 企业内网开发(本地运行) |
典型使用场景
场景 1:AI 生成 paramiko 批量管理脚本
需求:批量检查 200 台服务器的磁盘使用率,超过 80% 发送告警。
传统耗时:2 小时 → AI 辅助:15 分钟
🧪 Prompt 模板:
“你是一个 Python 运维自动化专家。请帮我生成一个脚本,使用 paramiko 并发检查 200 台服务器的磁盘使用率(df -h),解析输出,如果使用率 ≥ 80% 记录告警,并生成报告。使用 concurrent.futures 控制并发数。”
场景 2:AI 辅助调试 requests 请求失败
问题:调用 API 返回 401 Unauthorized。
传统方式:查文档、对比代码、手动 curl 测试,耗时 30 分钟 → AI 辅助:5 分钟
🔍 典型 AI 诊断:
“你的 Authorization Header 格式错误,应为 Bearer <token> 而非 Token <token>。”
场景 3:AI 生成并发管理框架(带重试、超时、进度条)
需求:并发执行任务,支持超时、重试、失败回调和 tqdm 进度条。
传统耗时:半天 → AI 辅助:30 分钟
效率提升对比
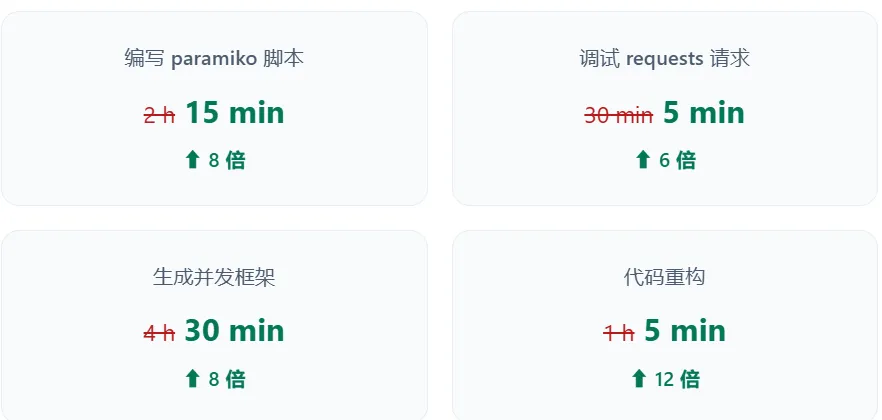
总评:AI 辅助可将 Python 运维自动化开发效率提升 6–12 倍,但生成的代码仍需人工审查,特别是安全性和边界条件。
四、命令/代码实操:批量管理 100 台服务器
📜 batch_manager.py(完整脚本)
#!/usr/bin/env python3"""批量服务器管理工具功能:批量执行命令、上传/下载文件、并发控制、重试、生成报告"""import paramikoimport concurrent.futuresfrom datetime import datetimefrom tqdm import tqdmimport argparseimport sysMAX_WORKERS = 20TIMEOUT = 10COMMAND_TIMEOUT = 30MAX_RETRIES = 3def run_command(server, command, results): for attempt in range(MAX_RETRIES): client = paramiko.SSHClient() client.set_missing_host_key_policy(paramiko.AutoAddPolicy()) try: client.connect(server['host'], username=server['user'], password=server['password'], timeout=TIMEOUT) stdin, stdout, stderr = client.exec_command(command, timeout=COMMAND_TIMEOUT) results[server['host']] = { 'status': 'success', 'output': stdout.read().decode(), 'error': stderr.read().decode() } return except Exception as e: if attempt == MAX_RETRIES - 1: results[server['host']] = {'status': 'failed', 'error': str(e)} finally: client.close()def batch_execute(servers, command): results = {} with concurrent.futures.ThreadPoolExecutor(max_workers=MAX_WORKERS) as executor: futures = [executor.submit(run_command, server, command, results) for server in servers] for _ in tqdm(concurrent.futures.as_completed(futures), total=len(servers), desc="执行进度"): pass # 生成报告f"batch_report_{datetime.now().strftime('%Y%m%d_%H%M%S')}.txt" with open(report_file, 'w') as f: for host, res in results.items(): f.write(f"{host}: {res['status']}\n") print(f"报告已生成: {report_file}") return resultsif __name__ == '__main__': parser = argparse.ArgumentParser() parser.add_argument('--command', '-c', required=True, help='要执行的命令') parser.add_argument('--servers', '-s', required=True, help='服务器列表文件 (IP,user,password)') args = parser.parse_args() with open(args.servers) as f: servers = [dict(zip(['host','user','password'], line.strip().split(','))) for line in f if line.strip()] batch_execute(servers, args.command)
使用方法:
# 准备 servers.txt192.168.1.100,root,pass123192.168.1.101,root,pass123# 执行python batch_manager.py -c "uptime" -s servers.txt
五、真实生产案例:批量修复 SSH 弱加密算法
🔒某互联网公司批量修复 SSH 配置(CVE-2025-XXXX)
📅 2025-11📊 服务器:200+ 台⏱ 修复耗时:15 分钟
🔴 需求背景
安全团队扫描发现所有服务器的 SSH 配置存在弱加密算法(3DES、Blowfish),需禁用并启用强加密算法(AES-256-GCM),重启 sshd 并验证。
🔧 方案设计
📋 实现步骤
生成新的 sshd_config 模板(禁用弱算法)
编写 Python 脚本:备份原配置 → 上传新配置 → 语法检查 → 重启 sshd → 验证状态
并发执行,记录成功/失败清单
📊 量化结果
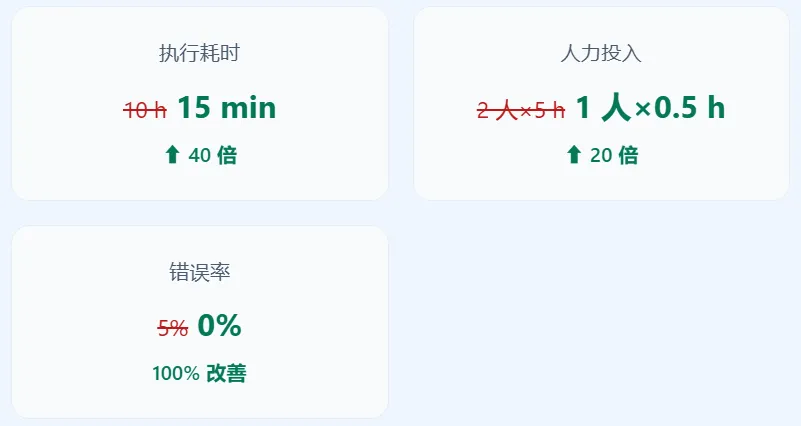
最终:198 台成功,2 台硬件故障手动处理,总耗时 15 分钟,完美达成 deadline。
六、避坑指南 · 8 条生产级经验
❌ SSH 连接超时
设置 timeout 并添加重试机制(指数退避),避免网络波动导致失败。
❌ 并发数过高系统崩溃
控制 max_workers(建议 10–50),并根据服务器配置调整,避免资源耗尽。
❌ 密码明文硬编码
使用环境变量、密钥认证或加密配置文件(权限 600),杜绝泄露风险。
❌ HTTP 请求未设超时
始终设置 timeout=(connect, read),防止请求永久阻塞。
❌ 未处理 HTTP 错误状态
调用 response.raise_for_status() 或显式检查状态码,避免错误数据污染逻辑。
❌ 多线程共享变量无锁
使用 threading.Lock 或 queue.Queue 保护共享资源,防止数据错乱。
❌ 忽略 SFTP 传输校验
上传后验证文件大小或 MD5,确保传输完整。
❌ 缺少审计日志
记录每次操作的时间、用户、主机、结果,便于事后追溯和合规。
七、总结与展望
本文系统讲解了 Python 运维自动化的三大支柱:paramiko(SSH 编程)、requests/httpx(HTTP 客户端)和 并发编程(多线程、线程池、异步 IO)。通过真实案例和避坑指南,读者可以快速上手,将手动操作转化为高效、可靠的自动化脚本。
展望 2026 年,运维自动化正朝着 智能化、云原生、可观测 方向演进:AI 将深度融入代码生成和故障诊断,异步框架(如 asyncio)和 HTTP/2 将进一步提升性能,GitOps 和 IaC 将成为标配。掌握 Python 批量管理技能,将使你在运维领域中具备核心竞争力。