第332讲:用 Python 和 VBA 两套技术栈来实现:日志文件解析与结构化存储——从Nginx日志到Excel报表的工程化实践
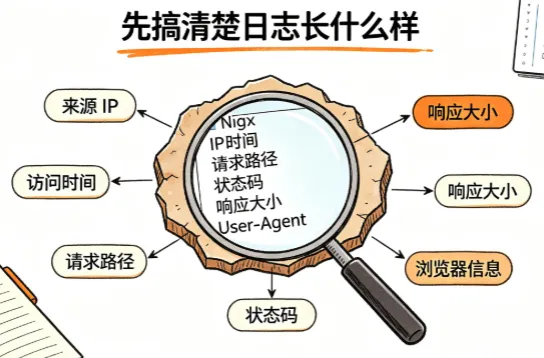
在企业日常运维与数据分析工作中,服务器访问日志是最容易被忽视却又价值极高的数据源。Nginx作为目前最流行的Web服务器之一,其access.log记录了每一次请求的IP、时间、请求路径、状态码、响应大小、User-Agent等关键信息。很多同学的需求其实很朴素:把这些半结构化的文本日志,变成一张Excel分析表。
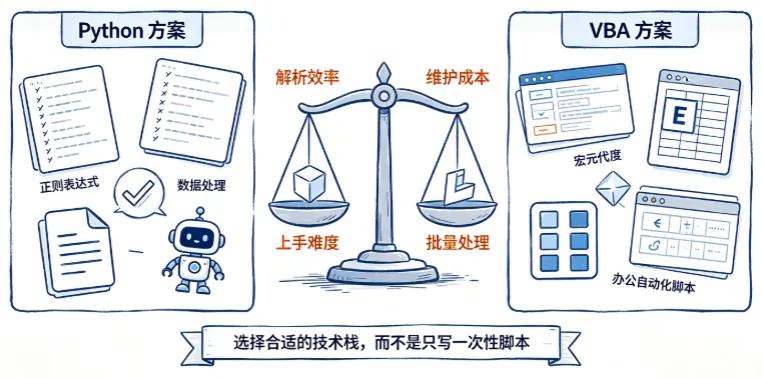
这个需求看似简单,但在实际落地时,技术选型会直接影响效率与可维护性。今天我们就以「Nginx访问日志 → Excel结构化报表」为主线,分别用 Python 和 VBA 两套技术栈来实现,并重点对比两者在正则解析、文件IO、数据处理上的差异,顺便把工程实践中容易踩的坑一次性讲清楚。
一、先搞清楚:我们要解析的日志长什么样?
在开始写代码之前,先统一数据口径。Nginx的访问日志格式由nginx.conf中的log_format决定,最常见的默认格式(combined)如下:
127.0.0.1 - - [23/Dec/2025:14:27:11 +0800] "GET /api/user/list HTTP/1.1" 200 3458 "https://example.com/" "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
拆开来看,一条日志通常包含这些字段:
字段位置 | 含义 |
|---|
$remote_addr
| 客户端IP |
$remote_user
| 远程用户(通常为-) |
$time_local
| 本地时间 |
$request
| 请求行(方法 + URI + 协议) |
$status
| HTTP状态码 |
$body_bytes_sent
| 响应体大小 |
$http_referer
| 来源页 |
$http_user_agent
| 用户代理 |
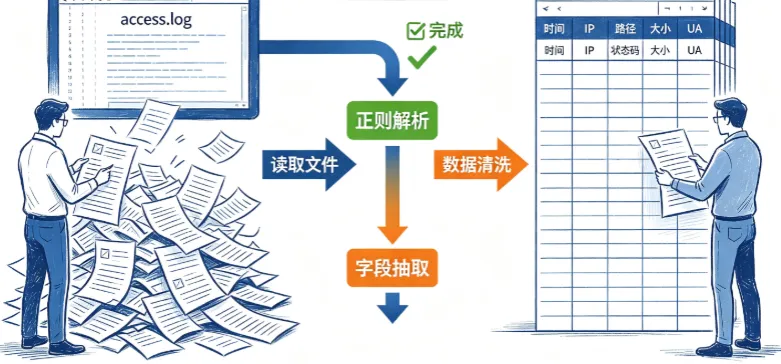
我们的目标,就是把这些字段从一行文本中“抠”出来,整理成Excel的列。
二、Python方案:正则 + pandas 的高效流水线
Python在处理文本和数据清洗方面几乎是降维打击。它的优势主要体现在三点:
正则表达式引擎成熟,一次匹配即可提取全部字段;
pandas天生适合表格数据,解析完直接转DataFrame;
向量化操作,不依赖逐行循环,性能极高。
下面我们一步步拆解一个工程级的Python实现。
2.1 构造健壮的正则表达式
很多人写日志正则容易翻车,原因是忽略了字段中可能存在的特殊字符。一个相对稳妥的Nginx combined日志正则可以这样写:
import repattern = re.compile( r'(?P<ip>\d+\.\d+\.\d+\.\d+)\s+-\s+-\s+' r'\[(?P<time>[^\]]+)\]\s+' r'"(?P<method>\S+)\s+(?P<url>\S+)\s+(?P<protocol>[^"]+)"\s+' r'(?P<status>\d+)\s+' r'(?P<size>\d+)\s+' r'"(?P<referer>[^"]*)"\s+' r'"(?P<user_agent>[^"]*)"')
这里用了命名分组(?P<name>),好处非常明显:
后面可以直接用match.groupdict()拿到字典,字段名一目了然,维护成本极低。
2.2 高效读取大日志文件
处理日志最常见的问题不是解析,而是内存。如果日志文件几个GB,一次性读入内存显然不现实。正确的做法是按行流式读取:
def parse_nginx_log(log_path): results = [] with open(log_path, 'r', encoding='utf-8', errors='ignore') as f: for line in f: match = pattern.search(line) if match: results.append(match.groupdict()) return results
这里有两个细节值得强调:
errors='ignore':生产环境日志里偶尔会有乱码,忽略错误比程序崩溃强;
先收集到list,再一次性转DataFrame,而不是边解析边写Excel,这是典型的批处理思想。
2.3 pandas结构化与导出Excel
解析完成后,pandas登场:
import pandas as pdlogs = parse_nginx_log('access.log')df = pd.DataFrame(logs)# 时间字段转datetime,方便后续按天/小时统计df['time'] = pd.to_datetime(df['time'], format='%d/%b/%Y:%H:%M:%S %z')# 数值字段类型转换df['status'] = df['status'].astype(int)df['size'] = df['size'].astype(int)# 导出Exceldf.to_excel('nginx_report.xlsx', index=False)
这一套流程下来,哪怕几十万行日志,也能在秒级完成解析与导出。更重要的是,DataFrame已经天然支持后续分析,比如:
# 统计各状态码占比df['status'].value_counts()# 按小时聚合流量df.set_index('time').resample('H').size()
这就是Python方案的魅力:解析只是第一步,真正的价值在于后续分析几乎零成本。
三、VBA方案:FileSystemObject + 正则 + 单元格写入
接下来我们看VBA方案。很多老Excel玩家依然离不开VBA,尤其是当环境受限(无法安装Python)、或者报表必须直接在Excel内生成时,VBA是唯一选择。
但必须提前说明:VBA在处理大文本文件时的性能劣势非常明显,这一点我们会在后面专门对比。
3.1 启用正则支持
VBA本身没有内置正则,需要引用 Microsoft VBScript Regular Expressions 5.5:
打开VBA编辑器(Alt + F11)
Tools → References
勾选 Microsoft VBScript Regular Expressions 5.5
3.2 用FileSystemObject逐行读取
VBA读取文本文件的典型方式是FileSystemObject,配合TextStream:
Sub ParseNginxLog() Dim fso As Object Dim ts As Object Dim reg As Object Dim logPath As String Dim line As String Dim rowNum As Long logPath = "C:\access.log" Set fso = CreateObject("Scripting.FileSystemObject") Set ts = fso.OpenTextFile(logPath, 1, False) ' 初始化正则 Set reg = CreateObject("VBScript.RegExp") reg.Pattern = "(\d+\.\d+\.\d+\.\d+)\s+-\s+-\s+\[([^\]]+)\]\s+""(\S+)\s+(\S+)\s+([^""]+)""\s+(\d+)\s+(\d+)\s+""([^""]*)""\s+""([^""]*)""" reg.Global = False rowNum = 2 ' 从第2行开始写数据 Application.ScreenUpdating = False ' 关闭屏幕刷新,提升性能 ' 写表头 Cells(1, 1).Value = "IP" Cells(1, 2).Value = "Time" Cells(1, 3).Value = "Method" Cells(1, 4).Value = "URL" Cells(1, 5).Value = "Protocol" Cells(1, 6).Value = "Status" Cells(1, 7).Value = "Size" Cells(1, 8).Value = "Referer" Cells(1, 9).Value = "UserAgent" Do Until ts.AtEndOfStream line = ts.ReadLine If reg.Test(line) Then Dim matches As Object Set matches = reg.Execute(line) With matches(0) Cells(rowNum, 1).Value = .SubMatches(0) Cells(rowNum, 2).Value = .SubMatches(1) Cells(rowNum, 3).Value = .SubMatches(2) Cells(rowNum, 4).Value = .SubMatches(3) Cells(rowNum, 5).Value = .SubMatches(4) Cells(rowNum, 6).Value = .SubMatches(5) Cells(rowNum, 7).Value = .SubMatches(6) Cells(rowNum, 8).Value = .SubMatches(7) Cells(rowNum, 9).Value = .SubMatches(8) End With rowNum = rowNum + 1 End If Loop ts.Close Application.ScreenUpdating = True MsgBox "解析完成,共处理 " & rowNum - 2 & " 条记录"End Sub
3.3 VBA方案的痛点在哪里?
这段代码逻辑上没问题,但在实际使用中你会立刻感受到几个硬伤:
逐行写单元格:每解析一行就写一次Sheet,IO开销巨大;
正则功能弱:不支持命名分组,下标.SubMatches(n)可读性极差;
内存与稳定性差:几万行日志就能让Excel卡顿甚至崩溃;
时间解析麻烦:VBA的日期函数远不如pandas.to_datetime智能。
因此,VBA更适合小体量日志(几千~几万行)的快速查看,而不适合作为长期的数据管道。
四、Python vs VBA:核心差异对照表
为了让你一眼看懂两者的差距,我把关键维度整理成了对照表:
维度 | Python | VBA |
|---|
正则能力 | 支持命名分组、复杂断言 | 仅基础正则,无命名分组 |
文件读取 | 流式读取,内存占用低 | 逐行读取,内存压力中等 |
数据处理 | pandas向量化,速度快 | 循环写入单元格,速度慢 |
扩展性 | 可直接对接数据库、BI | 基本局限于Excel |
学习成本 | 语法现代,生态丰富 | Office用户上手快 |
适用规模 | 百万级日志无压力 | 建议控制在5万行以内 |
一句话总结:Python是“工程化解决方案”,VBA是“应急工具”。
五、实战进阶:让日志解析更“专业”
在实际项目中,日志解析往往不止“读出来、写进去”这么简单,下面补充几个常见优化点。
5.1 自定义Nginx日志格式怎么办?
如果你的log_format里加了$request_time、$upstream_response_time,只需要同步调整正则即可。例如:
(?P<request_time>\d+\.\d+)\s+(?P<upstream_time>\d+\.\d+)
然后插入到原有正则的合适位置。Python的命名分组会让这种变更非常可控。
5.2 超大日志的分块处理
当单文件超过500MB时,可以考虑分块读取 + 分批写Excel(避免单个xlsx文件过大):
from pandas import DataFramechunk_size = 100000for i, chunk in enumerate(pd.read_csv('access.log', chunksize=chunk_size, header=None)): chunk.to_excel(f'nginx_part_{i}.xlsx', index=False)
5.3 VBA的性能补救方案
如果你不得不使用VBA,至少可以做两点优化:
将数据先写入数组,再一次性写入单元格;
使用DoEvents防止Excel假死。
示例(简化):
Dim data() As VariantReDim data(1 To 10000, 1 To 9)' 解析后写入data数组' ...Range("A2").Resize(10000, 9).Value = data
这种方式能把性能提升一个数量级,但仍然无法和Python相比。
六、如何选择你的技术方案?
结合多年一线经验,我给你一个简洁的决策参考:
✅ 日志量 > 10万行 / 需要长期自动化:选Python;
✅ 只需临时查看几千行日志 / 无法安装Python:选VBA;
✅ 需要后续做统计分析、可视化:必选Python;
✅ 报表需要直接发给不懂代码的同事:Python解析后生成Excel,兼顾双方体验。
七、课后练习:5道选择题(附答案)
为了巩固今天的内容,准备了5道选择题,涵盖正则、性能对比和工程实践。
Nginx combined日志中,$time_local字段的典型格式是:
A. 2025-12-23 14:27:11
B. 23/Dec/2025:14:27:11 +0800
C. Dec 23 14:27:11 CST 2025
D. 20251223142711
Python正则中,命名分组的正确语法是:
A. (?<name>...)
B. (?P<name>...)
C. (name:...)
D. {name:...}
在VBA中使用正则表达式,需要引用的库是:
A. Microsoft Scripting Runtime
B. Microsoft VBScript Regular Expressions 5.5
C. Microsoft ActiveX Data Objects
D. Microsoft XML v6.0
针对百万行级别的Nginx日志解析,以下哪种方式性能最好?
A. VBA逐行读取并写入单元格
B. VBA读取到数组后批量写入
C. Python流式读取 + pandas向量化处理
D. Excel Power Query直接导入
在Python中,将Nginx时间字符串转换为标准datetime对象,最适合的函数是:
A. datetime.now()
B. time.sleep()
C. pd.to_datetime()
D. str.replace()
参考答案:
B
B
B
C
C